第91问 除了 OpenCV,还应该了解哪些商业或开源视觉开发库(例如 HALCON、VisionPro、MIL 和 AForge.NET)?
在实验室里,读取一张图片、调用几个滤波函数就能得到结果;到了生产线,视觉程序还要接收相机触发,完成标定和测量,把检测结果送给控制系统,并在异常发生后留下可追溯的记录。本题讨论的视觉开发库,范围是围绕这条完整链路组织起来的软件平台和算法组件。读者需要同时考虑任务能力、设备接口、调试方式、运行稳定性、授权模式和长期维护责任,才能理解 HALCON、VisionPro、MIL、OpenCV 及其他开源项目为什么会形成不同的工程位置。
视觉库的分类与适用边界
图像处理库通常把图像视作像素数据。程序员读取像素数组,调用滤波、边缘、形态学或几何变换函数,再自行决定如何采集图像、如何标定、如何把像素结果换成物理尺寸,以及如何把检测结论送给 PLC(可编程逻辑控制器,Programmable Logic Controller)。这类库的优点是自由度高,基础算法容易组合;它的前提是使用者愿意自己承担系统拼装工作。
视觉开发库的组织方式更接近一套面向机器视觉任务的工具箱。它通常把图像采集、预处理、几何校正、特征提取、检测与识别、测量、通信输出和结果追溯放在相互关联的工作流中。标定、形状匹配、OCR(光学字符识别,Optical Character Recognition)、三维处理、缺陷检测和部署接口,往往都有成套的算子、样例和调试环境。这里的开发库不意味着所有环节都由一个软件包完成,但它至少提供了面向工程任务的抽象,使工程师可以围绕检测对象、精度和验收方法组织程序。
可以用一个现场例子区分两者。假设相机拍摄一个带有装配孔的金属件。通用库可以提供灰度化、边缘提取、轮廓拟合和模板匹配;工程师仍要处理相机驱动、曝光变化、工件旋转、孔的实际坐标、测量标定、超时、通信失败和异常样本。工业视觉库往往把其中一部分做成更高层的流程或工具,允许工程师在交互环境中检查 ROI(感兴趣区域,Region of Interest)、匹配分数、坐标变换和测量结果,再将稳定流程部署到运行节点。
库的差异还体现在设备兼容性、算法默认语义、调试器、文档、版本维护、运行时稳定性和技术支持上。一个算法在离线图片上能执行,只能说明计算步骤可以完成;生产系统还要回答相机断连时如何报警、输入尺寸变化时如何处理、结果是否带时间戳、软件升级后标定是否仍然有效等问题。选型时把这些问题纳入同一张约束表,才能避免把可调用的函数误认为完整设备交付能力。
完整链路中的每一步都有自己的输入和输出。采集阶段产生带有帧号和时间戳的图像,预处理阶段改变灰度、尺寸或坐标系,特征和检测阶段输出候选区域、分数或几何量,通信阶段把这些结果转换成设备信号。只要其中一个接口的坐标原点、数据类型或异常码没有定义,算法结果就可能在传到下游时失去意义。视觉开发库的工程价值,正是在这些环节之间提供较一致的对象、参数和调试方式;通用库则把更多决定权留给应用程序。
学生常把算法正确性和系统正确性看成同一件事。一个轮廓函数在固定图片上返回了边界,尚未说明相机的曝光是否稳定,也未说明工件移动后边界是否仍然对应同一物理特征。现场验证要把图像、坐标、判定和输出信号串起来检查,必要时保存原始帧和中间结果,才能定位是采集、标定、算法还是通信环节引入了偏差。
工业现场常见的商业平台包括 HALCON、VisionPro 和 Matrox Imaging Library(MIL)。HALCON 是 MVTec 的工业视觉软件平台,覆盖二维、三维、匹配、测量、深度学习和工业接口等多个方向。它适合复杂检测、精密测量,以及一个项目中同时包含多种视觉任务的场景。它的工程价值不只在于算法范围宽,还在于不同任务可以在相对一致的开发和调试环境中衔接起来。
VisionPro 属于 Cognex 的机器视觉软件生态,常见于条码读取、定位、装配确认和标准化工业检测。它的图形化配置和工厂部署经验,对需要快速交付的团队有吸引力。这种优势更容易在重复性高、设备型号相对固定、客户已有 Cognex 体系的项目中体现;如果项目需要大量自定义计算或跨供应商设备,仍要单独评估接口和扩展方式。
MIL 与 Matrox 的图像采集硬件联系较紧,适合高性能采集、视频流处理和需要专用采集板支持的系统。采集卡、驱动、图像缓冲、触发和处理流水线之间的配合,会直接影响吞吐和确定性。对于这类项目,单独比较某个边缘算子或模板匹配函数的速度意义有限,硬件路径、缓冲策略和驱动支持才是系统性能的一部分。
商业平台通常把开发环境、设备接口、样例工程、版本维护、部署许可和技术支持放在同一套交付体系中。对停机代价高、节拍要求严、客户验收责任清晰的项目,这种打包能力可以减少团队自行补齐基础设施的工作。付费不会自动保证算法结果合格,供应商支持也不能替代现场样本、成像条件和验收指标;它改变的是系统完整性由谁提供,以及问题出现时由谁参与解决。
商业平台之间也不应只按品牌比较。HALCON 的覆盖面适合混合任务,VisionPro 更容易融入 Cognex 设备和标准化流程,MIL 在采集硬件和视频流路径上更有针对性。项目要先判断瓶颈是算法开发、设备接入、实时传输还是售后责任,再看哪种平台能减少该环节的风险。若系统只需要一个简单的固定阈值,而团队已有稳定的采集框架,购买完整平台的额外能力可能并不能带来相应收益。
OpenCV(Open Source Computer Vision,开源计算机视觉库)仍是最常见的基础。它提供跨平台的图像处理、几何、特征、视频和部分机器学习能力,适合构建从实验脚本到定制服务的基础组件。它的开源属性降低了使用和分发门槛,也使工程师能直接检查接口和实现细节,但设备适配、异常处理、版本锁定和现场诊断通常需要项目团队自行建设。
Dlib 在检测、度量学习和部分传统视觉任务中具有代表性,也适合学习一个质量较高的 C++ 视觉库如何组织数据结构、模型和算法接口。scikit-image 面向科学图像处理和研究教学,算法表达清晰,适合验证图像处理思路。Open3D 面向点云和三维数据,适合三维重建、点云处理和几何分析。它们解决的问题不同,不能因为都能处理图像或几何数据,就把它们当作同一层次的替代品。
深度学习项目还会使用 Detectron2、MMDetection 和 Ultralytics YOLO(You Only Look Once,实时目标检测方法)等项目。它们更接近任务框架:提供数据格式、训练流程、网络配置、评估和推理接口;OpenCV、Dlib 或 scikit-image 则更像基础算法库。实际系统可以同时使用多层组件,例如用 OpenCV 接收和校正图像,用 Open3D 处理点云,用 PyTorch 训练模型,再把结果交给 C++ 服务完成通信。理解组件所处的层次,比记忆项目名称更有用。
开源生态对学习者的价值还在于可观察性。工程师可以看到数据如何进入函数、参数如何影响结果、异常如何传递,并根据项目需要组合不同模块。代价也很具体:相机驱动不兼容时没有统一责任方,某个版本升级破坏 ABI(应用二进制接口,Application Binary Interface)时需要团队定位,长期运行的内存泄漏和日志缺失也不会因为库是免费的就自行消失。开源减少的是许可门槛,不会消除工程工作量。
选型、分工与总拥有成本
选型应从任务和系统约束开始。先写清相机型号和接口、图像尺寸、触发方式、最小缺陷、节拍、可接受的误检漏检、目标操作系统、部署节点数量以及客户的维护责任,再把候选库放进这些条件中比较。这样可以避免把某库在公开示例中的表现直接推导成它适合当前产品。
若项目强调快速验证、预算有限、算法需要高度定制,而且团队有能力自行维护采集和部署,开源路线通常更灵活。若项目强调量产交付、客户验收、设备兼容、停机损失和售后响应,商业平台提供的工具链和支持可能更有价值。二者的差别在于系统完整性的成本由谁承担:商业库把更多能力预先封装进软件和服务,开源库把更大的组合自由度留给团队,同时也把补齐工作的责任留给团队。
候选库进入正式决策前,应使用目标产线自己的样本做概念验证(POC,Proof of Concept)。样本量可以先取 30 至 100 张,覆盖正常品、最小缺陷、最暗和最亮的光照、容易混入的背景、姿态偏差及现场已知失败样本。每条路线使用同一批输入、同一验收规则和同一台或同等级设备,记录算法结果、调参次数、单帧时间、内存、异常恢复和开发耗时。商业库通常需要申请限时评估许可;开源路线也应为试验安排真实工程日,不能把没有授权费当成试用成本为零。
评估表应把离线算法结果与系统交付结果分开记录。前者回答代表性图像是否达到检测指标,后者还要记录相机连接、标定、软件安装、升级、日志和故障恢复。一个库在算法评分上略低,但能稳定处理设备重启,可能比算法分数更高、却需要团队自行维护大量边缘情况的方案更适合量产。反过来,若任务高度定制,商业库的封装边界阻碍了必要控制,开源方案的额外工程投入也可能合理。
评审结果可以分成三张表。第一张记录成像条件、缺陷形态、精度、节拍和验收方法;第二张记录每个环节由哪个库、哪个设备接口和哪种算法负责;第三张记录授权、版本、支持、备机恢复和预计维护人力。三张表能够互相对应,方案才具备可以交接的边界。项目规模扩大后,还要重新计算许可和支持成本,因为单站点试验中的小差异可能在多站点部署时被放大。
POC 的输出不应只是一张通过或失败的截图。应保留每类样本的数量、误检和漏检、最差单帧时间、连续运行时的异常次数,以及工程师为达到结果所做的参数修改。若商业库和开源路线由不同熟练度的人员实现,还要标记学习时间和可复用代码,避免把个人经验差异误记成库的固有差异。测试结束后,团队应能指出哪些结论已经由样本支持,哪些仍需在真实设备上验证。
当项目包含多个工位时,复用率会改变选型结果。相似工位可以共享采集封装、标定流程和结果协议,开发时间不会严格按工位数线性增长;不同产品的光照、姿态和缺陷形态差异很大时,复用率会降低。许可证则可能按节点、并发数或产品数量增长。TCO 的成本项应结合预计复用率、实际站点数和备用设备数更新,不能把单站点算例机械放大。
图 91-1 把这套判断顺序画成一条从任务到交付的路径。阅读时先看左侧任务约束,再看中间候选路线,末端是两条路线共同面对的实现、部署和维护层。
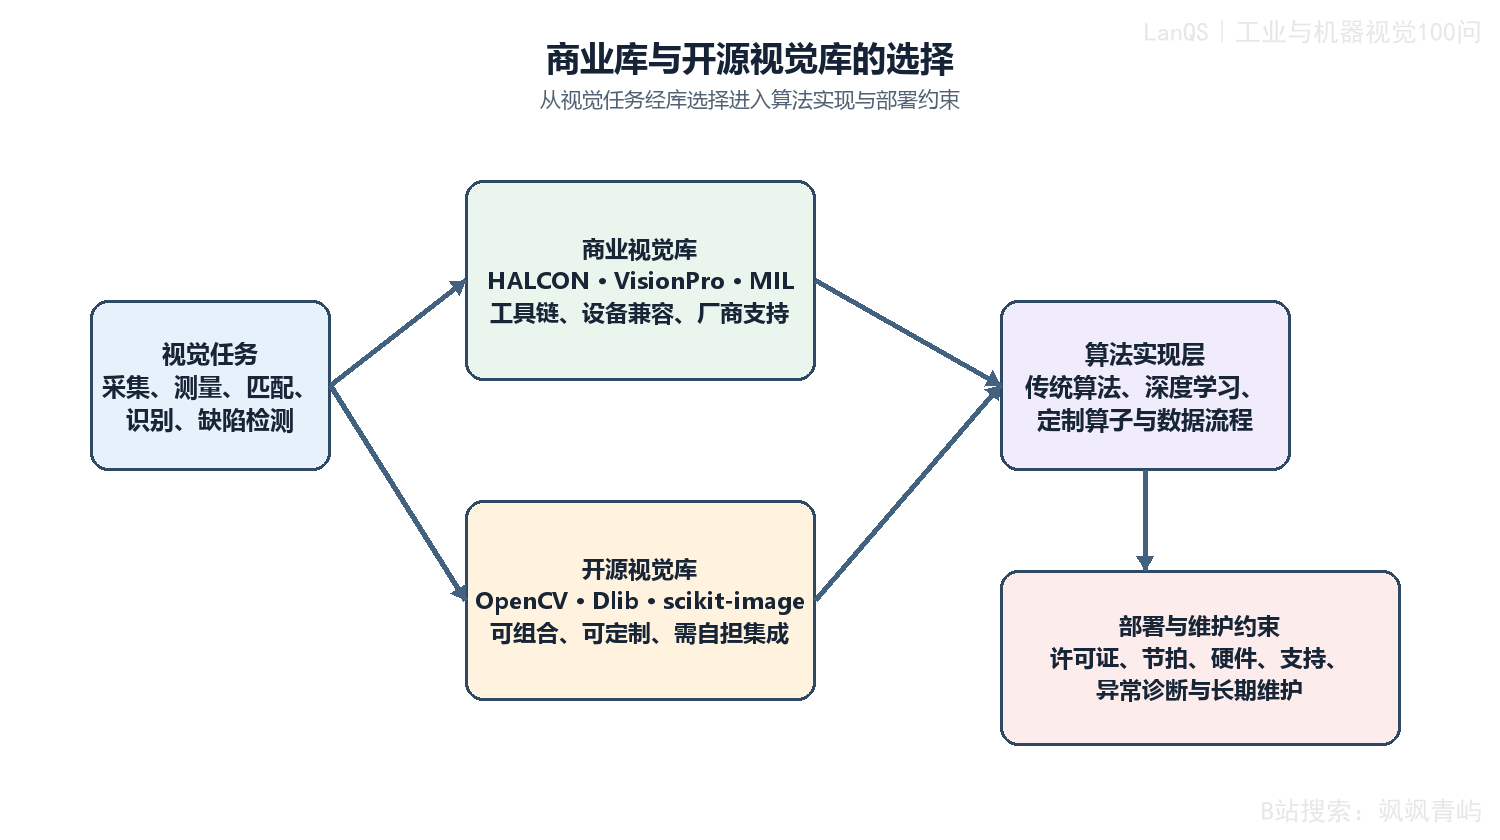
图 91-1 商业库与开源视觉库的选择链
传统视觉库擅长把图像变成可解释的几何和规则结果。阈值分割可以把前景从背景中分离,形态学可以清理小孔和毛刺,标定可以把像素坐标映射到工件坐标,匹配可以给出位置和姿态。深度学习框架擅长用数据学习外观模式,适合纹理变化大、缺陷形态难以用固定规则描述的分类、检测和分割任务。
两者经常出现在同一条流水线上。相机图像先由传统库完成采集、畸变或透视校正、ROI 裁剪和颜色处理,再送入 PyTorch 或 TensorFlow 训练的模型;模型输出的缺陷框、类别或分割区域返回后,系统仍可能使用传统几何和阈值规则完成尺寸判断、坐标换算、协议映射和结果上传。模型负责外观判断,传统工具负责确定的几何关系和设备交互,分工由任务特性决定。
深度学习的加入也不会自动解决成像问题。曝光不足、运动模糊、反光遮挡或标定漂移会降低输入质量,模型可能学到错误的背景线索;此时增加网络层数,往往不能替代光源、镜头和采集时序的改进。传统算法在测量、坐标变换、规则明确的定位和可解释验收方面仍有优势,成熟系统会按任务特性组合工具。
总拥有成本比较算例
开发者很容易只看到商业库的许可费,或只看到开源库的零许可费。更完整的总拥有成本(TCO,Total Cost of Ownership)还包括开发集成、日常支持和维护。下面的模型用任意成本单位 kU(thousand cost units,千成本单位)演示比较方法;这些数值是教学假设,不能视为供应商报价或真实项目实测。
设开发人员每天的成本为 r_d,每年的支持成本按支持天数 d_s 和日成本 r_s 计算,项目周期为 Y 年。三年总成本可写成
其中,L 是许可证和相关授权成本,d_d 是开发天数,r_d 的单位为 kU/天,d_s 是每年支持天数,r_s 的单位同样为 kU/天,Y 为年数。这个式子只把三类成本相加,适用于比较任务和成本口径相同的方案;它没有包含停机损失、培训、硬件和客户延期等更高层风险。
下面的代码把许可证、开发和支持三项分别返回。商业路线在 20 个工位时使用 0.7 的示例批量折扣,开源路线则把更多鲁棒性和现场支持工作放在团队内部。
def tco(license_cost, dev_days, dev_rate,
        support_days_per_year, support_rate, years=3):
    dev_cost = dev_days * dev_rate
    support_cost = support_days_per_year * support_rate * years
    return license_cost, dev_cost, support_cost

commercial_small = tco(8, 15, 0.8, 3, 0.8)
commercial_multi = tco(8 * 20 * 0.7, 25, 0.8, 8, 0.8)
opensource_small = tco(0, 30, 0.8, 6, 0.8)
opensource_multi = tco(0, 55, 0.8, 25, 0.8)
单站点例子中,商业路线的许可证成本为 8 kU,开发成本为 15 × 0.8 = 12 kU,支持成本为 3 × 0.8 × 3 = 7.2 kU,合计 27.2 kU。开源路线没有许可证费,开发成本为 30 × 0.8 = 24 kU,支持成本为 6 × 0.8 × 3 = 14.4 kU,合计 38.4 kU。在这组假设下,省下的许可费不足以抵消额外的开发和支持时间。
20 个工位的例子中,商业路线的许可证成本为 8 × 20 × 0.7 = 112 kU,开发成本为 25 × 0.8 = 20 kU,支持成本为 8 × 0.8 × 3 = 19.2 kU,合计 151.2 kU。开源路线的开发成本为 55 × 0.8 = 44 kU,支持成本为 25 × 0.8 × 3 = 60 kU,合计 104 kU。随着工位数增加,商业许可费成为主要增量;开源路线的内部支持工作也随规模增长,但在这组假设下总额仍较低。
这个算例展示了成本项如何随项目规模变化,以及为什么零许可费不等于没有成本。它不能证明某种路线在所有项目中更便宜,因为日成本、重复利用率、批量折扣、支持条款和任务复杂度都会改变结果。实际评审还要把停机、迁移、客户验收延期和团队学习曲线纳入风险说明。
算例还可以作为敏感性分析的起点。例如,若团队把支持天数从每年 25 天降到 10 天,开源多工位路线的总额会下降;若商业许可没有 0.7 的批量折扣,商业多工位路线的总额会增加。这里的变化用于提醒评审者记录每个假设,并说明结论对哪个假设最敏感。只有把假设和数字分开,后续替换真实报价时才不会误解算例。
图 91-2 使用同一组假设,把四个总额画在一起。阅读时先比较单站点与多工位两组,再观察许可费、开发费和支持费的构成变化。
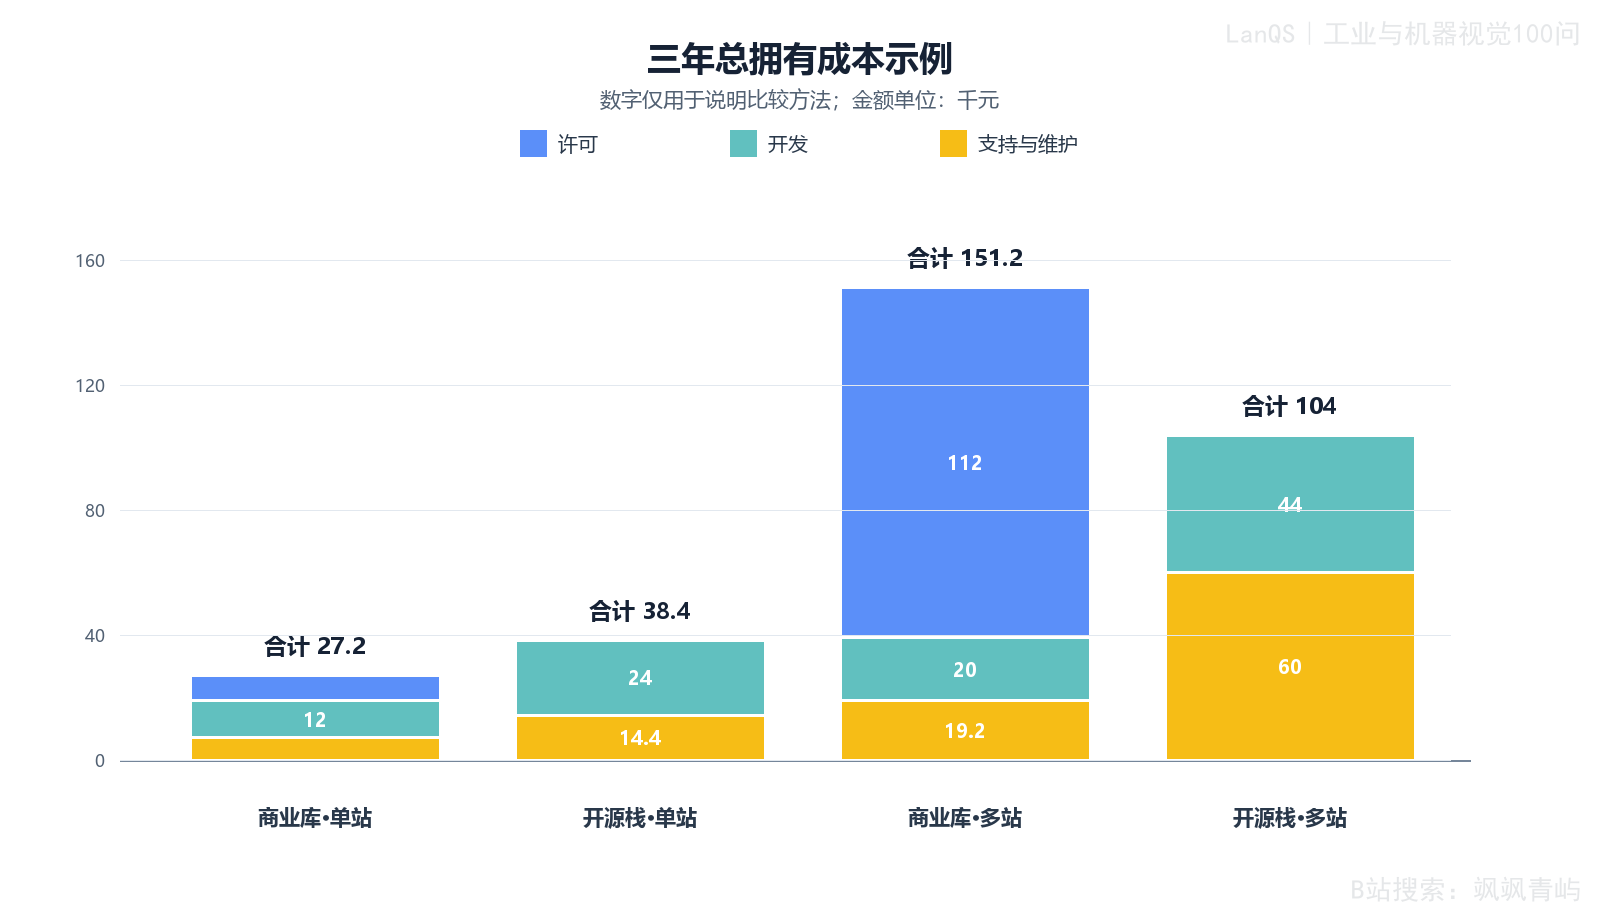
图 91-2 三年总拥有成本的示例比较
如果项目后来发现原库不合适,应比较剩余生命周期成本。迁移时要重新实现标定和检测逻辑,用旧系统的验收样本验证准确率,再培训维护人员,并重新确认客户签字流程。许多系统可以先迁移一个模块或一条低风险产线,以较小范围验证新库的设备适配和长期稳定性,再决定是否整体切换。
常见误区
- 把库的比较做成算子数量比赛。算法覆盖只是入口,设备适配、调试工具、授权和支持同样会决定交付难度。
- 把开源理解成零成本。开发、鲁棒性调优、驱动兼容、异常处理和长期维护仍然需要工程时间。
- 只用供应商演示图像做 POC。产品纹理、反光、缺陷形态和背景变化必须用目标现场的样本验证。
- 购买商业许可时不确认开发节点、运行节点、浮动授权、备机和升级条款。试点可用不代表多工位部署可以直接复制。
- 把深度学习框架当作传统视觉库的替代品。采集、标定、几何处理、测量和通信通常仍由传统工具承担。
- 在生产压力下临时切换库,却没有计算迁移和再验收成本。切换方案应先在低风险范围内做可回归验证。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| HALCON | MVTec 的商业机器视觉开发平台 |
| VisionPro | Cognex 的机器视觉软件平台 |
| MIL | Matrox Imaging Library,Matrox 的图像采集与视觉开发库 |
| OpenCV | Open Source Computer Vision,开源计算机视觉库 |
| OCR | Optical Character Recognition,光学字符识别 |
| ROI | Region of Interest,感兴趣区域 |
| POC | Proof of Concept,概念验证 |
| TCO | Total Cost of Ownership,总拥有成本 |
| 浮动授权 | 由许可服务器管理、可在多个节点间按并发数使用的授权方式 |
| 节点锁定 | 绑定到指定计算机或节点的授权方式 |
| L | 许可证与授权成本,单位为 kU |
| d_d、r_d | 开发天数与开发日成本 |
| d_s、r_s | 每年支持天数与支持日成本 |
| Y | 成本计算周期,本文算例取 3 年 |
延伸阅读
- MVTec HALCON 官方算子与部署文档,了解工业算子、设备接口和授权条款。
- Cognex VisionPro 官方文档,了解其工具链、设备生态和部署方式。
- Matrox Imaging Library 官方文档,了解采集硬件、视频流和图像处理接口。
- Steger、Ulrich、Wiedemann:《Machine Vision Algorithms and Applications》,作为厂商中立的工业视觉算法参考。
- Bradski、Kaehler:《Learning OpenCV》,学习开源视觉基础算法与工程实现。
第92问 HALCON 相比 OpenCV 有什么优势?许可证模式又该怎样理解?
HALCON 与 OpenCV 经常被放在同一张比较表中,但它们面对的读者和交付责任并不相同。HALCON 是面向工业应用的商业视觉平台,OpenCV 是开放、通用、可组合的计算机视觉基础库。工程师在选型时要同时回答四个问题:任务所需的算法能力是什么,设备集成要承担多少工作,开发与运行授权如何落地,以及三年生命周期的成本由谁支付。本问沿着这四个问题展开。
HALCON 与 OpenCV 的能力边界
HALCON 的设计重点是工业交付。它把匹配、测量、OCR、标定、三维、缺陷检测和深度学习等能力放在同一套开发与部署环境中,并提供面向设备、调试和现场维护的工具。OpenCV 更接近通用基础设施,提供大量图像、几何和视频运算,便于跨平台使用、查看实现和与 Python 科学计算生态组合。
这一区别不等于某一个库在所有算法上都更强。学生在实验课或原型阶段,可能更看重源码可读性、零许可费用和算法定制;初级工程师进入量产项目后,则要面对触发、缓冲、标定、异常日志和批量复制。相同的算法调用在这两种环境中的工作量可能完全不同。
可以把差异拆成三个层次:算子层比较“能否完成某个运算”,工作流层比较“采集、标定、测量和调试能否自然衔接”,责任层比较“版本、设备和现场问题由谁负责”。只看第一层,很容易低估工业交付的隐性成本。
HALCON 的工业成熟度体现在算法与工程语义的连贯性。典型流程从采集开始,经过标定和坐标变换,选择 ROI(感兴趣区域,region of interest),再进入匹配、测量、OCR 或缺陷判断,最后把结果交给通信和追溯模块。高层接口往往同时规定对象类型、参数含义、评分和错误路径,样例工程也更接近现场任务。
以形状匹配为例,工程师关注的不是函数名称,而是旋转、缩放、遮挡、光照和背景变化时的行为。较高层的匹配工具可能已经包含多尺度搜索、姿态范围和评分语义;用 OpenCV 的低层函数组合相同流程时,候选生成、搜索策略、阈值标定和失败诊断往往需要自行实现。HALCON 由此节省的时间,集中在鲁棒性和工具链,而不只是少写几行代码。
这项优势有使用边界。良好的照明、稳定的相机触发和合理的容差仍然需要由工程师设计;最新研究模型、自定义算子和特殊训练策略也可能更适合 PyTorch 等开放生态。应在同一组难例上比较误检、漏检、耗时和调试路径,不能从品牌印象推断结果。
工业现场的时间经常消耗在核心算法之外:相机和采集卡驱动是否匹配,触发沿是否正确,帧是否丢失,缓冲区由谁拥有,标定文件是否对应当前镜头,重启后设备能否自动恢复。HALCON 的设备接口、示例和调试环境能够降低其中一部分组合工作;OpenCV 通常需要团队自行组合相机 SDK、线程模型、标定工具和错误处理。
设备兼容还涉及时间语义。相机触发、曝光结束、帧到达、算法开始和结果上传是不同事件。如果 SDK 只解决了“读到图像”,却没有明确时间戳和缓冲区所有权,仍可能发生错帧或重复处理。采购评估应使用实际相机连续触发,观察丢帧、重连、换机和进程重启,而不应只查看支持设备列表。
采购前应要求厂商书面确认以下内容:
- 授权是节点锁定(node-locked)还是浮动授权(floating);
- 开发席位和运行/部署授权是否分开;
- 嵌入式产品、OEM(原始设备制造商)和客户转售的条款是什么;
- 升级与技术支持覆盖多长时间;
- 现场换机、备件机和隔离网络如何激活。
HALCON 集成了检测、分类和分割等常见深度学习流程,适合希望在相同环境中完成数据准备、模型导入、推理和结果集成的团队。对象、参数和调试路径统一时,问题可以沿着同一条链路定位,学习成本也更容易转化为可复用的工程模板。
OpenCV 可以承担前后处理和图像操作,并与 PyTorch、ONNX Runtime 或 TensorRT 配合。对于最新网络结构、自定义算子和研究代码,原生深度学习生态通常更容易跟进;代价是团队需要自行确认模型导出、输入语义、后端版本和设备组合。HALCON 适合缩短工业流程,开放框架适合保持研究自由,两种需求可以在一个系统中分层共存。
许可证、激活与生命周期
常见授权包括永久授权、租赁授权、试用/评估授权和学术授权。名称只说明合同形式,不能直接说明实际部署成本。评估表应把时间、使用对象、设备范围、产品形态和服务内容分别列出。
| 维度 | 需要确认的内容 |
|---|---|
| 时间 | 永久授权是否包含升级?租赁到期后能否继续运行已交付程序? |
| 使用对象 | 授权只允许开发,还是包含运行时和部署? |
| 设备范围 | 按节点、席位、并发用户、加密狗还是产品数量计费? |
| 产品形态 | 客户现场、嵌入式设备、OEM 和备用机是否适用不同条款? |
| 服务 | 技术支持、版本更新、补丁和故障响应是否单独收费? |
开发人员能在工作站上调试,不代表同一授权可以放到生产线每个节点。多工位复制时,应把新增工位、备用机和验收环境都列入报价模型,并保留授权文件、版本和联系人信息。
授权可能通过加密狗、软件绑定、网络许可证服务器或其他激活方式实现。它们都会改变现场维护流程。加密狗损坏时能否快速替换,软件绑定是否受主板和硬盘变化影响,网络许可证是否要求生产线持续访问服务器,隔离网如何完成激活,客户换 PC 后重新授权需要多久,这些问题都应在上线前演练。
许可证恢复时间属于系统可用性。一次停线故障的损失可能高于开发阶段节省的费用,因此测试环境、生产环境和备件机应分别验证授权状态。网络许可证还要确认服务器的冗余、断网时的宽限时间和维护责任。
永久授权不等于永久免费升级。它可能只覆盖购买版本,后续的新操作系统、新相机驱动或新算法需要维护服务。租赁授权也不只是月度价格,还要问清到期后的运行权限、支持窗口、功能范围和数据迁移责任。
工程采购应画出至少三年的生命周期表,包含初始授权、运行节点、升级/维护、备件机、培训和迁移。表格还要标明责任边界:厂商可能负责软件缺陷和技术咨询,客户团队仍要负责照明、触发、业务判定和现场数据。开源社区可能活跃,却未必承诺特定版本的响应时间。
OpenCV 的开放许可证和跨平台生态降低了分发门槛,通常不需要为每个运行节点支付传统意义上的视觉算法许可证。团队可以检查源码、组合其他库,并针对特定任务修改流程。
开放授权把更多责任留给团队。可交付的 OpenCV 方案需要锁定编译器和依赖版本,封装相机适配器,记录每个算子的输入尺寸和坐标系,为关键流程建立离线回归图像,并将模型、配置和程序版本写入结果日志。这样可以把自由组合转化为内部平台,但不会自动获得商业库提供的设备支持。
下面的图把技术路线与商业约束放在同一个决策链中。
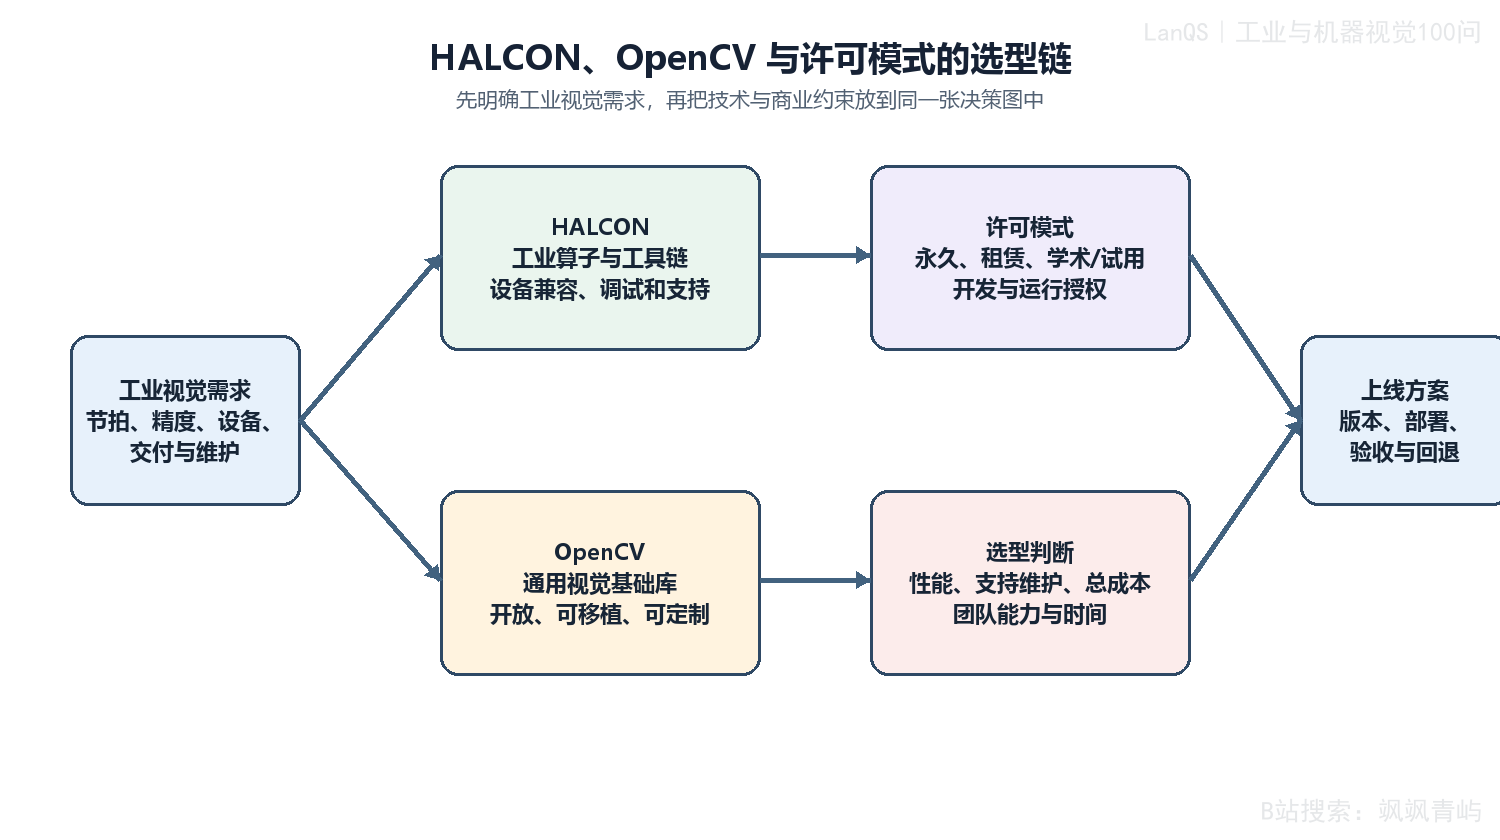
图 92-1 HALCON、OpenCV 与许可模式的选型链
左侧的工业需求同时进入 HALCON、OpenCV 和许可证评估,最后汇合到选型判断与上线方案。许可证模式属于两种算法路线共同面对的商业约束,不是独立的算法分支。读者应把性能、支持维护、总成本、团队能力和上线时间一起带入判断。
开发时间比较算例
为了把“商业库能省时间”变成可以检查的假设,设定一个代表性匹配/斑点任务,并把工作拆为环境与 ROI/标定、核心匹配或斑点逻辑、光照和姿态鲁棒性调优、通信与 I/O 集成、文档与交接五个阶段。以下是一组示例工时:
stages = ["环境与标定", "核心逻辑", "鲁棒性调优",
          "通信与 I/O", "文档与交接"]
halcon_hours = [4, 6, 6, 4, 2]
opencv_hours = [6, 10, 16, 6, 4]
assert len(stages) == len(halcon_hours) == len(opencv_hours)
print(sum(halcon_hours), sum(opencv_hours))  # 22, 42
| 阶段 | HALCON | OpenCV |
|---|---|---|
| 环境与 ROI、标定 | 4 小时 | 6 小时 |
| 核心匹配/斑点逻辑 | 6 小时 | 10 小时 |
| 鲁棒性调优 | 6 小时 | 16 小时 |
| 通信与 I/O 集成 | 4 小时 | 6 小时 |
| 文档与交接 | 2 小时 | 4 小时 |
| 合计 | 22 小时 | 42 小时 |
OpenCV 路线比 HALCON 多 \(42-22=20\) 小时,约为 \(20/22\approx91\%\)。差异主要集中在鲁棒性调优,因为低层组件需要工程师自行搭建多尺度、姿态、光照和失败样本的处理。图 92-2 用堆叠柱显示这五段工作如何累积。
用普通百分数表达,这个差异约为 91%。该百分比只描述这组假设下的开发时间差,不表示任何团队或任何任务都必然存在相同差距。
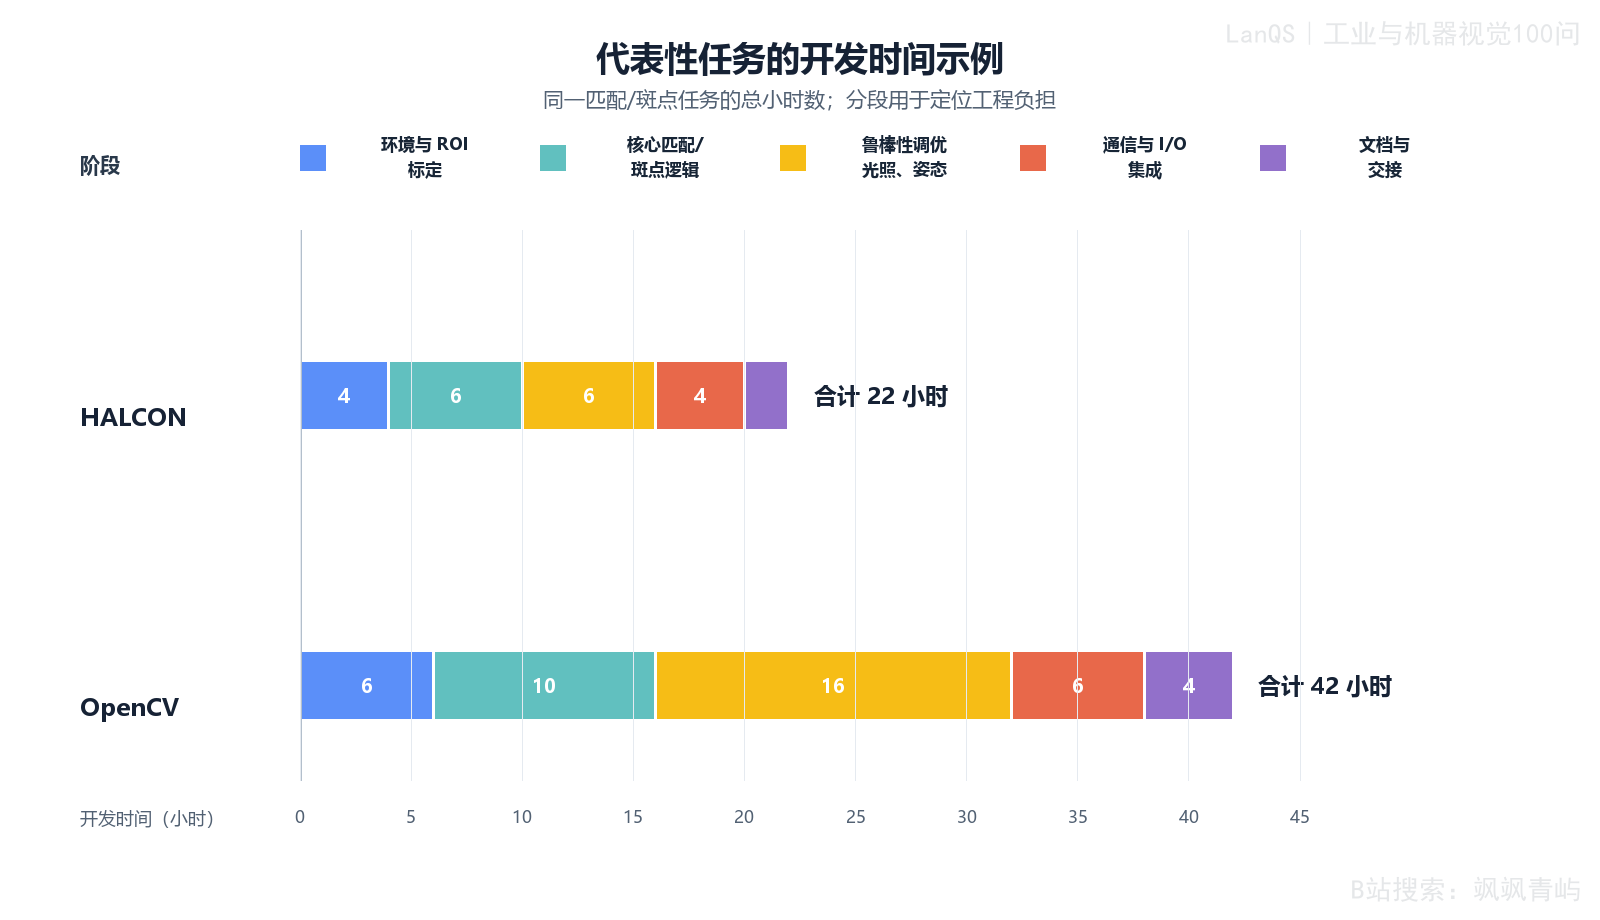
图 92-2 代表性视觉任务的开发时间示例
读图时先比较总高度,再看差异集中在哪一段。示例说明高层工具可能把鲁棒性工作封装进算子,但不能作为任何项目的报价,也不能证明 HALCON 的检测结果必然更准确。团队已有采集适配器和回归测试时,OpenCV 的工时可能下降;目标姿态更复杂时,调优差异又可能扩大。
商业库的生产力收益要和许可证增量放在一起比较。评估多站点项目时,统计所有工位节省的开发、调试和售后时间;再比较节点授权、升级和备件机的费用。团队对 HALCON、C++、Python 和采集 SDK 的熟练度也会改变结果。对于边界清晰的项目,部分迁移往往比整体换库更容易验证,例如保留稳定的采集和测量链,只替换性能瓶颈或定制模型。
选型评审可以安排一次小型现场演练。让两条路线使用同一批正常品和缺陷样本,连续触发实际相机,记录从曝光到结果上传的时间;再拔掉网络、重启进程、更换备用 PC,观察许可证、设备和日志能否恢复。演练用于找出交付责任最容易断开的环节,而不是给方案排一个脱离现场条件的名次。
对于初学者,可以把选型表理解为三张互相连接的表:第一张记录检测任务和成像条件,第二张记录库、设备和算法的实现方式,第三张记录授权、版本、支持和恢复流程。三张表能够对上,项目才具备可验收的边界;任何一张表缺失,后续成本都可能在现场才暴露。
把这三张表用于评审时,还要保持比较条件一致。相同的图像、相同的缺陷定义、相同的输出判定和相同的节拍要求,才能比较两条技术路线的差异;如果一条路线使用了已经调好的采集适配器,另一条路线还在处理相机连接问题,所得时间差就混入了基础设施差异。评审记录中应注明样本数量、失败样本、人工调参次数、开发者经验和测试机器,避免把一次顺利的演示误认为可复制的生产能力。
许可证也应当被当作系统边界的一部分记录。开发机能运行示例,只能说明开发授权和当前环境可用;生产机是否能在无网络条件下启动、备机能否接替、授权失效后是否有明确告警,都属于交付验收内容。对于需要长期运行的设备,最好在项目早期就做一次断网、换机和版本升级演练。演练经常暴露授权文件、安装包、驱动和运维手册之间的断点,而不只是算法问题。
常见误区
误区一:只比较算法数量或一次运行时间。 采集、调试、授权和售后往往决定最终交付周期。
误区二:把许可证报价当成完整成本。 开发、运行、升级、备件机和支持条款可能分别计费。
误区三:混淆节点锁定与浮动授权。 两者对换机、并发和离线部署的影响不同。
误区四:假定永久授权包含终身升级。 版本、补丁和技术支持窗口必须单独确认。
误区五:认为 OpenCV 不能用于工业项目。 它可以成为可靠基础,但产品责任由团队承担得更多。
术语与符号表
| 术语 | 含义 |
|---|---|
| HALCON | MVTec 的商业机器视觉开发平台 |
| OpenCV | 开源、跨平台的计算机视觉基础库 |
| HDevelop | HALCON 配套的交互式开发与调试环境 |
| 形状匹配 | shape-based matching,利用几何形状特征定位目标的方法 |
| 节点锁定 | node-locked,许可证绑定到指定计算机或节点 |
| 浮动授权 | floating license,在许可服务器控制下由不同节点使用 |
| 运行时授权 | runtime/deployment license,使已开发程序在生产节点运行 |
| POC | 概念验证,用代表性样本验证方案可行性 |
延伸阅读
- MVTec HALCON 官方文档:算子参考、设备接口、HDevelop 与部署授权说明。
- OpenCV 官方文档及许可证说明。
- Steger、Ulrich、Wiedemann:《Machine Vision Algorithms and Applications》。
- Bradski、Kaehler:《Learning OpenCV》。
第93问 视觉开发应选 Python 还是 C++?两者在工业部署中的优缺点是什么?
视觉项目通常经历两个节奏不同的阶段:研究阶段需要快速读图、试验算法、分析数据和训练模型,生产阶段则要在固定硬件上持续接收图像、满足节拍、管理资源并处理异常。Python 和 C++ 的差异,正好对应这两种工作节奏。本问先说明两种语言在视觉链路中的角色,再讨论 Python 的运行时边界、C++ 的工程优势和代价,最后用一个延迟算例说明应如何根据热点测量,而不是凭语言印象决定重写。
Python 与 C++ 的优势和代价
视觉程序一端连接数据和算法,另一端连接相机、采集卡、PLC(可编程逻辑控制器,programmable logic controller)和生产节拍。研发人员常常先用脚本验证图像是否包含足够信息,再把稳定算法放进长期运行的服务。若一开始就用生产级语言处理所有试验,迭代会变慢;若把实验脚本原样放进产线,资源、异常和设备控制又可能缺少边界。
语言选择应从任务约束开始:算法是否仍在变化,单帧延迟和尾部延迟是多少,是否需要直接调用硬件 SDK,系统内存是否有限,部署设备是否统一,以及维护人员是否能够长期修改和调试这套代码。语言本身只是实现手段,研发、验证和部署的责任边界才决定架构。
Python 的核心优势是试验速度和生态完整度。NumPy(Numerical Python,数值计算库)提供数组运算,OpenCV-Python 提供图像处理和采集接口,PyTorch、TensorFlow 等框架支持训练与推理,Pandas 和 Jupyter 便于整理样本、记录实验和可视化结果。这些工具可以在同一环境中串起来,工程师修改参数后很快就能看到新结果。
Python 还适合教学和离线分析。数组切片、绘图和数据表的表达方式较短,初学者更容易把注意力放在成像、特征和模型行为上。模型训练完成后,可以通过 ONNX(Open Neural Network Exchange,开放神经网络交换格式)或 TorchScript 将计算图交给其他运行时。
这里必须区分 Python 外层代码和被 Python 调用的执行后端。NumPy 和 OpenCV-Python 的大量数组运算实际在编译后的 C/C++ 实现中完成,Python 主要负责参数组织、流程控制和输入输出。如果热点已经位于这些后端,单纯把外层改成 C++,收益可能很小。
Python 的挑战来自解释器、运行时资源和设备集成。解释执行的逐像素循环通常比数组化操作慢,动态对象和垃圾回收会带来额外开销;依赖环境也需要冻结,否则 Python、NumPy、OpenCV 或深度学习框架的版本变化可能改变结果。长期运行服务还要考虑进程重启、内存增长、异常恢复和日志。
GIL(Global Interpreter Lock,全局解释器锁)是 CPython 中保护 Python 字节码执行的互斥机制。多个线程同时执行 Python 字节码时会受到它的限制;NumPy、OpenCV 等编译后端在解释器之外执行,情况不同。多线程是否有效,要看线程是否把时间花在可释放 GIL 的本地计算上,以及数据拷贝和锁竞争是否已经成为瓶颈。GIL 是运行时因素,不应单独作为语言选型结论。
工程上应先对真实管线做 profiling(性能剖析)。可以用 cProfile 观察函数级累计时间,需要逐行定位时使用 line_profiler;同时记录输入尺寸、线程数、相机格式和目标设备。若 95% 以上的总耗时已在 NumPy 或 OpenCV 的编译后端中,重写 Python 外层很难带来同等比例的收益。逐像素 Python 循环、热点循环中频繁创建对象或受 GIL 影响的字节码执行,才是更有力的重写线索。
C++ 能够提供较直接的内存、线程和资源控制,适合相机采集、缓冲区复用、设备通信和长时间运行的服务。固定类型和编译期检查有助于把一部分接口错误提前暴露;RAII(资源获取即初始化)和智能指针可以把文件、锁、设备句柄等资源的释放绑定到对象生命周期。
当产线需要稳定的低延迟和确定的尾部行为时,C++ 更容易建立有界队列、线程优先级、超时和回退路径。它也便于接入厂商提供的 C/C++ SDK、已有控制系统和高性能推理库。图像数据可以在预先分配的缓冲区中复用,减少频繁分配与复制。
这些优势依赖工程纪律。C++ 的内存越界、悬空指针、数据竞争和异常路径可能造成崩溃或隐蔽错误;编译、链接、跨平台打包和依赖管理也增加了开发成本。C++ 更适合生产约束明确的链路,不代表所有算法研究都应从一开始使用它。
C++ 的编辑—编译—运行周期通常比 Python 更长,模板、构建系统、ABI(应用二进制接口,application binary interface)和第三方依赖也提高了入门门槛。算法仍在频繁变化时,过早重写会造成两套实现不断同步,测试和验证时间可能超过优化收益。
调试方式也不同。Python 常用交互式环境快速检查数组和中间图像,C++ 则需要更明确的类型、生命周期和构建配置。若团队缺少 C++ 经验,短期性能收益可能被维护风险抵消。工程师应把重写对象限定在经过 profiling 确认的热点,保留一套容易验证的参考实现。
混合架构与延迟边界
较常见的结构是 Python 承担研究、训练、离线分析和部分工具链,C++ 承担逐帧推理、设备访问和实时服务。模型可以在 Python 中训练,再通过 ONNX、TorchScript 或其他中间格式交给 C++ 运行时;性能敏感的传统算法则可以写成 C++ 模块,由 Python 通过绑定调用。
混合架构的关键是保持边界稳定。边界应明确张量形状、数据类型、RGB/BGR 通道顺序、归一化、坐标系、时间戳、超时和错误码。完整帧或完整批次跨边界一次,通常比按像素或按中间步骤频繁往返更合理。若采用独立进程、共享内存或消息接口,还要定义队列满、服务重启和版本不匹配时的行为。
下面的流程图用于提出一个实际问题:哪些工作停留在研究侧,哪些工作必须受生产侧的时序和资源约束?
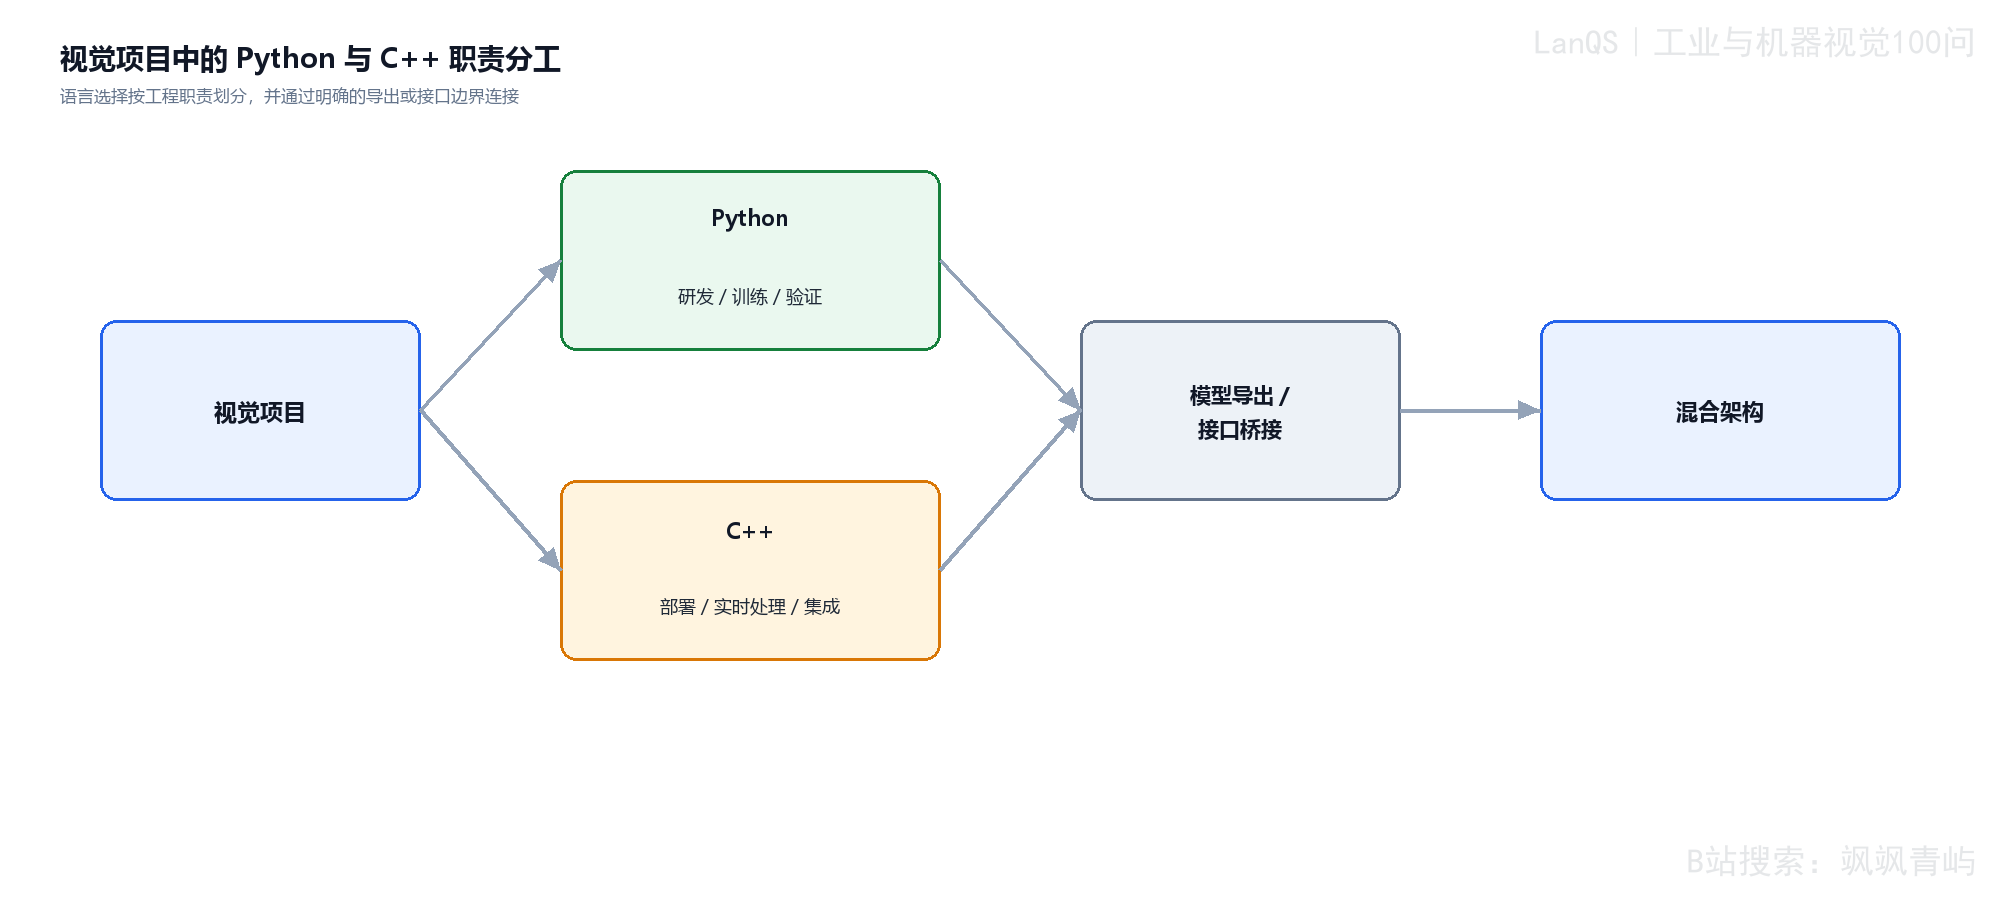
图 93-1 Python 与 C++ 在视觉项目中的职责分工
Python 路径和 C++ 路径分别代表研发迭代与生产控制,模型导出或接口桥接是两者之间的数据边界。读图时应检查边界上是否定义了输入格式、版本和失败处理;两种语言并不需要逐行对应。任务规模小、实时压力低时,单一语言也可能足够,图示结构不能替代实际节拍测试。
延迟分解算例
“Python 很慢”只有在测量对象明确后才有意义。设一幅 1024×1024 的灰度图像依次执行高斯模糊、阈值分割和轮廓计数,比较三种实现方式的每帧时间。以下数值用于解释执行层次,单位为 ms/帧:
implementations = [
    ("纯 Python(嵌套像素循环)", 1850.0),
    ("Python + 编译后端(NumPy / OpenCV-Python)", 8.4),
    ("纯 C++(OpenCV C++ API)", 6.1),
]

for name, t_ms in implementations:
    fps = 1000.0 / t_ms
    print(name, t_ms, "ms/帧", fps, "fps")

print("纯 Python相对Python+后端的减速倍数:", 1850.0 / 8.4)
print("Python+后端相对纯C++的延迟比:", 8.4 / 6.1)
帧率换算使用
其中 \(t_{\mathrm{ms}}\) 是每帧时间,单位为毫秒。纯 Python 实现为 1850.0 ms/帧,约 0.5 fps;Python 调用 NumPy/OpenCV 编译后端后为 8.4 ms/帧,约 119.0 fps;纯 C++ 为 6.1 ms/帧,约 163.9 fps。1850.0/8.4 约为 220,8.4/6.1 约为 1.38。
三组数字说明最大差距发生在逐像素解释执行与编译后端之间。若目标节拍要求 100 fps,8.4 ms 的 Python 后端路径在这个理想算例中已经超过单帧时间预算,6.1 ms 的 C++ 路径只多出有限余量;若还要叠加采集、拷贝、后处理和通信,则必须重新测端到端延迟。算例不能证明所有 Python 与 C++ 程序有固定的 220 倍差距,也不能替代真实相机和目标设备测试。
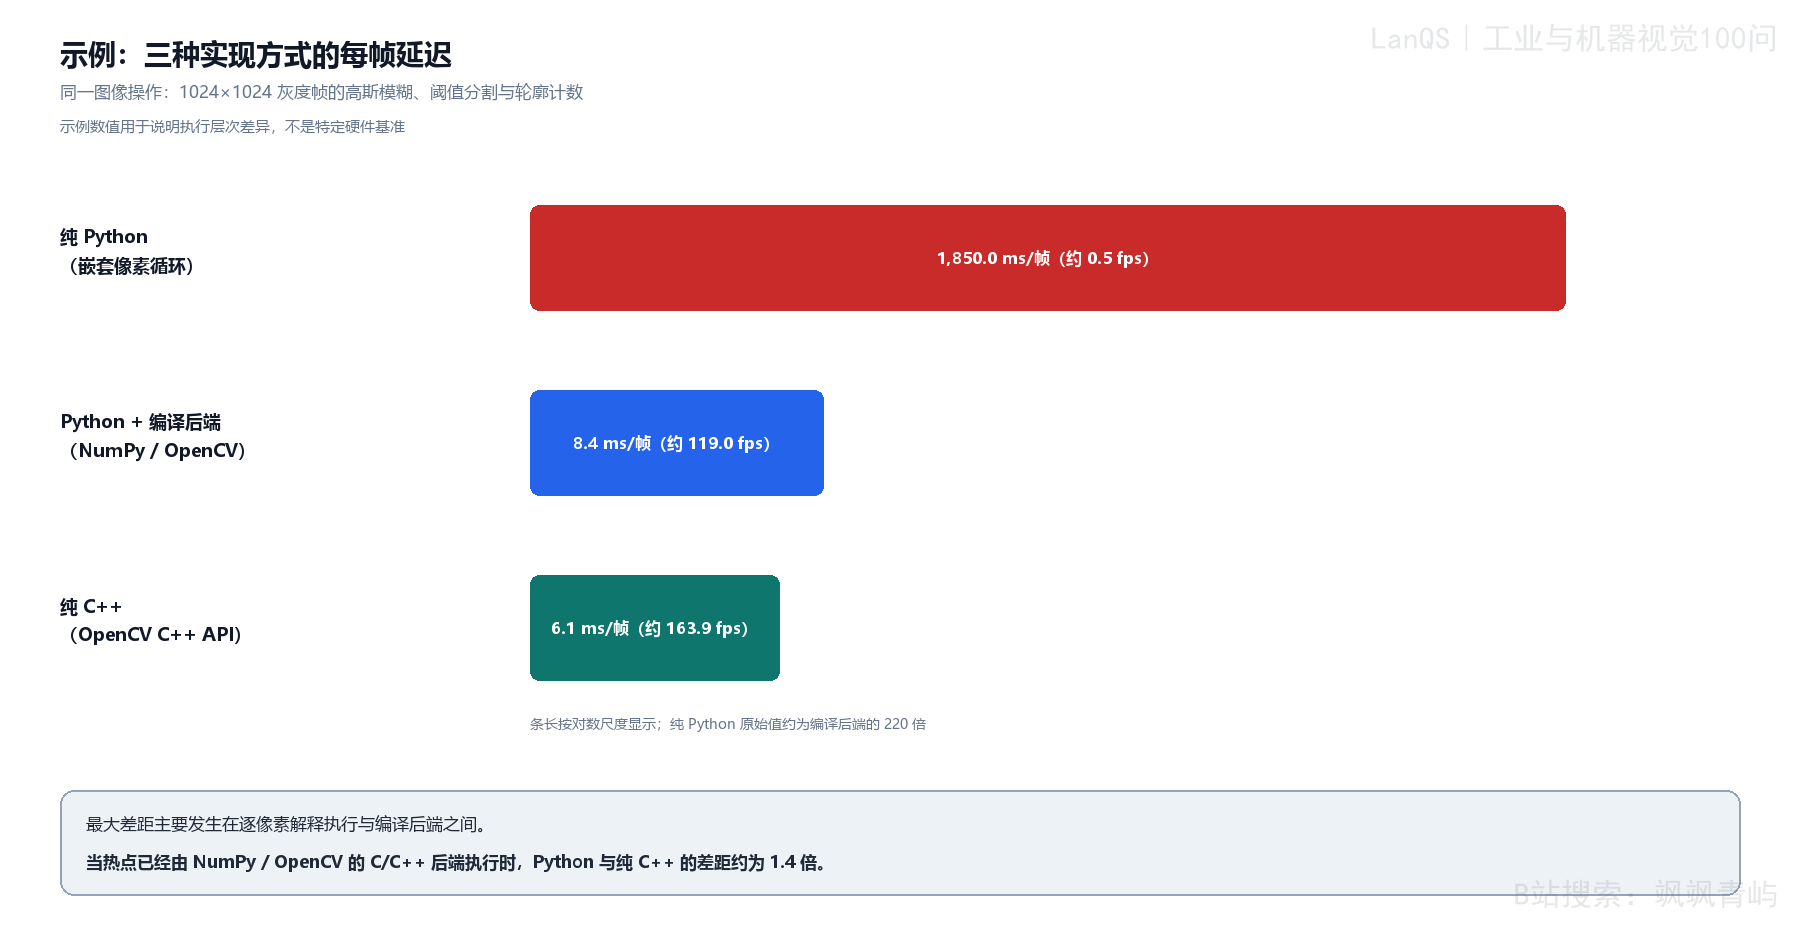
图 93-2 纯 Python、Python 调用编译后端与纯 C++ 的示例每帧延迟
三条横条采用对数尺度,使 1850 ms 与个位数毫秒能够同时显示;条长不能按线性比例读取。1850/8.4/6.1 ms 对应同一图像操作的实现层比较,适合用来定位 Python 层热点;它没有包含整条产线的采集、传输、排队和通信时间。
如果剖析显示热点在 Python 层,优先考虑向量化、批处理、减少对象创建,或只把热点函数移到 C++。如果热点在 NumPy、OpenCV 或推理引擎内部,先检查输入布局、内存复制、线程配置和后端参数,再决定是否迁移。
测量还要留意一次性开销和稳态开销。模型第一次加载可能包含文件读取、内存分配和后端编译,不能与连续运行的单帧时间混为一谈;相机采集和网络传输也可能在某些帧形成长尾。建议分别记录冷启动时间、预热时间、稳态分布、峰值内存和异常恢复时间,并把每次测试的图像尺寸、位深、线程数和设备写入日志。
对于教学和工程交接,Python 参考实现应保留一组固定输入和输出。C++ 模块每次改动都用这组数据回归,先确认结果一致,再比较延迟。这样可以把“重写后更快”拆成两个可回答的问题:结果是否仍然相同,以及节拍收益是否足以覆盖维护成本。
Profiling 的结果还应和系统时间线对应起来。函数报告中的耗时是某段代码的视角,产线关心的却是从触发、采集、拷贝、预处理、推理、后处理到结果上传的完整路径。一个函数即使只占总 CPU 时间的很小比例,也可能处在每帧必经的串行路径上;相反,一个占用较多时间的批处理步骤如果能与采集并行,未必直接决定端到端节拍。因此,优化前后应同时保留函数级报告和端到端时间戳,明确每个时间段的起止点。
跨语言接口也有自己的性能边界。若每个像素、每个候选框都在 Python 与 C++ 之间往返,调用次数、数据封送和内存所有权处理会抵消 C++ 内核的收益。更稳妥的接口通常以整幅图像、一个连续数组或一个批次作为输入,一次完成较大的工作单元,再返回结构化结果。接口设计还要约定数组布局、数据类型、生命周期和异常行为;否则同一段代码在开发机上可运行,换到长期运行的服务后仍可能出现复制、悬空引用或错误吞没。
部署语言的决定也不应在算法尚未稳定时一次性锁死。参考实现需要承担可读性和可验证性,生产实现需要承担资源上限、故障恢复和版本管理。两者可以共享测试样本、模型文件和结果协议,却不必强行共享全部内部代码。只要边界清楚,后续把单个热点替换为 C++ 扩展、独立服务或硬件推理后端,都能沿着同一套回归测试继续推进。
部署选择与接口设计
研究验证、教学、离线分析和内部工具通常更适合快速迭代的 Python;高速产线、资源受限的边缘设备、复杂设备控制或大规模复制项目,需要更严格地评估 C++。判断时应把单帧预算、p95/p99 尾部延迟、硬件资源、设备 SDK、团队能力和维护周期写入同一张约束表。
可采用分阶段路线:先用 Python 建立准确且可复核的参考实现,随后测量真实热点;只有当热点位于 Python 层且影响节拍或资源时,才迁移对应模块。算法仍在变化时,保留 Python 参考版本有助于和 C++ 结果做回归比较。实时链路稳定而上层逻辑仍需调整时,混合架构可以把变化隔离在边界一侧。
ONNX 适合传递模型计算图,TorchScript 和 LibTorch(PyTorch 的 C++ 前端与运行时库)适合保留 PyTorch 语义;pybind11 可为 C++ 函数创建 Python 绑定,适合把完整的性能敏感模块作为一次调用暴露;Cython 可将部分 Python 风格代码转换为可编译扩展,适合明确的小型热点。独立进程、共享内存、本地套接字和消息接口则把两个运行时隔离开,便于分别重启和部署。
桥接技术的选择取决于数据量、实时性、故障隔离和部署方式。绑定适合低延迟调用但要求处理 ABI、内存所有权和异常转换;独立进程隔离性更好,却要支付序列化、进程间通信和队列管理成本。无论选择哪一种方式,接口都应把张量形状、颜色通道、归一化、超时、版本和错误码写成契约。
常见误区
误区一:按语言先进程度做选择。 研发阶段和生产阶段的约束不同,语言应服务于可测量的需求。
误区二:没有 profiling 就重写 C++。 若耗时已在编译后端,外层重写的收益可能有限。
误区三:忽略 GIL 的适用范围。 GIL 约束 Python 字节码线程,不等同于所有 NumPy、OpenCV 或推理后端都不能并行。
误区四:让接口按像素频繁跨越。 数据封送和锁竞争会重新引入解释器与通信开销。
误区五:把 ONNX 或 TorchScript 当成无条件兼容的格式转换。 自定义层、特殊控制流和不常见算子仍需验证。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| GIL | Global Interpreter Lock,全局解释器锁,限制 CPython 多线程同时执行 Python 字节码 |
| profiling | 性能剖析,测量函数、代码行或后端的时间与资源占用 |
| ONNX | Open Neural Network Exchange,开放神经网络交换格式 |
| TorchScript | PyTorch 的可序列化中间表示 |
| LibTorch | PyTorch 的 C++ 前端与运行时库 |
| pybind11 | 用于创建 Python/C++ 绑定的 C++ 库 |
| Cython | 将部分 Python 风格代码转换为可编译扩展的工具 |
| Hot path | 热点路径,程序运行时实际消耗大部分时间的部分 |
| \(t_{\mathrm{ms}}\) | 每帧处理时间,单位为 ms |
| fps | frames per second,帧/秒 |
延伸阅读
- Ramalho:《Fluent Python》。
- Meyers:《Effective Modern C++》。
- ONNX Runtime 官方文档,了解 Python 模型与 C++ 推理运行时的连接方式。
- pybind11 官方文档,了解 Python/C++ 绑定的内存与异常边界。
第94问 如何把 Python 训练的深度学习模型部署到 C++ 生产系统?
Python 训练环境适合反复试验数据、网络和超参数,C++ 生产系统则需要在固定硬件上持续接收相机图像、控制资源、满足节拍并处理异常。模型从训练环境进入产线,涉及的不只是文件格式转换,还包括输入预处理、算子兼容、动态形状、精度变化、后处理、设备 I/O、监控和版本回退。本问先比较几种部署路线,再通过一个数值一致性算例说明模型导出与生产正确性之间的距离。
从训练模型到 C++ 推理
训练程序经常需要读取数据集、分析样本、调整损失函数、查看错误案例和保存中间结果。Python 生态在这些工作上表达效率高,模型研究人员可以迅速改变网络和数据流程。产线服务却面对另一组约束:固定相机输入、确定的单帧预算、有限的 CPU/GPU/内存、PLC 通信、进程重启、日志留存和现场换机。
两个阶段的输入路径也可能不同。训练脚本读入的也许是已经归一化的 RGB 数组,而生产相机输出的是 BGR、不同位深和不同尺寸的图像。若预处理没有作为模型契约固定下来,即便权重文件相同,部署结果也可能变化。生产服务还要规定超时、重试、丢帧、报警和回退,不能只把 Python 的模型调用翻译成一行 C++ API。
第一条路线是导出为 ONNX(Open Neural Network Exchange,开放神经网络交换格式),再交给 ONNX Runtime、TensorRT 或 OpenVINO。ONNX 把训练框架和推理运行时隔开,便于跨平台和回归测试,但需要检查算子、动态形状、输入输出名称、前处理与后处理。
第二条路线是使用 PyTorch 的 TorchScript 和 LibTorch。TorchScript 是可序列化的 PyTorch 中间表示,LibTorch 是 PyTorch 的 C++ 前端与运行时库。这条路线较好地保持 PyTorch 的张量和算子语义,适合已有 PyTorch C++ 经验的团队;代价是运行时体积、依赖、编译配置和硬件中立性需要单独维护。
第三条路线是硬件定向优化。TensorRT 主要面向 NVIDIA GPU,OpenVINO 主要服务 Intel CPU、集成 GPU 及相关加速设备。它们可以做算子融合、低精度推理、内存规划和内核选择,获得更低延迟或更高吞吐;相应的构建、驱动、硬件和算子支持边界也更严格。
路线选择可以分两步。先用一个容易复核的运行时建立正确性基线,再测量目标硬件上的性能收益。这样可以保留问题定位的参照,不会在追求峰值速度时丢失可解释的输出。
ONNX 用模型图、权重和输入输出信息描述网络计算。典型流程是 Python 导出模型,检查图结构和输入输出维度,C++ 使用 ONNX Runtime 会话加载同一个文件并执行。模型文件、导出脚本、算子集版本和参考输入输出应一起保存。
ONNX 适合跨平台部署,也适合把模型转换和生产服务分开管理。它的边界包括自定义层、不常见算子、动态控制流、动态形状和不同版本的算子集。图能够被加载只说明格式可读,仍需检查每个输出的语义、坐标变换、后处理和数值容差。
推理运行时与转换风险
LibTorch 提供 C++ 前端和运行时,允许服务在不依赖 Python 解释器的情况下加载和执行相应的 PyTorch 表示。它对已经使用 PyTorch 的团队较自然,张量、设备和模块语义也比较连续。
部署时需要固定 LibTorch 版本、编译器、运行库和 CUDA 等依赖。运行时体积和依赖管理可能比轻量的推理后端复杂,设备迁移的便利性也不一定达到 ONNX 路线。LibTorch 保留 PyTorch 语义,却不会自动生成面向某个 GPU 的最优执行计划。
TensorRT 面向 NVIDIA GPU,可以融合网络层、选择 GPU 内核、规划显存,并使用 FP16 或 INT8 等精度模式降低计算和存储开销。固定模型、固定输入形状和固定 GPU 的系统,通常更容易从这些优化中获得稳定收益。
TensorRT 的执行计划具有硬件和版本边界。GPU 架构、驱动和 TensorRT 版本变化可能要求重新构建 engine,重建后还要重新做数值一致性和性能验证。若生产设备包含多个 GPU 型号,应该为各硬件配置保留构建记录和回归样本,并准备 ONNX Runtime 等基线或回退路径。
OpenVINO 也属于面向设备的路线,适合 Intel 工业 PC。它需要核对模型转换、算子支持、线程配置、精度模式和目标设备的 p95/p99 延迟。无论使用 TensorRT 还是 OpenVINO,性能结果都必须绑定具体设备和运行时版本。
算子不兼容会造成导出失败、子图拆分或运行时回退。处理时先列出模型算子和目标后端的支持情况,再决定替换网络、注册自定义算子或更换后端。
输入输出语义不一致更为常见。RGB/BGR 通道顺序、归一化范围、数据类型、填充、缩放插值、裁剪顺序和输出解码只要有一项不同,置信度和坐标都可能变化。NCHW 和 NHWC 也必须明确,不能依靠调用者猜测。
动态形状和批处理影响内存规划与延迟稳定性。工业系统常用固定尺寸和固定批大小来换取可预测节拍;若必须支持多种形状,应为每种形状建立回归和性能基线。FP32、FP16 和 INT8 的舍入与量化误差还可能改变阈值附近的判定,量化校准数据必须覆盖实际难例。
服务化部署与一致性验证
生产服务应把模型推理放入完整生命周期:初始化设备和模型,接收带时间戳的帧,执行与训练一致的预处理,完成推理和后处理,再把结果交给 PLC、机器人或上位机。缓冲区所有权、队列长度、超时、丢帧和错误码需要提前定义。
服务还应保留模型哈希、配置版本、输入尺寸、阈值、后端和设备信息。日志要能够关联到输入图像和输出结果,异常时既能报警,也能决定是否重试、切换基线后端或将当前产品标记为未知。摄像头触发到结果上传之间没有明确的超时和回退时,模型精度再高也可能阻塞产线。
下面的流程图把训练模型、导出层、运行时和生产服务放到同一条链路中。
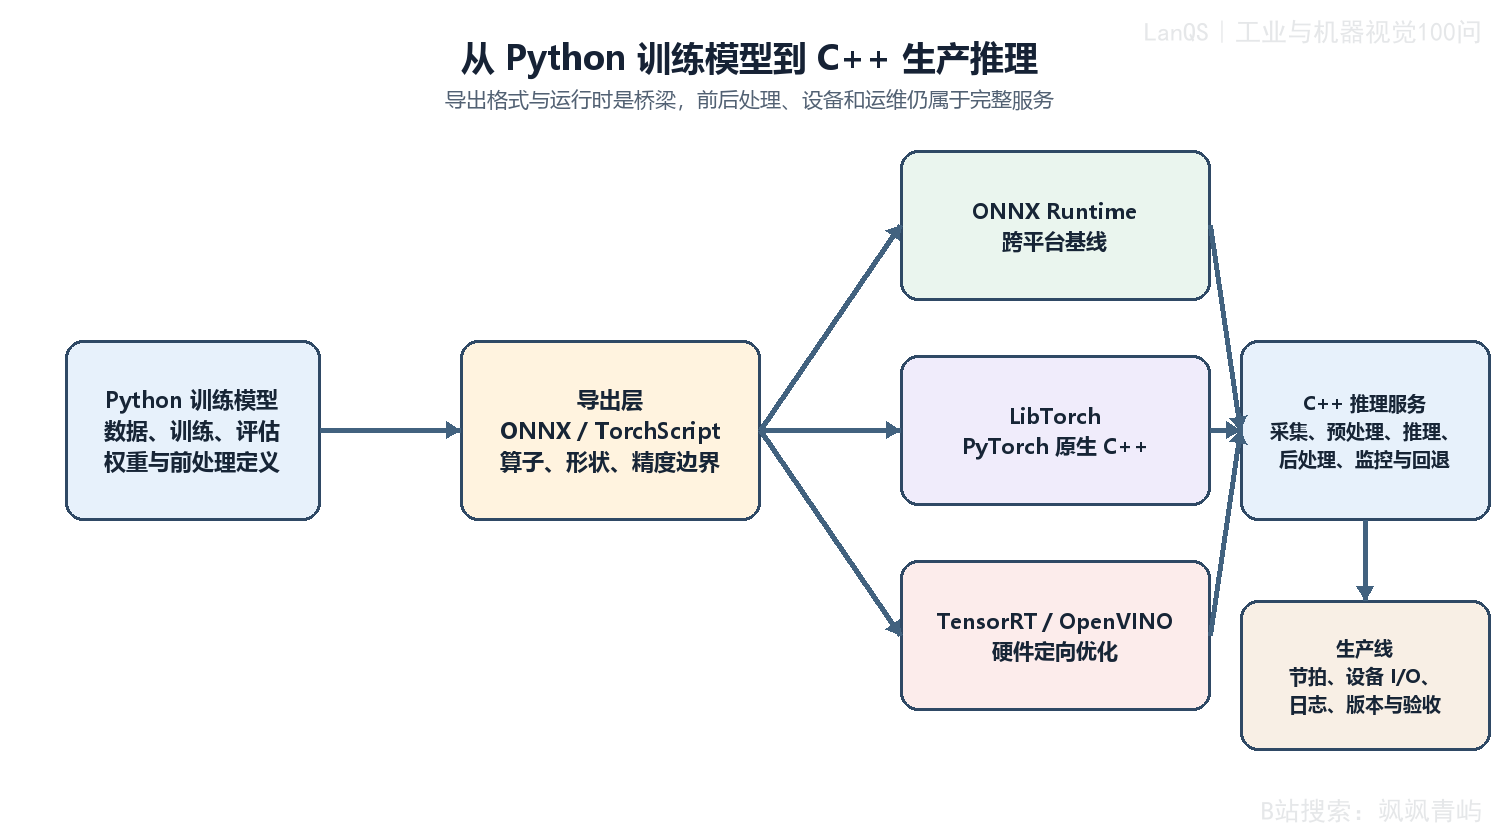
图 94-1 从 Python 训练模型到 C++ 生产推理的流程
Python 模型先经过 ONNX 或 TorchScript 导出,再进入 ONNX Runtime、LibTorch 或 TensorRT/OpenVINO,最后由 C++ 服务承接采集、预处理、推理、后处理、监控和回退。阅读时应把导出层看作数据与责任边界:模型文件、输入输出语义和前后处理必须一起版本化。三条路线的选择取决于算子、硬件和维护要求,图示不表示任何路线可以跳过一致性验证。
模型服务至少要有以下可观察指标:采集帧率和丢帧数、预处理时间、推理 p50/p95/p99、后处理时间、峰值内存、设备温度、错误码和回退次数。若服务使用异步队列,还要记录队列长度和帧等待时间,因为算法本身很快并不代表结果能够及时返回。
在 C++ 中可以把服务生命周期写成一个有限状态流程:启动时检查模型、配置和设备;运行时为每帧分配或复用带时间戳的缓冲区;超时或设备异常时进入降级状态;恢复成功后再回到正常运行。接口还要规定内存由谁拥有、推理调用是否阻塞、结果是否允许乱序返回,以及后处理失败时应返回什么错误码。初级工程师先画出这条状态链,往往比先优化某一个算子更能减少集成错误。
导出结果一致性算例
用一个固定权重的简单线性模型说明检查流程。模型为 Linear(8→16) → ReLU → Linear(16→2),其中 ReLU(修正线性单元,Rectified Linear Unit)是常见的非线性激活函数。输入批次为 N=200,输出共有 200×2=400 个元素。Python 先计算参考输出并导出 ONNX,再用 ONNX Runtime CPU 会话执行;该会话代表 C++ 中的同一运行时路径。
最大绝对差定义为:
同时用下式判断每个元素是否超出容差:
本例取 \(\mathrm{atol}=10^{-4}\)、\(\mathrm{rtol}=10^{-3}\)。可复核的步骤如下:
model = Linear(8, 16, 2)       # 固定权重与偏置
X = fixed_input_batch(200, 8)
y_python = model(X)
export_onnx(model, "model.onnx")
check_onnx("model.onnx")       # 检查节点、名称和形状
y_runtime = onnxruntime_cpu("model.onnx", X)
compare(y_python, y_runtime, atol=1e-4, rtol=1e-3)
前处理一致时,最大绝对差为 0,超出容差的输出为 0/400,检查通过。这能证明给定模型、输入批次和运行时之间的数值相符,不能证明真实相机格式、动态形状、量化、GPU 后端、任务准确率和异常路径已经通过验收。
第二次实验保持模型文件不变,只把 C++ 侧输入改为 \(X'=255X\),模拟忘记归一化。最大绝对差变为 \(1.131\times10^3\),说明仅改变前处理就足以破坏一致性。
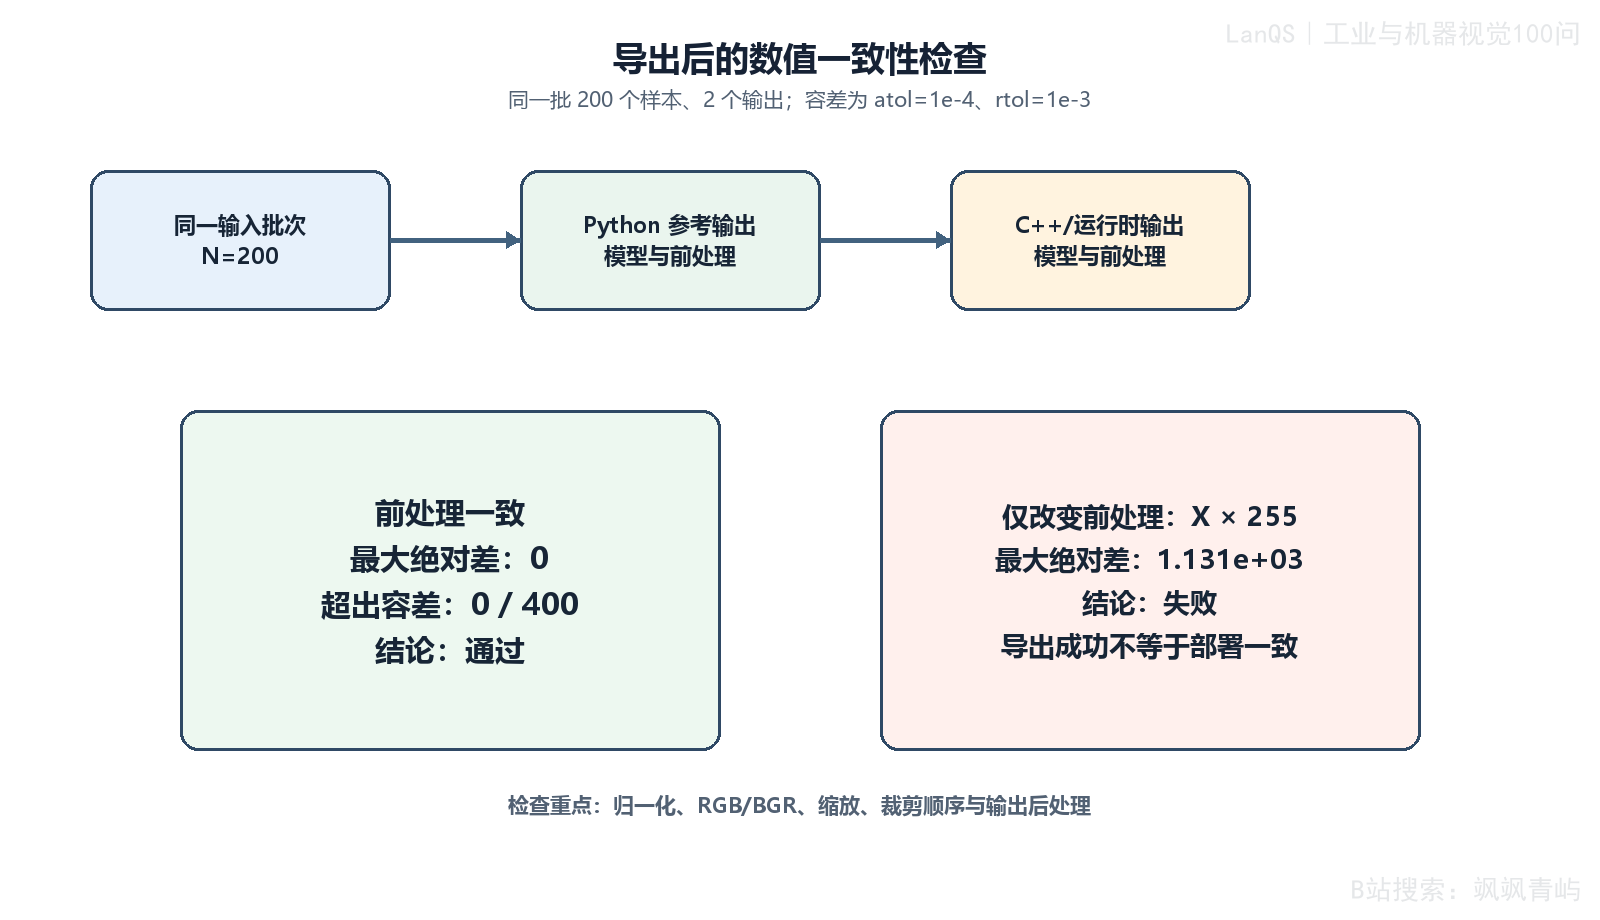
图 94-2 导出模型的数值一致性检查
左侧路径使用相同的 200 个样本和相同前处理,得到 0 差异与 0/400 超差;右侧只把输入缩放为 \(X\times255\),最大绝对差跃升到 \(1.131\times10^3\)。读图时应先检查输入语义,再判断是否需要怀疑导出。该线性模型只是验证方法示例,不能代替目标网络在真实难例上的精度、延迟和资源测试。
实际验证应加入正常样本、最小缺陷、最暗/最亮、边界置信度和异常输入。检测任务要比较框坐标、置信度和 NMS(非极大值抑制)结果,测量任务要比较物理尺寸误差;平均绝对差很小,也不能保证阈值附近的业务判定相同。
模型版本应与导出参数、前处理配置、标签映射、阈值、运行时、驱动和硬件联合管理。发布前保存模型哈希、输入输出样例、算子检查报告和数值对照结果,发布后保留旧版本和回退开关。
后端优化要分阶段进行:先确认 ONNX Runtime 或 LibTorch 基线正确,再评估 TensorRT/OpenVINO 的 FP16、INT8、固定形状和图优化收益。每次改变后端、精度或驱动,都应重新检查难例、任务指标、p50/p95/p99、峰值内存和长时间稳定性。
服务实现中还要把模型计算和设备协作分开看。模型接口可以约定输入张量、输出张量和错误码,采集线程负责获取帧并附带时间戳,推理线程负责调用运行时,结果线程负责阈值判断、记录和通信。这样做的价值在于,模型替换不会悄悄改变相机触发或 PLC 通信的行为。队列长度、丢帧策略和超时处理也必须显式定义:当推理速度暂时低于采集速度时,系统是保留最新帧、等待全部帧,还是触发报警,三种选择对应不同的业务含义。
数值一致性检查最好分成三层。第一层比较固定输入下的逐元素输出,用来发现通道顺序、缩放和算子实现错误;第二层比较真实样本上的置信度、框、分割区域或测量值,用来发现数值微差对业务阈值的影响;第三层比较连续运行时的延迟、内存和异常恢复,用来确认服务行为。三层中任何一层失败,都不能用另一层的通过结果替代。尤其是量化和低精度推理,可能在平均误差不大的情况下改变少数边界样本的判定。
当转换工具报告警告时,应保留完整的导出日志、模型版本和运行时版本,并逐项确认警告是否涉及被执行的节点。若某个自定义算子被拆到 CPU,结果可能仍然正确,但延迟和内存路径已经改变;若某个算子被近似替换,速度提升也可能伴随任务指标下降。部署记录应把这类取舍写清楚,便于现场出现差异时回溯,而不是只保留一个最终模型文件。
常见误区
误区一:导出成功就等于部署完成。 导出只说明格式或图结构可处理,算子、输入语义、后处理和服务异常仍需验证。
误区二:只比较平均推理时间。 产线还关心尾部延迟、冷启动、峰值内存、温度和超时。
误区三:忽略 RGB/BGR、归一化和缩放顺序。 前处理差异是数值不一致的常见原因。
误区四:把动态形状当成没有代价的灵活性。 它可能削弱执行计划和延迟的确定性。
误区五:把 TensorRT engine 当成通用永久文件。 硬件、驱动和运行时变化可能要求重建。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| ONNX | Open Neural Network Exchange,开放神经网络交换格式 |
| ONNX Runtime | 执行 ONNX 模型的跨平台运行时 |
| LibTorch | PyTorch 的 C++ 前端与运行时库 |
| TorchScript | 可序列化的 PyTorch 中间表示 |
| 数值一致性 | 不同实现对同一输入的输出在规定容差内一致 |
| 算子兼容 | 模型算子及其版本、属性能否被目标后端正确执行 |
| 前处理 | 推理前的尺寸、通道、数据类型、归一化和裁剪步骤 |
| \(N\) | 输入批次大小,本例为 200 |
| \(d_{\max}\) | 输出元素的最大绝对差 |
| atol、rtol | 绝对误差和相对误差容差 |
| FP32/FP16/INT8 | 32 位浮点、16 位浮点和 8 位整数精度格式 |
延伸阅读
- ONNX 官方规范与 ONNX Runtime 官方文档。
- PyTorch、TorchScript 与 LibTorch 官方部署文档。
- NVIDIA TensorRT 官方开发者文档。
- Intel OpenVINO 官方文档。
- 项目内部的模型导出、输入语义、数值一致性和回滚测试记录。
第95问 TensorRT、OpenVINO 和 ONNX Runtime 分别是什么?在项目中各自扮演什么角色?
训练模型只是得到了一张计算图和一组权重,生产系统还要把它变成目标设备能够稳定执行的计划。TensorRT、OpenVINO 和 ONNX Runtime 都可以参与这一步,但它们服务的硬件、抽象层次和维护责任不同。理解三者的角色,有助于避免把某个后端的峰值性能误当成所有设备上的固定结论。本问先解释推理引擎的工作,再比较三类工具、评分方法、公平基准和多目标部署架构。
三类推理引擎的角色
推理引擎(inference engine)接收训练完成的模型和输入张量,执行网络计算并输出预测结果。它通常还会在加载或编译阶段进行常量折叠、算子融合、精度选择、内存复用和执行内核选择,目的是减少数据搬运、降低计算量并提高目标硬件利用率。
模型正确性和执行效率是两个层次。模型正确性要求输入语义、权重和输出解释符合训练定义;执行效率则关系到延迟、吞吐、内存、温度和功耗。推理引擎通常不负责相机触发、业务阈值、PLC 通信和日志回滚,这些仍属于完整视觉服务。
引擎输入是张量,产线输入却是带有时间戳、像素格式和设备状态的图像。颜色转换、缩放、归一化、内存拷贝和输出解码都会影响端到端时间。基准测试若只测引擎调用区间,不能直接代表从采集到结果上传的生产延迟。
TensorRT 是 NVIDIA GPU 生态中的推理优化与运行时组件。它可以融合网络层、选择 GPU 内核、规划显存,并使用 FP16 或 INT8 等精度模式降低计算和存储开销。固定模型、固定输入形状和固定 GPU 的系统,通常更容易获得低延迟或高吞吐。
TensorRT 的执行计划有明确的硬件边界。GPU 架构、驱动和 TensorRT 版本变化可能要求重新构建 engine,重建后还要重新做数值一致性和性能验证。多型号 GPU 项目应分别保存构建环境、日志和回归样本。
OpenVINO 是 Intel 的推理工具包,面向 CPU、集成 GPU 和部分 Intel 加速设备。它通过模型转换、计算图优化和目标设备执行,把通用模型映射到 Intel 工业 PC 的计算资源。
OpenVINO 适用于以 Intel CPU 为主、部署规模较大且希望使用统一工具链的场景。CPU 型号、核心数、内存带宽、线程亲和性和前处理方式都会改变实际结果,不能把一台开发机上的延迟直接复制到另一台工业 PC。模型转换、算子支持、精度模式和 p95/p99 延迟都需要实测。
ONNX Runtime 是执行 ONNX 模型的跨平台运行时。它可以使用 CPU 作为独立基线,也可以通过执行提供程序(execution provider,EP)把部分或全部计算交给 CUDA、TensorRT、OpenVINO 等后端。
ONNX Runtime 的价值有两层:一是提供相对统一、容易复核的跨平台参考路径,二是通过 EP 接入硬件加速。EP 可能只接管计算图中的一部分节点,剩余节点仍由 CPU 执行,设备间拷贝也可能抵消加速收益。因此测试时应记录图分区、未被接管的算子和数据拷贝情况。
三类工具没有固定的上下级关系。TensorRT 偏向 NVIDIA GPU 上的峰值性能,OpenVINO 偏向 Intel 设备上的实用部署,ONNX Runtime 偏向跨平台接口、基线和回退。它们都可能使用图优化、量化和内存规划,但目标硬件和维护方式不同。
| 维度 | TensorRT | OpenVINO | ONNX Runtime |
|---|---|---|---|
| 主要目标硬件 | NVIDIA GPU | Intel CPU/GPU 等 | 跨平台 CPU 及多种 EP |
| 优化方式 | 硬件定向的融合、精度和内核规划 | 面向 Intel 设备的图优化与执行 | 统一运行时接口,按 EP 调度 |
| 典型优势 | 固定 NVIDIA 设备上的峰值性能 | Intel 工业 PC 上的实用部署 | 可移植、基线和回退 |
| 主要边界 | GPU 架构、驱动和版本绑定 | 需核对 Intel 后端支持和性能 | 抽象层与分区可能带来额外开销 |
下面的关系图把模型图、后端适配、共同优化和部署收益连接起来。
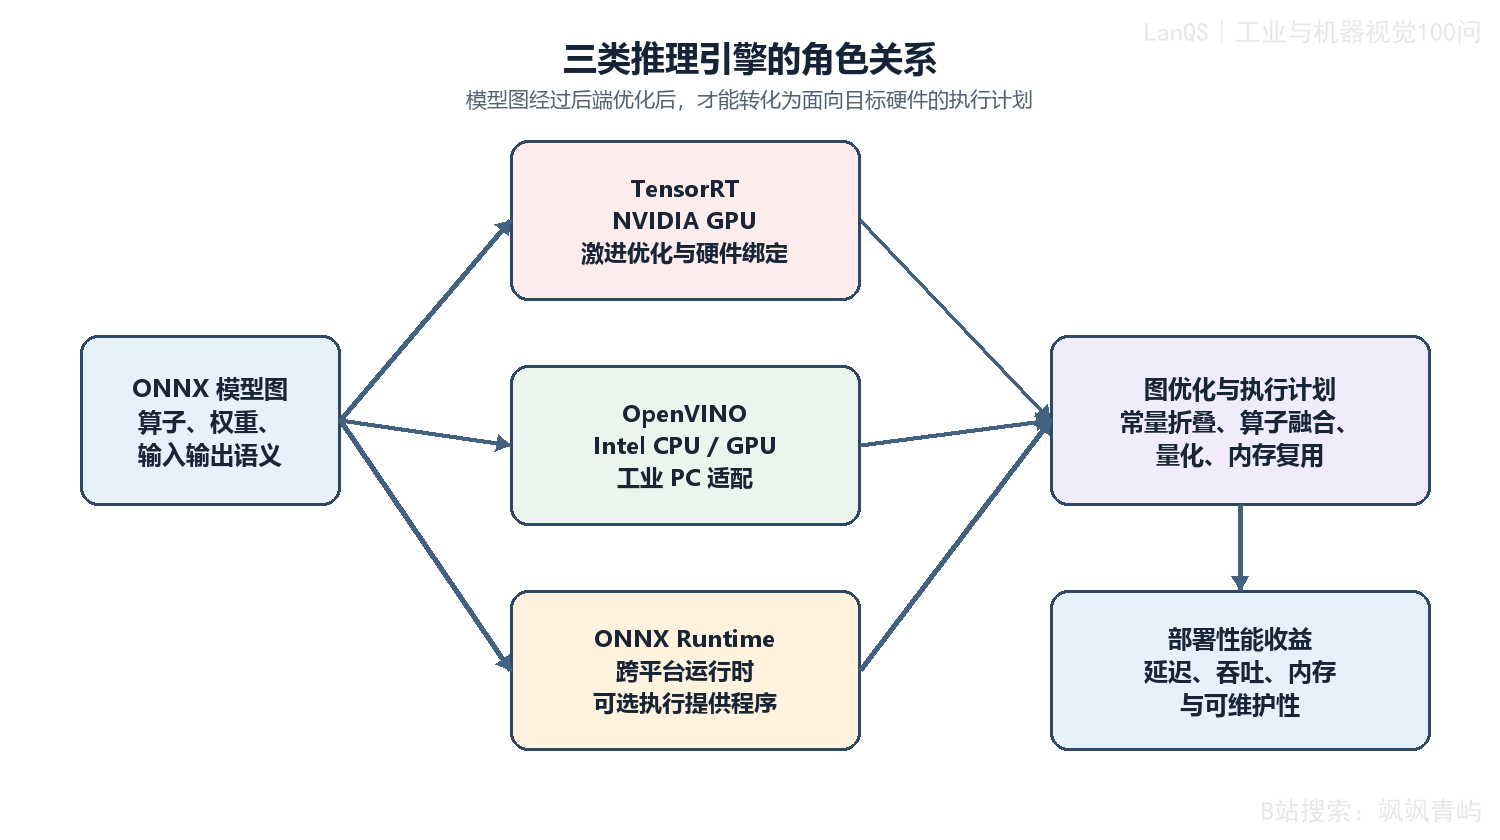
图 95-1 三类推理引擎的角色关系
三条路线都从 ONNX 模型图出发,经后端适配后进入图优化和执行计划,再体现为延迟、吞吐、内存和可维护性方面的变化。读图时应把性能收益理解为目标设备上的实测结果;量化和融合可能降低延迟,也可能带来精度漂移和构建依赖。图示说明角色关系,并不表示三者对所有模型都能互换。
选型、优化与公平验证
选型顺序应从硬件开始。确认 NVIDIA GPU 后,TensorRT 是性能候选;确认 Intel 工业 PC 后,OpenVINO 是性能候选;客户设备跨平台、型号会变化或需要长期回退时,ONNX Runtime 适合作为统一接口和基线。第二步才是比较维护、精度、构建和现场恢复成本。
服务层可以固定加载、推理、元数据读取和错误处理接口,再把每个引擎封装成后端。模型先导出一次 ONNX,记录输入输出语义;每个目标设备构建对应后端;每个后端都做数值一致性和性能回归;后端不可用或 engine 需要重建时,切换到 ONNX Runtime。回退时要同步固定模型版本、精度、阈值、延迟上限和告警行为。
按硬件与目标加权的选型算例
为了把性能和可移植性分开评价,给每个引擎设定 1–5 分的基础评分。每个括号的前一个数是峰值性能 \(P\),后一个数是可移植性 \(T\):
| 场景 | TensorRT | OpenVINO | ONNX Runtime |
|---|---|---|---|
| NVIDIA GPU | (5, 1) | (1, 2) | (3, 5) |
| Intel CPU/iGPU | (1, 1) | (5, 2) | (3, 5) |
| 跨平台要求 | (4, 1) | (4, 1) | (3, 5) |
设性能权重为 \(w_p\),可移植性权重为 \(w_t\),且 \(w_p+w_t=1\),总分为:
性能优先采用 \((w_p,w_t)=(0.8,0.2)\),可移植优先采用 \((0.2,0.8)\)。例如 NVIDIA 场景下,TensorRT 的性能优先分数是 \(0.8\times5+0.2\times1=4.2\);ONNX Runtime 的可移植优先分数是 \(0.2\times3+0.8\times5=4.6\)。
完整计算结果如下:
| 硬件场景 | 权重 | TensorRT | OpenVINO | ONNX Runtime |
|---|---|---|---|---|
| NVIDIA | 性能优先 | 4.2 | 1.2 | 3.4 |
| NVIDIA | 可移植优先 | 1.8 | 1.8 | 4.6 |
| Intel | 性能优先 | 1.0 | 4.4 | 3.4 |
| Intel | 可移植优先 | 1.0 | 2.6 | 4.6 |
| 跨平台 | 性能优先 | 3.4 | 3.4 | 3.4 |
| 跨平台 | 可移植优先 | 1.4 | 1.4 | 4.6 |
这组数据可用以下步骤复核:
def score(engine, w_perf, w_port):
    return (w_perf * engine["peak_perf"]
            + w_port * engine["portability"])

for scenario in scenarios:
    for profile in profiles:
        scores = {name: score(item, profile[0], profile[1])
                  for name, item in scenario.items()}
        print(scenario.name, profile.name, scores)
跨平台场景在性能优先权重下是三者 3.4 分并列;可移植优先时,ONNX Runtime 为 4.6 分。算例说明评分权重如何影响判断,不能替代实际模型和设备的基准测试。
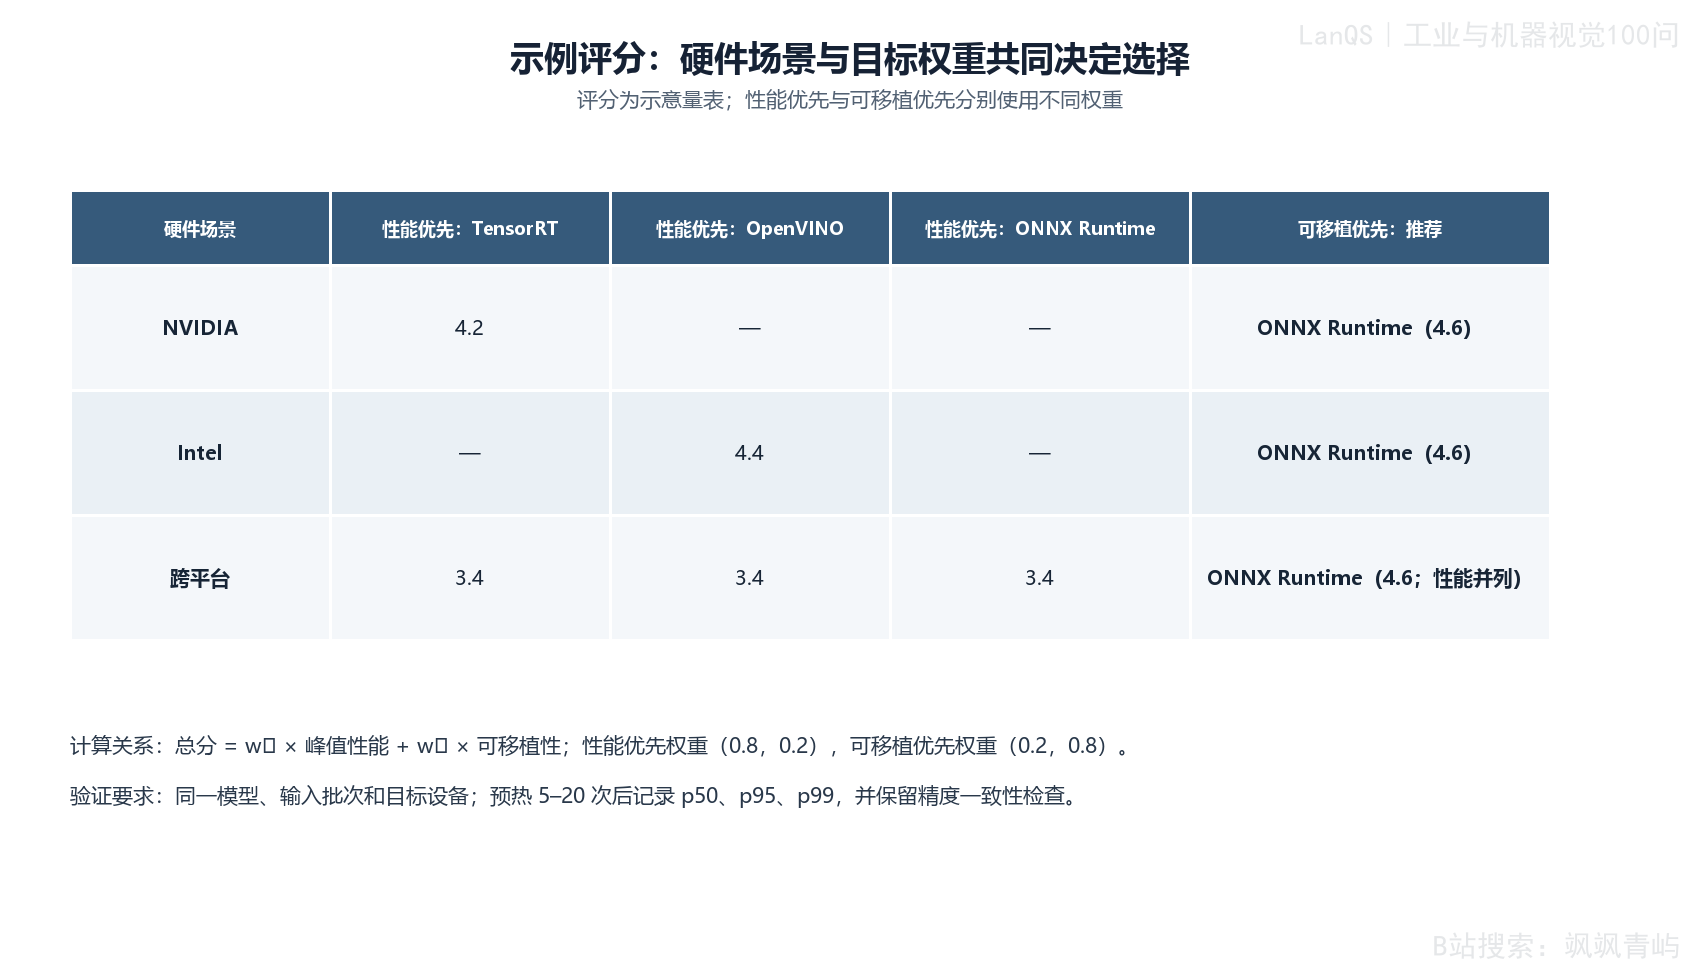
图 95-2 硬件场景与目标权重共同决定选择
图中突出显示 NVIDIA 性能候选 TensorRT、Intel 性能候选 OpenVINO,以及跨平台性能并列和可移植优先的 ONNX Runtime。评分是教学量表,读图时应关注“场景”和“权重”如何共同改变推荐结果,而不要把 4.2、4.4 等数字当成通用实测值。
常量折叠在编译阶段提前计算不变表达式;算子融合减少中间张量和内存往返;低精度量化用 FP16 或 INT8 降低计算与存储开销;内存复用让生命周期不重叠的张量共享缓冲区;执行计划优化则根据目标设备选择内核、线程和数据布局。
这些机制共同减少数据搬运、重复计算并提高硬件利用率,同时会改变数值舍入、调试可见性和构建依赖。每次优化后都要重新检查任务指标、数值误差和长时间稳定性。
基准测试应固定同一模型、输入尺寸、批大小、前后处理和目标设备。先预热 5–20 次并丢弃预热结果,再记录平均延迟、p50、p95、p99、吞吐、峰值内存、温度、错误率和冷启动时间。p95 表示 95% 的测量值不超过该延迟,p99 表示 99% 的测量值不超过该延迟,尾部延迟对工业节拍尤其重要。
每个后端还应使用同一组正常样本、难例和边界置信度样本做数值与任务指标对照。TensorRT engine 与 ONNX Runtime 的输出即使来自同一模型,也应当作两种独立实现验证。硬件、驱动或运行时升级后,必须重新构建或确认兼容性,并保留回退路径。
端到端测试还应把生产状态纳入场景:连续触发、输入队列接近满载、设备温度升高、模型加载失败、后端初始化超时和进程重启。一次成功的离线推理只能说明计算图可执行,不能说明服务在高负载和异常恢复下仍能按时给出结果。若使用异步推理,应同时记录帧等待时间,避免把排队延迟隐藏在吞吐数字之后。
多目标部署时,建议保留一条共享的 ONNX 导出路径和一个薄的运行时选择层。业务代码只调用统一接口,TensorRT 后端服务于确认的 NVIDIA 设备,OpenVINO 后端服务于确认的 Intel 设备,ONNX Runtime 提供跨平台基线和回退。每个后端都要通过同一组数值一致性测试后,才能进入生产配置。
这条路线的维护重点是把“模型接口稳定”和“后端实现可替换”同时落实。统一接口至少应规定输入尺寸或动态形状范围、通道顺序、归一化、输出语义、超时和错误码;后端层再负责会话创建、内存分配、线程配置和设备选择。这样,业务层看到的是一次推理请求,部署层才决定它由 TensorRT、OpenVINO、某个 ONNX Runtime 执行提供程序,还是基线 CPU 路径完成。接口越薄,后端升级时需要重新验证的范围越容易界定。
评分模型的用途是暴露取舍,不是替代测量。若团队把性能权重设得很高,定向引擎可能得到更高分;若项目必须覆盖多种设备,可移植性和回退价值就会改变结论。实际评审还应加入构建时间、驱动维护、授权限制、峰值内存、温度降频和故障恢复等维度。某个引擎在短测中领先,并不等于它在三年生命周期内的总风险最低。
因此,基准报告应同时保存原始测量和解释条件。记录模型哈希、引擎构建参数、设备型号、驱动版本、运行时版本、输入形状、预热次数和采样数量,才能让后续人员复现实验。遇到升级或换机时,先用 ONNX Runtime 或已有后端建立回归基线,再比较新引擎的收益与差异,回退路径也应在同一套测试中演练。
常见误区
误区一:把三类引擎排成固定性能顺序。 结果取决于模型、硬件、版本、精度和输入形状。
误区二:把 ONNX Runtime 当成单一后端。 执行提供程序可能把部分计算交给 CUDA、TensorRT 或 OpenVINO。
误区三:只看平均延迟。 p95/p99、内存、温度、冷启动和错误恢复同样影响产线。
误区四:忽略 TensorRT 的构建绑定。 GPU 架构、驱动和运行时变化可能要求重建 engine。
误区五:把跨平台性能并列写成某一方胜出。 本题算例中三者在性能优先权重下同为 3.4。
误区六:没有基线和回退。 定向优化失败或设备变化时,服务会失去可恢复路径。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| 推理引擎 | 把模型计算图映射为目标设备执行计划的软件组件 |
| 算子融合 | 合并连续计算以减少中间结果和数据搬运 |
| 量化 | 用较低位宽表示权重或激活以降低计算和存储开销 |
| 执行提供程序 | execution provider,ONNX Runtime 接入具体硬件后端的组件 |
| p50/p95/p99 | 延迟分布的 50、95、99 百分位 |
| 硬件锁定 | 优化产物依赖特定设备、驱动或运行时 |
| \(P\)、\(T\) | 峰值性能与可移植性基础评分 |
| \(w_p\)、\(w_t\) | 性能与可移植性权重 |
| \(S\) | 按权重计算的总分 |
延伸阅读
- NVIDIA TensorRT 官方开发者文档。
- Intel OpenVINO 官方文档。
- ONNX Runtime 官方文档及执行提供程序说明。
- ONNX 模型格式与算子集规范。
- 项目内部的目标设备基准、数值一致性、温度和长时间稳定性测试记录。
第96问 在 Jetson、ARM 板卡等边缘设备上部署视觉算法,有哪些特殊考虑?
模块:工业视觉系统部署与边缘计算
边缘部署要同时满足识别精度、处理时延、持续吞吐、功耗、温度、接口带宽和长期稳定性。桌面显卡上的一次推理成功,只能说明模型在某个软件环境中可运行,不能直接推出它能在现场设备上连续工作。本题从硬件约束、模型与推理引擎、数据通路、热管理、可靠性和验证方法六个层面说明部署决策如何落地。
边缘设备的资源约束
在边缘设备上部署视觉算法,至少要回答四个问题:模型是否能在目标设备上执行,单帧处理是否满足节拍,连续运行时资源是否有余量,以及设备出现异常后能否恢复。这里的“资源”不仅包括标称内存,还包括操作系统、采集驱动、显示服务、通信服务、日志、缓存和其他进程已经占用的部分。
云端部署往往可以通过集中式算力、弹性资源和统一运行环境缓解设备差异;边缘部署则必须在现场设备上承担采集、推理、控制和故障恢复。现场网络中断时,核心判定仍应按已定义策略运行或安全停机,不能把云端可用性假设带入边缘验收。
因此,部署验收应以目标设备上的实测数据为准。应记录冷启动、温度稳定、持续高负载三个阶段,并同时记录端到端时延、帧率、内存、功耗、温度、时钟频率、丢帧和异常恢复结果。只测一次空载推理时延,无法覆盖现场的主要风险。
ARM(Advanced RISC Machines)处理器通常具有较好的能效,但与桌面 x86 处理器的指令集、编译选项和库支持不同。算法中使用的算子、第三方库或自定义插件,可能在 x86 上可用,在 ARM 环境中却缺少预编译版本或只能回退到较慢的实现。
许多边缘平台还包含 CPU、GPU、DLA(Deep Learning Accelerator,深度学习加速器)或 NPU(Neural Processing Unit,神经网络处理器)。它们的并行能力、支持算子、可用精度和内存路径不同。把所有算子都放到加速器上通常并不可行:不支持的算子会回退到 CPU,CPU 与加速器之间的数据搬运也可能抵消加速收益。部署前应逐层确认算子支持、张量布局、精度和回退路径。
内存不足可能表现为启动失败、随机崩溃、分配延迟增大或采集队列不断积压。应区分以下几类占用:模型权重和中间张量、相机驱动缓冲、图像队列、预处理临时区、显示与通信缓冲、日志和操作系统占用。若使用多路相机,还要把每路的峰值缓冲叠加,而不能只按单路平均值估算。
持续 I/O 也属于性能约束。图像从相机到应用,再到 CPU、GPU 或 NPU 的每一次格式转换和复制都会消耗带宽与时间。采集分辨率、像素格式、相机帧率和保存策略必须放在同一条数据通路中评估。
边缘设备常在有限功耗下工作。持续推理会提高芯片温度,达到热限制后可能自动降低频率。此时冷机测试得到的时延会失真,系统可能在开机前几分钟满足节拍,运行一段时间后却开始积压或丢帧。
工程上应同时记录温度、功耗模式、核心频率和推理时延,并标明测试持续时间、环境温度、散热方式和外壳状态。若采用风扇或散热器,也要验证堵转、积尘或环境温度上升时的余量。
资源预算与测量口径
边缘设备上的内存监控通常同时存在“总内存、已用内存、可回收缓存、可用内存和进程常驻集”等口径。不同工具的数值不能直接相加。部署记录应固定工具、采样周期和计算口径,例如把模型加载前、模型加载后、相机启动后、队列达到峰值后的数据分开记录。
一个可复核的预算表至少包括以下项目:
| 项目 | 记录方法 | 关注点 |
|---|---|---|
| 模型权重与引擎 | 启动前后差值、引擎构建日志 | 构建阶段和运行阶段可能不同 |
| 中间张量 | 引擎内存报告或峰值采样 | 动态形状可能扩大峰值 |
| 采集缓冲 | SDK/采集卡配置与进程监控 | 多路相机要分别核算 |
| 图像队列 | 队列深度乘单帧占用 | 满队列时还可能产生临时副本 |
| 系统与服务 | 固定系统镜像下的可用内存 | 显示、网络、日志会随负载变化 |
因此,应把“最低可用内存”定义为验收指标,报告还要写清设备的 8 GB、16 GB 或 24 GB 标称值之外实际留下多少空间。若内存峰值接近上限,还要验证分配失败后的报警、释放和重启行为;操作系统的交换分区不能被当成稳定的实时内存。
以 Jetson 级设备为例,可把 tegrastats 与 free、vmstat、进程列表并行记录;在完整应用启动后,包含桌面或显示服务、相机驱动、日志和网络服务时,标称 8 GB 设备的进程可用内存可能只有约 5.5–6.5 GB。这个范围只是用于说明测量口径的示例,不应替代目标设备实测。GPU/DLA 利用率和时钟也要在真实预处理、推理和后处理负载下观察,合成加速器微基准无法代表共享内存总线的实际竞争。
模型、数据通路与实时性
部署优化前要先把“慢”定位到具体环节。一次推理耗时高,通常说明算子或输入尺寸需要检查;推理很快而端到端仍慢,常见原因反而是格式转换、逐像素处理、内存复制、通信或写盘。平均速度足够但现场仍丢帧时,要把注意力移到队列等待和尾部时延;运行一段时间才变慢,则要同时查看温度、时钟、内存曲线和碎片化。下面的表格适合用作现场测量后的归因入口,不能代替分阶段计时。
| 现象 | 主要可能原因 | 优先检查项 |
|---|---|---|
| 推理本身慢 | 算子复杂度高、精度或引擎不合适 | 算子耗时、输入尺寸、FP16/INT8 支持 |
| 预处理或后处理慢 | 格式转换、CPU 逐像素循环、候选框过多 | 各阶段端到端计时、线程占用 |
| 平均速度可以但仍丢帧 | 队列、复制、通信或写盘形成峰值阻塞 | 队列深度、尾部时延、I/O 等待 |
| 运行一段时间后变慢 | 温度升高、内存泄漏或碎片化 | 温度、频率、内存曲线和长稳测试 |
FP16(16-bit floating point,半精度浮点)通常能减少计算和存储开销;INT8(8-bit integer,8 位整数)量化能进一步降低带宽和算力需求,但会引入量化误差。剪枝减少部分连接或通道,知识蒸馏用大模型指导小模型训练。每种优化都必须在代表性缺陷、边界样本和低对比度样本上复核精度,同时检查各类召回率和误报情况。
一个可靠的优化顺序是:先冻结输入尺寸、前处理和后处理定义,再测量各阶段耗时;随后选择支持度最好的推理引擎;最后再尝试精度、结构或内存优化。任何优化都应保留可回退版本,并记录模型、引擎、驱动和编译配置。
现场可以按下面的顺序建立基线,关键是每次只改变一个因素,并把输入和测试窗口固定下来:
固定一批代表性图像和相机输入
分别测量 capture / preprocess / infer / postprocess / output
记录平均值、最大值和高分位值,不只记录一次最小值
检查 CPU、GPU/NPU 利用率、频率、内存和队列深度
只改变一个因素,例如输入尺寸、精度或线程数
比较精度、端到端尾部时延、峰值内存和功耗
保留基线版本,并记录是否发生算子回退
如果推理只占总时间的一小部分,继续压缩模型可能没有明显收益;如果 GPU 利用率不高但 CPU 和内存带宽已经饱和,优先减少颜色转换、内存复制和 Python 逐像素循环;如果平均时间稳定而尾部时间很长,应先排查写盘、网络和调度抖动。每一次优化都应在相同输入和相同温度测试窗口下比较,否则数字没有可比性。
推理引擎决定了算子如何执行、是否融合、使用何种精度以及中间张量如何分配。TensorRT 常用于 NVIDIA 平台的图优化和 GPU 推理;TFLite、ONNX Runtime、OpenVINO 以及厂商 NPU SDK 则可能适合不同的 ARM 或专用加速器环境。选择依据应包括算子覆盖率、动态形状支持、量化校准方法、插件维护成本、线程模型和目标设备上的实测时延。
模型转换不能只检查“导出成功”。应逐项比较转换前后的输入预处理、输出张量形状、类别顺序、阈值、坐标格式和后处理结果。对同一批固定图像,应比较浮点基线、目标引擎输出和最终业务判定;若有差异,要进一步区分精度误差、布局错误和后处理错误。
精度转换尤其需要边界样本。FP16 的误差通常与数值范围和累积运算有关;INT8 还依赖校准数据的分布。校准集应覆盖正常样本、缺陷样本、低照度、反光、污染、最大目标和最小目标。若某一层或某个后处理算子不支持 INT8,需要明确是局部回退、混合精度还是整网回退,并把它写入部署配置。
推理引擎验收可以建立一份固定的逐层检查表:输入张量名称与布局、颜色顺序、归一化公式、动态尺寸、输出张量形状、类别索引、框坐标定义、置信度阈值、非极大值抑制参数和异常输出处理。任何一项未确认,都不能仅凭最终 OK/NG 结果放行,因为某些布局错误可能在简单样本上暂时不显现。
下面的示意图把部署链路中的关键选择放在同一条路径上。阅读时先从左侧的设备约束出发,再看模型与引擎如何落到加速单元,最后检查数据通路和现场验证是否闭环。
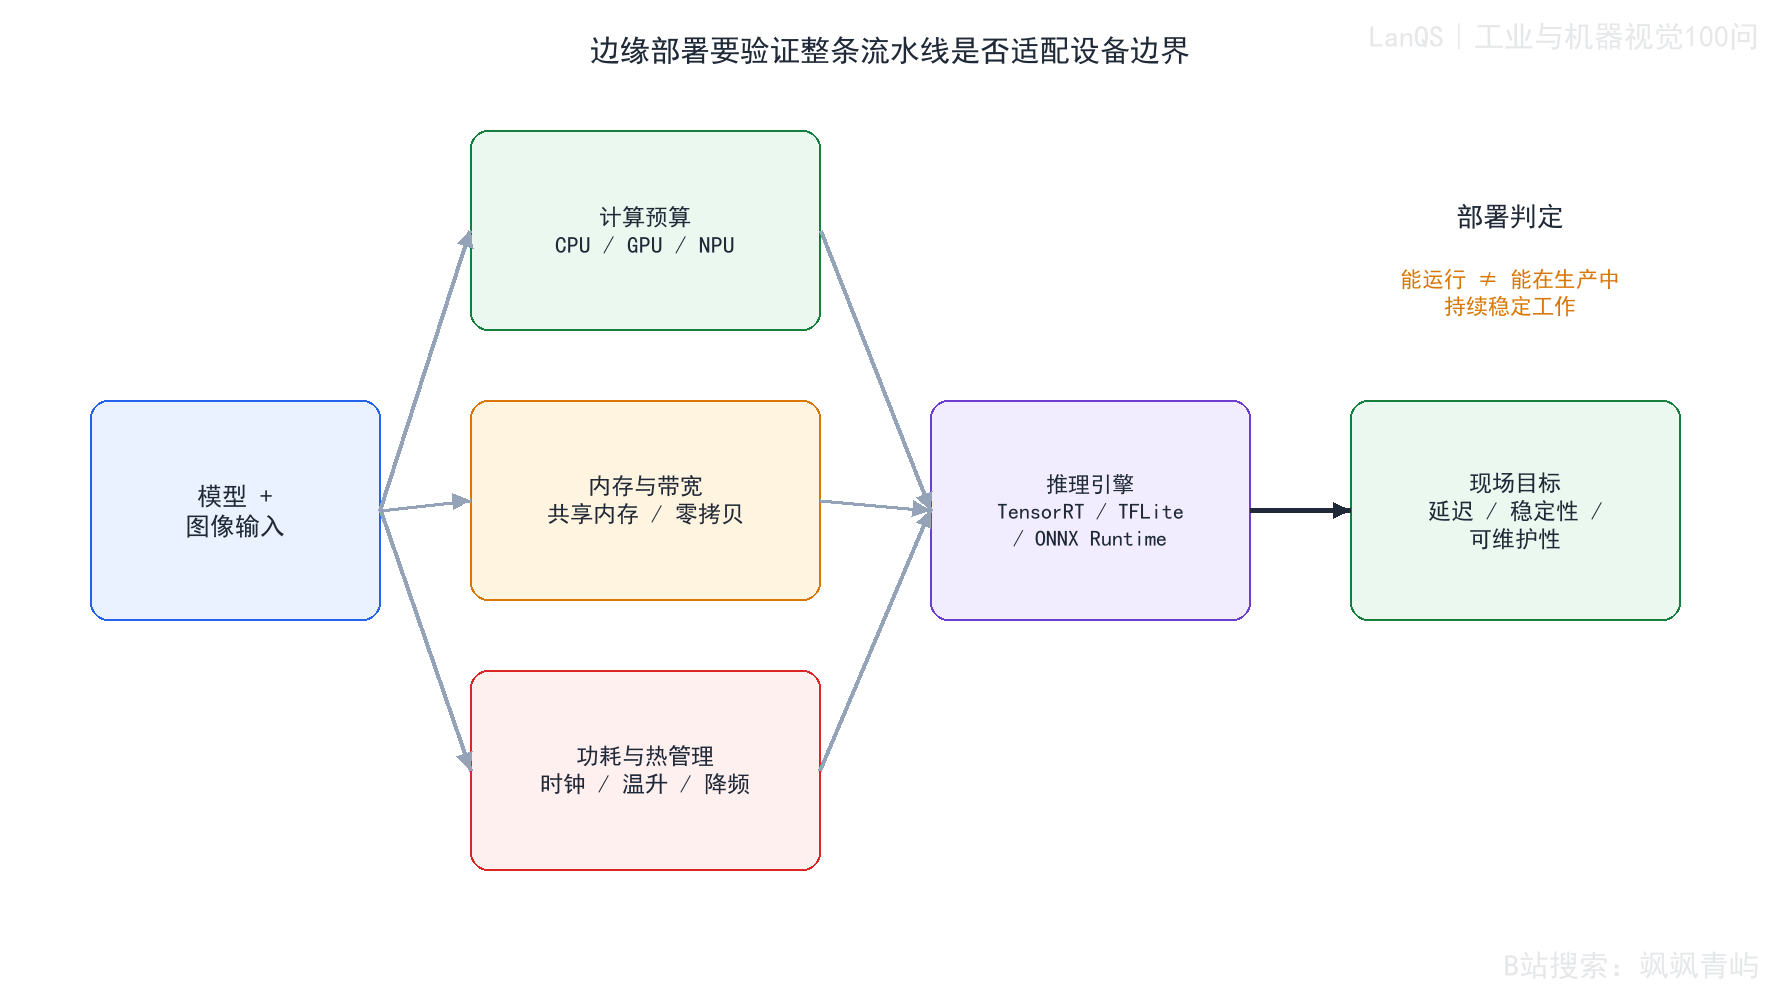
图96-1 边缘视觉部署的决策链路
一帧图像通常要经过“相机采集—驱动缓冲—预处理—推理—后处理—通信或存储”。如果每个阶段都申请新内存并复制整帧,复制时间和内存带宽会随着分辨率、帧率和相机数量增加。应尽量预分配固定大小的缓冲区,明确每个缓冲区的所有权,并在队列中传递引用、索引或句柄。
零拷贝(zero-copy)表示数据在可行条件下由多个阶段共享同一块内存,避免重复复制;统一内存(unified memory)则表示 CPU 与加速器可以访问统一的地址空间。两者都不等于“没有成本”:跨设备访问仍可能受带宽、缓存一致性和访问方向影响,CPU 与 GPU 同时访问还会产生竞争。实际验证时应测量启用和停用相关机制后的端到端时延、峰值内存和稳定性。
队列必须设置容量上限,并明确满队列时的处理策略。实时检测通常需要优先保留最新画面;需要完整追溯时则可能暂停采集、扩大缓冲或降低输入速率。策略选择取决于业务允许的延迟、漏检风险和数据留存要求。
边缘部署至少要经过三个连续的观察窗口。冷启动阶段检查服务依赖、模型加载、驱动初始化和首次推理延迟;温度稳定阶段让设备持续工作到温度、频率和功耗趋于稳定,确认时延是否已经漂移;持续高负载阶段则使用接近现场的帧率、图像尺寸、通信和日志设置,观察内存、队列和丢帧是否随时间增长。三个窗口分别对应初始化风险、热状态风险和长期运行风险,缺少其中一个,测试结论就只覆盖了部分生命周期。
发生异常时,系统应能记录故障上下文、释放或重建设备句柄、清空失效队列,并按照受控顺序重启采集、推理和通信服务。恢复后还要验证结果序号连续性、模型版本一致性和输出是否重复写入。
热稳定测试应把环境条件写入报告。至少要记录开始温度、最高温度、达到稳定所需时间、稳定后的核心频率、功耗模式、端到端时延和丢帧数。若系统有主动风扇,应分别验证正常转速和风扇异常;若设备安装在密闭电柜内,还应在接近现场的进风温度下重复测试。
建议把测试拆成可定位的阶段:
| 阶段 | 目的 | 通过条件示例 |
|---|---|---|
| 启动 5 分钟内 | 检查初始化和首次推理 | 无未处理异常,首帧结果可关联 |
| 温度趋稳 | 检查降频和延迟漂移 | 时延和频率进入规定范围 |
| 连续高负载 | 检查泄漏、队列增长和存储 | 内存、队列和丢帧不持续增长 |
| 注入断线或服务异常 | 检查恢复路径 | 在规定时间内报警或恢复,数据不误关联 |
表中的通过条件需要按产线要求填写具体阈值。若没有定义最大延迟、最大丢帧和恢复时间,测试结果即使“看起来稳定”也无法用于验收。
资源余量比较算例
下面沿用三个占位设备档位,数值只用于说明比较方法,不代表具体厂商产品的基准性能。
| 设备档位 | 标称内存 | 单帧推理时延 |
|---|---|---|
| Jetson 级边缘设备 | 8 GB | 3.1 ms |
| ARM 工业计算机(带 NPU) | 16 GB | 5.4 ms |
| 桌面 GPU 设备 | 24 GB | 0.9 ms |
若只按标称内存比较,三者分别是 8 GB、16 GB 和 24 GB;若只按单帧推理时延比较,Jetson 级设备相对桌面 GPU 约为
倍,ARM 工业计算机约为
倍。若部署需要的可用内存为 6 GB,Jetson 级设备的标称内存余量只有约 2 GB;这仍未扣除操作系统、采集缓冲和其他服务,不能直接视为可用余量。
更完整的判断应记录“可用内存 = 总内存 − 系统与服务占用 − 当前应用占用”,并在实际输入尺寸、批量、前后处理和日志设置下测量端到端延迟。算例能说明三个档位在标称资源和示例推理时间上的相对差异,但不能证明任何一个档位满足具体产线节拍,也不能替代热稳定、峰值内存和故障恢复测试。
图96-2把资源判断拆成标称值、实测延迟和现场余量三层。使用它时要先确认输入尺寸和精度,再把实验室测得的延迟与现场数据通路对齐,最后检查温度稳定后的可用内存和端到端节拍。
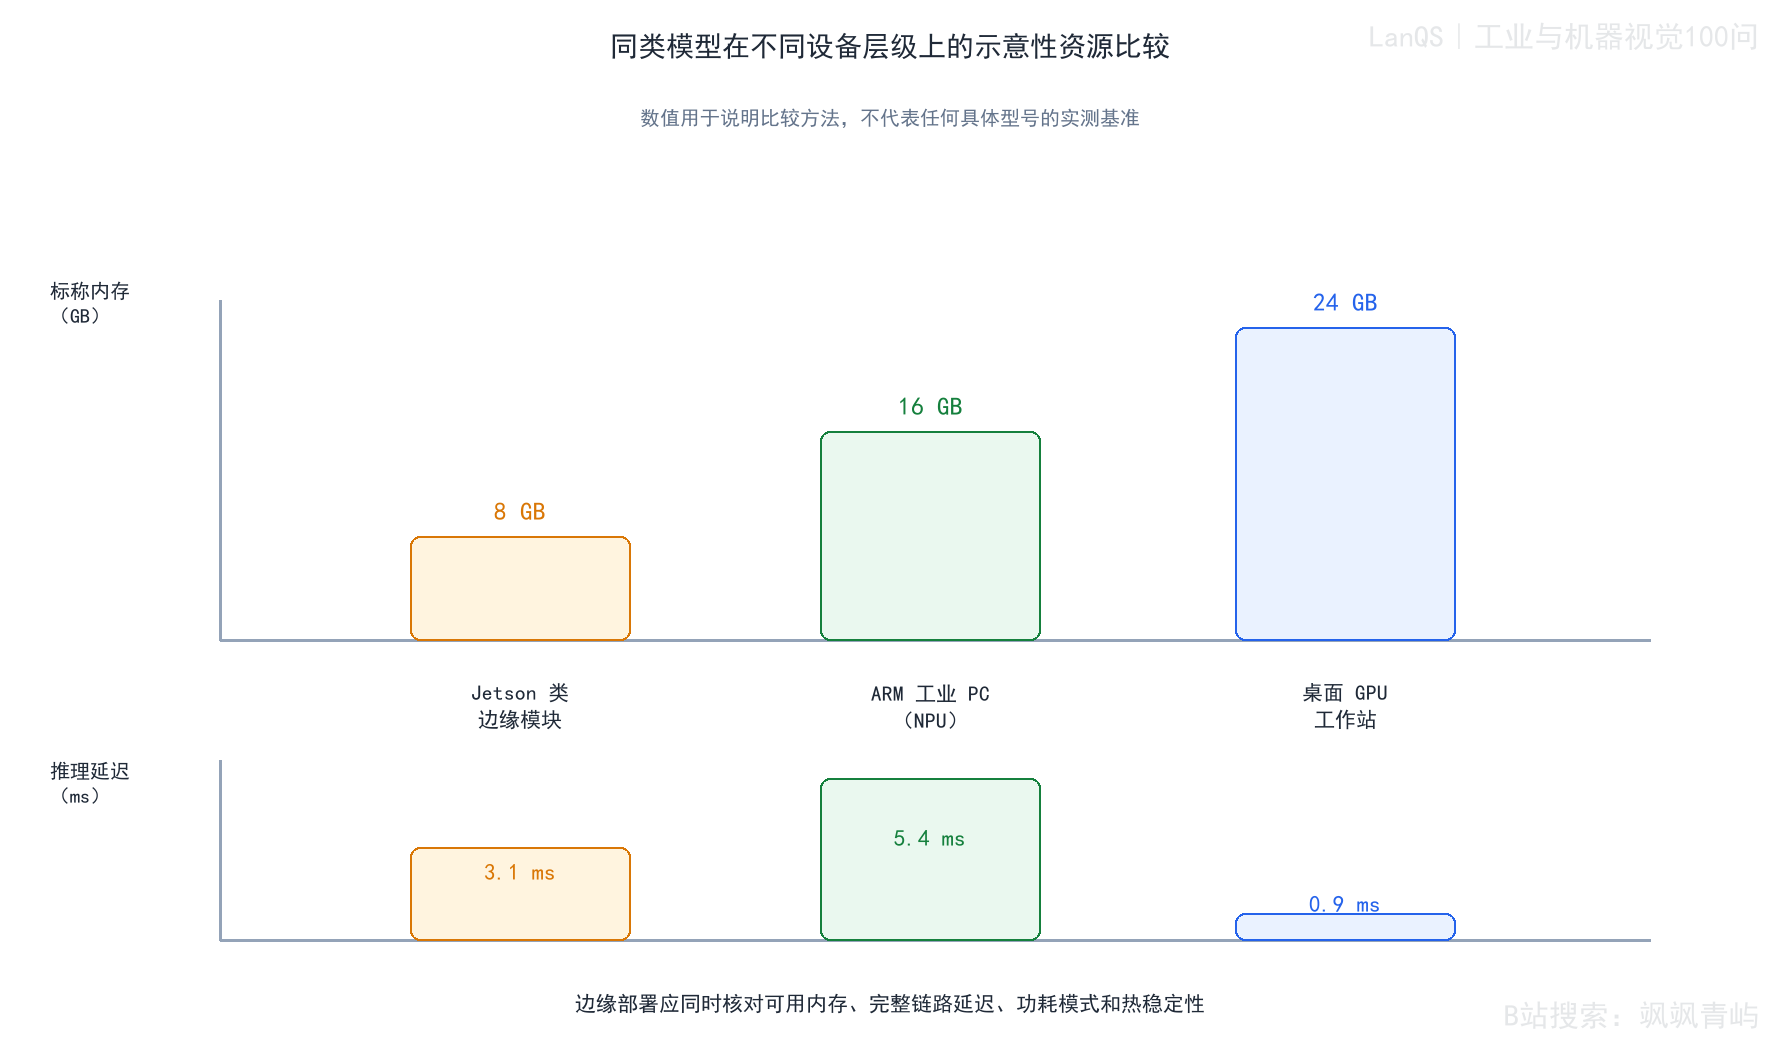
图96-2 从标称资源到现场余量的核查关系
可靠性验证与交付测试
部署验收要把可靠性拆成四个可观测的问题。资源可靠性关注连续运行时内存、队列和线程数是否无界增长;性能可靠性关注温度升高、输入达到峰值或通信短时阻塞时,系统是否仍有可量化余量,或者是否进入已定义的降级状态;数据可靠性要求帧序号、时间戳、模型版本和判定结果能够互相追到,并能识别丢帧、重复帧和无效帧;恢复可靠性则通过相机断开、推理服务异常、磁盘写满和网络中断来验证报警、重连与安全停机。把四类证据分开记录,后续才能区分“算法本身不稳定”和“运行环境已经越过边界”。
模型文件、引擎文件、驱动、运行时库和配置文件应绑定版本,并在启动日志中打印校验值或版本号。升级前后要用固定回归集比较输出,同时复核边界样本和实际节拍。对自动重启也要设置次数上限和人工介入条件,避免故障在现场反复重启而没有留下有效证据。
现场电气条件也属于可靠性范围。应验证瞬时电压扰动、短时断电和恢复后的启动顺序;相机、采集卡、推理服务和控制通信不一定在同一时刻恢复,系统应避免把恢复期间的残缺数据写成正常结果,并在日志中记录重启原因和恢复阶段。
测试应从固定基线开始:先锁定输入分辨率、帧率、像素格式、模型版本和判定阈值,再在目标设备上确认算子、精度和后处理都可执行,并记录任何回退算子。随后分别测量采集、预处理、推理、后处理、通信和写盘耗时,计算端到端的高分位时延,同时采集峰值内存、队列深度、功耗、温度和时钟频率。最后用现场负载完成温度稳定、长时间运行和异常恢复测试,并把设备镜像、模型与引擎版本、配置和原始记录一并固化,形成能够重现的交付包。
常见误区
- 把标称内存当成应用可用内存,忽略系统、驱动和缓冲区占用。
- 只比较 GPU 理论算力或单次推理时间,不测量前处理、后处理、复制和通信。
- 在冷机状态测得时延后直接承诺产线节拍,忽略热降频。
- 转换模型后只检查程序能启动,不比较输入预处理、输出布局和类别顺序。
- 看到“零拷贝”或“统一内存”就认为复制和带宽竞争已经消失。
- 用一次短测试代替峰值负载、长稳运行和断线恢复测试。
术语与符号表
- ARM:一种低功耗处理器指令集架构。
- CPU:中央处理器,负责通用控制和部分预处理、后处理任务。
- GPU:图形处理器,适合大规模并行计算。
- DLA:深度学习加速器,面向部分神经网络算子。
- NPU:神经网络处理器,面向神经网络推理的专用加速单元。
- FP16:16 位半精度浮点格式。
- INT8:8 位整数格式,常用于量化推理。
- ROI:Region of Interest,感兴趣区域,指参与计算或检测的图像区域。
- 零拷贝:在可行条件下让多个阶段共享同一数据缓冲,减少显式复制。
- 统一内存:CPU 与加速器可通过统一地址空间访问的内存机制,实际性能仍受带宽和访问模式限制。
- 端到端时延:从采集到业务结果输出的完整耗时。
延伸阅读
- NVIDIA TensorRT、Jetson 和 DLA 的官方部署文档。
- ONNX Runtime、TFLite、OpenVINO 及目标 NPU SDK 的算子支持与量化文档。
- 目标相机接口的采集驱动、缓冲管理和断线重连文档。
- 工业设备的热设计、功耗管理、长稳测试和软件版本管理规范。
第97问 如何设计多线程或多进程的视觉采集、处理程序?通常需要哪些线程(例如采集线程、处理线程、通信线程)?
模块:工业视觉系统软件架构
视觉系统通常同时面对采集、预处理、推理、结果通信和数据记录等任务。流水线的价值在于明确每个阶段的输入、输出、节拍、队列和停止条件,让相互独立的工作重叠执行。本题先区分吞吐与单帧时延,再说明线程、队列、多相机同步和并发故障的设计边界。
时间模型与线程架构
吞吐量表示单位时间完成的帧数,端到端时延表示一帧从采集到结果输出经历的时间,节拍则是设备允许两次有效结果之间的最大间隔。流水线可以提高吞吐量,却不必然降低单帧时延;队列过长甚至会让系统表面上不丢帧,实际结果却已经滞后。
若相机输入周期为 \(T_{\mathrm{cam}}\),系统希望稳定处理,则长期平均吞吐量应不低于 \(1/T_{\mathrm{cam}}\)。除此之外,还要检查尾部时延和队列深度。平均值达标但第 99 或第 99.9 百分位超时,现场仍可能出现周期性积压。
单线程串行处理时,一帧的处理时间近似为
其中各项分别表示采集等待、预处理、推理、通信和保存耗时,单位通常为毫秒。若 \(T_{\mathrm{serial}}>T_{\mathrm{cam}}\),单线程必然无法长期跟上输入。
流水线稳定后,理想的输出周期接近各阶段中最长的一项:
$$ T_{\mathrm{cycle}}\approx\max(T_{\mathrm{cap}},T_{\mathrm{pre}},T_{\mathrm{inf}},T_{\mathrm{comm}},T_{\mathrm{save}}) $$ 这个估计成立的前提是各阶段可以并行、队列容量足够、资源没有形成新的共享瓶颈,并且不同帧之间不要求严格串行。比如采集每 40 ms 来一帧,预处理和推理合计 90 ms;流水线可以在填满后大约每 40 ms 产出一帧,但第一帧的端到端时延仍可能接近 90 ms 或更高。如果控制动作必须在 40 ms 内针对同一帧完成,单纯提高流水线吞吐不能满足这个硬时限。
典型程序会把采集、预处理、推理、后处理、通信、记录和监控分开考虑。采集线程从相机取图并附加时间戳、序号,负责处理断线和超时;预处理线程完成去畸变、裁剪、缩放、颜色或灰度转换与归一化;推理线程准备模型输入并调用推理引擎;后处理线程解析输出、应用阈值、换算坐标并形成结果。通信线程把结果送往 PLC(Programmable Logic Controller,可编程逻辑控制器)、机器人或 MES(Manufacturing Execution System,制造执行系统),记录线程异步保存图像、结果、统计和报警上下文,监控线程则持续汇总队列深度、阶段耗时、丢帧、异常和线程存活状态。小系统可以合并其中几个阶段,但这些职责和数据边界仍应保留下来。
小系统可以合并阶段,但必须保留清晰的数据边界和停止顺序。把采集、推理和通信全部写在一个循环里,会使任何一个阻塞点拖住整条链路,也会让问题难以定位。
采集、处理与并发安全
阶段之间通常使用线程安全队列传递帧对象。队列容量必须有上限;无界队列能暂时隐藏下游变慢的问题,却会把积压转化为内存增长和越来越大的结果延迟。固定容量的队列应明确满队列策略:阻塞生产者、丢弃旧帧、丢弃新帧或触发降级。
队列元素最好包含图像引用或缓冲句柄、帧序号、硬件时间戳、采集时间、相机编号和配置版本。若数据要跨进程传递,还要明确共享内存、序列化和释放责任,避免一帧在生产者释放后仍被消费者使用。
队列容量可以先按允许的等待时间估算,再用实测峰值校正。若输入帧率为 \(f\),允许队列等待不超过 \(T_q\),则只从等待时间角度看,容量约为 \(\lceil fT_q\rceil\) 帧;还要为线程调度、突发 I/O 和停止过程保留余量。容量过小会频繁触发背压,容量过大则会放大结果陈旧问题。最终应同时验收队列深度和端到端时延。
队列中的图像对象还要区分“拥有数据”和“引用数据”。对象池可以减少频繁分配,但必须在消费者完成后归还;共享内存可以减少跨进程复制,但要有引用计数或租约超时。任何缓冲区被提前复用,都会产生看似随机的错图、错序号和错结果。
下面的结构图展示典型的多阶段流水线。阅读时沿着箭头检查每个队列的容量、满队列动作和停止信号;任一阶段若没有定义超时与退出条件,整条链路就可能在异常时悬挂。
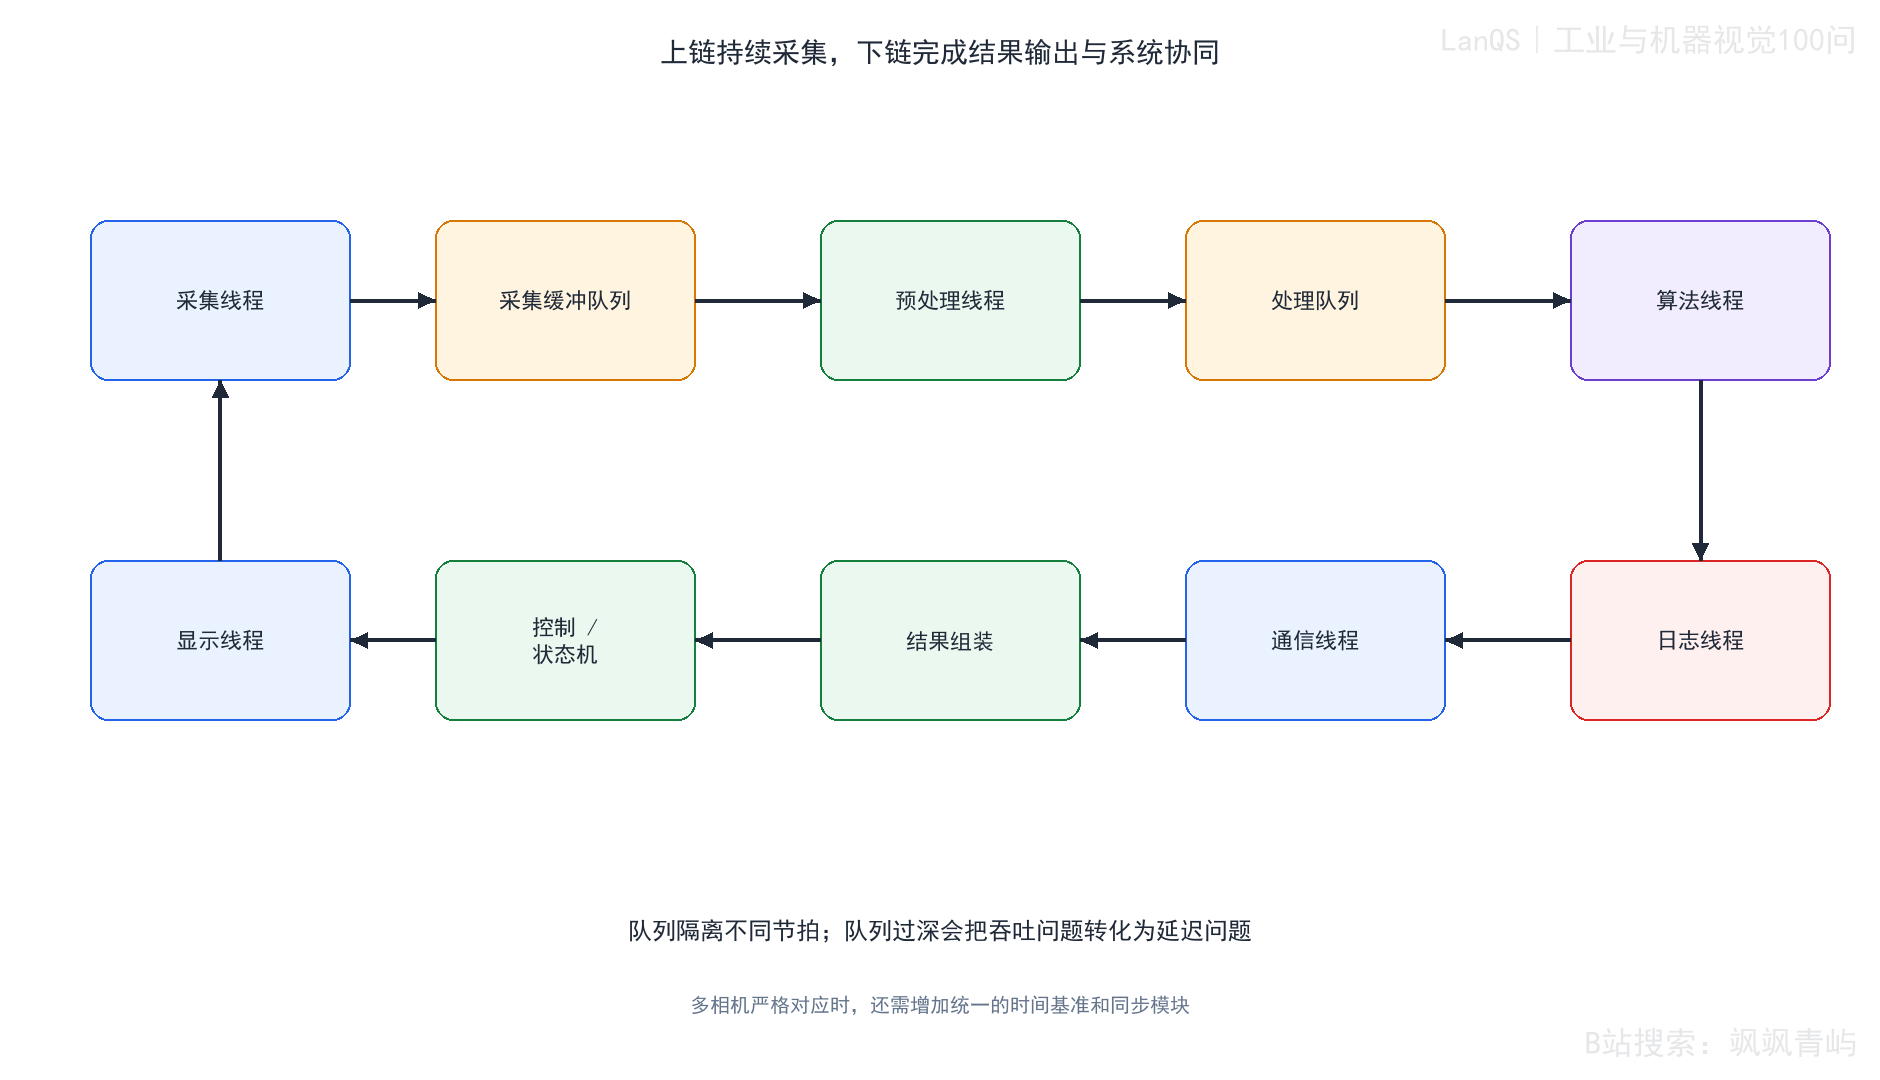
图97-1 多线程视觉处理流水线及其监控边界
采集线程应尽量只负责取图和附加元数据,把耗时处理移交给下游。每一帧至少要有单调时钟时间戳和递增序号;多相机系统还应保留硬件触发计数或曝光时间。取图操作必须设置超时,超时后记录相机状态并按策略重连,不能无限等待。
当下游处理变慢时,采集线程应依据业务策略执行背压。对追求实时画面的检测,可丢弃队列中的旧帧;对追求完整追溯的质量检测,可限制采集速率或暂时停止并报警。无论采用哪种策略,都要记录丢帧原因和丢弃的序号范围。
采集线程的异常状态可以分为超时、设备断开、帧序号跳变、时间戳回退、像素格式错误和驱动返回空缓冲。不同异常的恢复动作不应相同:短时超时可以重试,设备断开需要关闭并重新初始化句柄,序号跳变需要标记数据缺口,格式错误则应阻止错误图像进入模型。恢复期间产生的空结果必须带有明确的状态码,不能伪装成正常 NG。
线程适合共享内存、低开销传递和 I/O 重叠;进程适合隔离崩溃、利用多核 CPU 或绕开解释器级的全局锁,但会增加进程间通信和数据复制成本。Python 的 GIL(Global Interpreter Lock,全局解释器锁)会限制多个线程同时执行 Python 字节码;相机 I/O、数值库和部分推理库在原生代码中可能释放 GIL,因此不能仅凭语言名称判断并发效果,应以目标设备实测。
推理阶段还要考虑 GPU 或 NPU 的上下文、流和线程安全。若引擎实例不能安全地被多个线程同时调用,应采用单独推理线程、实例池或进程隔离。线程数过多会增加上下文切换、缓存竞争和内存占用;合理的线程数应通过阶段利用率、队列等待和端到端尾部时延来确定。
线程划分还应服从资源亲和性。采集线程可能需要较高优先级和稳定的回调响应,推理线程可能受加速器上下文限制,写盘线程则可能出现长时间阻塞。把这些任务都设置成同一优先级,或者让写盘线程与实时线程共享同一个锁,都会使理论流水线在压力下失效。调度策略、CPU 亲和性和优先级只有在目标操作系统与设备上验证后才能写入交付配置。
多进程并不自动提供更高吞吐。如果每个进程都复制一份高分辨率图像,内存带宽和 IPC(Inter-Process Communication,进程间通信)成本可能超过并行收益。选择进程隔离前,应比较共享内存句柄、序列化耗时、故障恢复收益和部署复杂度。
若多个相机拍摄同一工件,采集时间必须由硬件触发或统一时钟约束。仅按软件收到消息的先后顺序配对,无法保证图像属于同一次曝光。每路图像应携带相机编号、帧序号和时间戳,并设置配对窗口;超出窗口的图像要单独标记为缺帧、迟到或错配。
若各相机相互独立,系统可以为每路相机建立采集队列,再由汇聚阶段按工件编号或硬件触发计数配对。若结果必须严格按工件顺序输出,则应在汇聚点集中处理排序;这会增加等待,但能把顺序约束局部化。
同步验证不能只检查时间戳字段存在。应选取同一硬件触发下的多路图像,比较触发计数、曝光时间和到达时间的关系;还应测量网络或驱动抖动是否使到达顺序反转。配对窗口太窄会产生大量“缺帧”,太宽则可能把相邻工件错误配对。窗口大小应根据硬件同步精度、传输抖动和工件运动速度确定。
并发故障有几种不同的现场表现。死锁是线程互相持有对方需要的锁,处理时要统一锁顺序、缩短临界区、禁止在锁内做 I/O,并给等待设置超时;活锁表现为线程持续重试却没有有效进展,应限制重试频率并记录状态转移。竞态则让结果依赖不可控的执行顺序,适合用消息传递和明确的所有权转移减少共享可变对象。生产者停止后消费者仍永久等待,往往是结束消息或哨兵遗漏;工作线程已经退出而主程序仍显示运行,则属于异常被吞掉。监控线程必须集中收集这些异常,并根据策略报警或安全停机。
排查时应为每个阶段记录开始时间、结束时间、帧序号、队列入队和出队时间、线程状态以及异常堆栈。将这些事件按单调时钟排序,才能判断是采集慢、队列等待长、推理变慢还是通信阻塞。
建议为每帧建立一条可追踪的事件链:
capture_start -> captured(seq, ts) -> pre_start -> pre_end
-> infer_start -> infer_end -> post_end -> sent/saved
事件链中的每个节点都使用同一单调时钟,并附带帧序号和配置版本。监控系统可以据此计算阶段耗时、队列等待、迟到帧和中断链路。若只记录线程总耗时,就无法区分线程在等待队列、等待锁还是等待设备。
并发问题还需要可重复的故障注入:人为延长推理、暂停写盘、拔插相机、让通信接口超时,再观察系统是否按预期阻塞、丢弃、报警和恢复。故障注入后要检查是否有残留线程、未释放缓冲、重复输出和错误的帧序号。
流水线重叠算例
源算例采用以下阶段时间,单位均为毫秒:采集 40 ms、预处理 15 ms、推理 55 ms、通信 10 ms。
串行处理每帧耗时为
对应吞吐量约为
其中 fps(frames per second)表示每秒帧数。若把四个阶段放入可并行的流水线,理想稳定周期由最长阶段决定:
理论吞吐量约为
这是填满流水线后的理论值。按串行公式换算为约 8.3 fps;算例一次实际串行运行约为 8.19 fps,流水线实际运行约为 16.99 fps,约为串行结果的 2.07 倍。实际值低于理论值,原因可能包括线程调度、队列操作、内存复制、模型调用和计时开销。
伪代码应保留阶段边界和停止逻辑:
capture_loop:
    frame = camera.get(timeout=...)
    item = {image_ref, seq, timestamp, config_version}
    put_bounded(capture_queue, item, policy)
    on_stop: send_sentinel(capture_queue)

preprocess_loop:
    item = get_until_sentinel(capture_queue)
    item.tensor = preprocess(item.image_ref)
    put_bounded(inference_queue, item, policy)
    on_stop: send_sentinel(inference_queue)

inference_loop:
    item = get_until_sentinel(inference_queue)
    item.raw_output = engine.infer(item.tensor)
    put_bounded(result_queue, item, policy)
    on_stop: send_sentinel(result_queue)

communication_loop:
    item = get_until_sentinel(result_queue)
    send_result(item.seq, postprocess(item.raw_output))
算例证明流水线可以把阶段重叠起来,提高稳定吞吐;它不能证明实际系统一定达到 18.2 fps,也不能证明单帧时延降到 55 ms。若通信、写盘或共享加速器不能并行,最长阶段和实际队列等待都要重新测量。
图97-2把串行时间、理想流水线周期和一次实际运行结果放在一起。读图时应先区分“每帧总耗时”和“稳定输出间隔”,再检查实际吞吐与理论上限之间的差距。
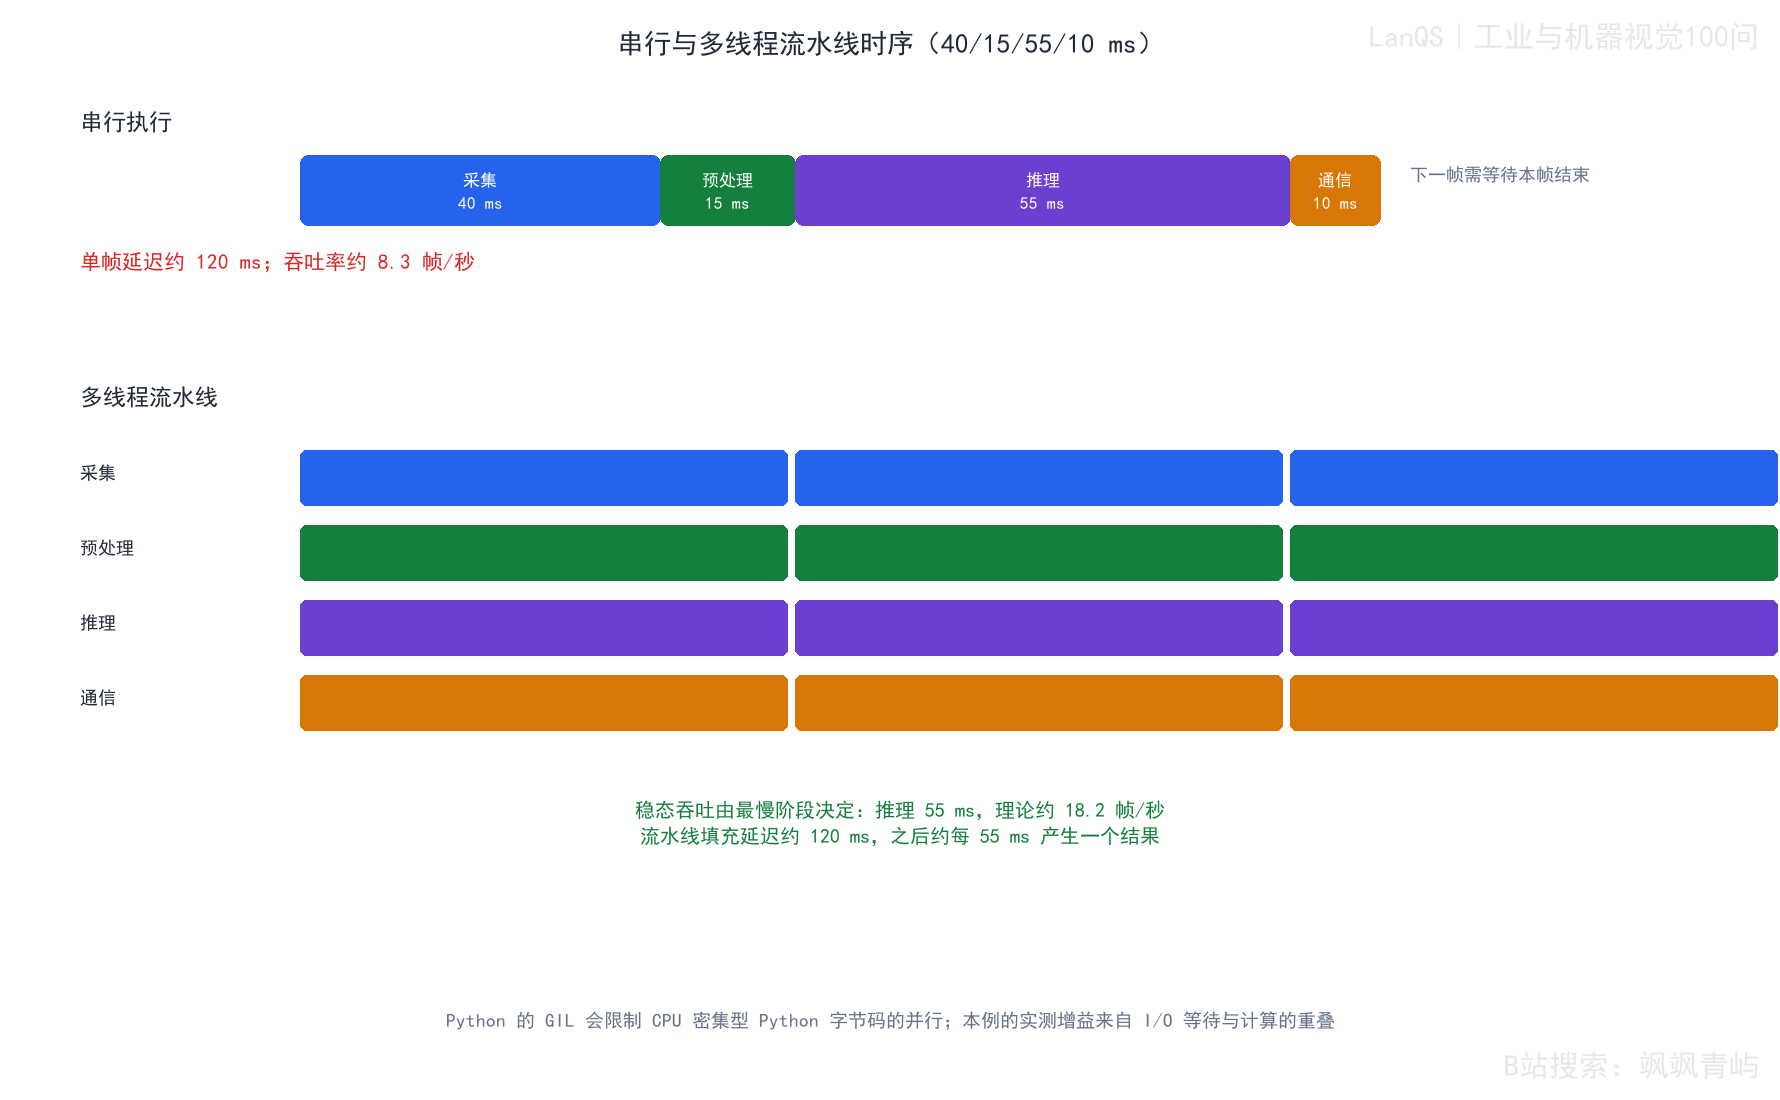
图97-2 串行处理与流水线处理的时间关系
实现选择与验证
Python 适合快速验证、编排线程和调用成熟推理库;C++ 更适合严格时延、底层采集、零拷贝和长期运行;Qt、ROS 2 或其他框架可以提供事件循环、组件通信和可视化能力。框架本身不会自动解决队列、停止、异常和资源所有权问题。选型时应以目标硬件的驱动支持、团队维护能力、可观测性和交付周期为依据。
无论采用何种语言,都应把配置、数据结构和状态机写在接口契约中。例如预处理阶段明确输入像素格式和输出张量布局,推理阶段明确模型版本和线程安全要求,通信阶段明确超时、重试和幂等性。接口契约比“某个线程调用某个函数”的实现细节更稳定,也便于以后把某一阶段改成进程或独立服务。
常见误区
- 把吞吐量当成单帧时延,认为流水线达到 18 fps 就能满足 55 ms 的控制响应。
- 用无界队列掩盖下游变慢,直到内存增长或结果严重滞后才报警。
- 只按软件接收顺序配对多相机图像,没有硬件触发或时间窗口。
- 以为线程数越多越快,忽略共享 GPU、内存带宽和调度开销。
- 在锁内执行推理、写盘或网络发送,导致长时间阻塞其他阶段。
- 线程退出时不发送哨兵、不回收资源,造成程序无法正常停止。
术语与符号表
- 流水线:把处理任务拆成多个阶段,使不同帧在不同阶段同时执行。
- 吞吐量:单位时间完成的帧数,常用 fps 表示。
- 端到端时延:一帧从采集到结果输出的完整时间。
- 背压:下游变慢时向上游施加的限速、阻塞或丢弃策略。
- GIL:Global Interpreter Lock,Python 解释器中的全局锁,会限制 Python 字节码的并行执行。
- PLC:Programmable Logic Controller,可编程逻辑控制器。
- MES:Manufacturing Execution System,制造执行系统。
- \(T_{\mathrm{cap}}\)、\(T_{\mathrm{pre}}\)、\(T_{\mathrm{inf}}\)、\(T_{\mathrm{comm}}\):采集、预处理、推理和通信阶段时间。
- \(T_{\mathrm{serial}}\):串行处理一帧的总时间。
- \(T_{\mathrm{cycle}}\):流水线填满后的理想稳定输出周期。
延伸阅读
- 相机厂商的异步采集、硬件触发和时间戳文档。
- 目标推理引擎的线程安全、上下文和流管理文档。
- Python
queue、C++ 并发队列以及进程间共享内存的官方文档。 - 工业控制系统的实时性、超时、故障恢复和事件追踪规范。
第98问 如果图像采集缓冲区大小设置不当,会出现哪些问题?
模块:工业视觉系统的数据缓存与实时性
图像缓存用于吸收采集与处理之间的短时速度差。它只能缓冲有限时间,不能把长期处理能力不足变成可持续的实时系统。本题从缓存容量、过小和过大两类风险、内存估算、接口特性、实测方法和动态调参说明如何设计有边界的图像缓存。
缓冲区的作用与失效表现
设相机帧率为 \(f_{\mathrm{cam}}\),单位为帧/秒;处理链路可能出现的停顿时间为 \(T_{\mathrm{stall}}\),单位为秒;额外安全余量为 \(M\),单位为帧。应用层缓存容量至少应满足
$$ N_{\mathrm{buf}}\geq\left\lceil f_{\mathrm{cam}}T_{\mathrm{stall}}\right\rceil+M $$ 其中 \(N_{\mathrm{buf}}\) 是应用层队列可容纳的图像帧数,\(\lceil\cdot\rceil\) 表示向上取整。这个公式的前提是相机仍在持续产生图像,停顿期间没有其他缓冲层替应用队列接收数据,并且停顿后的平均处理能力能够追上输入。驱动环形缓冲、DMA 缓冲和接口内部缓存应单独核算,不能把它们未经验证地算进 \(N_{\mathrm{buf}}\)。
如果相机为 30 帧/秒,现场测得需要覆盖的停顿为 120 ms,取 \(M=2\) 帧,则
6 帧只表示按该停顿假设得到的最低应用层容量。若 120 ms 只是平均值,低于 99.9 百分位的峰值,容量仍可能不足;若一帧占用 6.4 MB,则仅图像数据就需要约 \(6\times6.4=38.4\) MB,还要加上其他缓冲和运行时开销。
缓存过小时,短时抖动会立即传递到采集端。常见结果包括驱动报错、丢帧、超时、帧序号跳变和相机重连。若系统采用阻塞策略,采集线程可能被迫等待;若采用丢弃策略,则需要知道丢的是旧帧还是新帧,否则检测结果的时间含义会发生变化。
缓存过小也会放大偶发的预处理、推理、磁盘写入和网络延迟。工程评估应记录处理时延的尾部,例如第 99 百分位或第 99.9 百分位,并以业务允许的停顿时长代入容量公式,而不能只看平均处理时间。
现场测量时应把“队列满”与“相机端丢帧”区分开。应用队列满可以由程序计数,驱动或采集卡丢帧则要读取 SDK 统计、帧序号和接口错误。两者都出现时,先确认丢帧发生的层级,再决定是调整应用队列、减少复制、降低输入速率,还是检查链路质量。
缓存过大首先增加内存占用。高分辨率图像、彩色格式、多路相机和多级队列叠加后,容量很快达到数百 MB 或数 GB。若采用复制方式传递图像,还要考虑每一级的副本。
更隐蔽的风险是延迟。队列越长,旧图像在队列中等待的时间越长;系统可能没有丢帧,却把已经过时的结果发送给控制设备。实时画面通常应限制队列长度并在过载时丢弃旧帧;追溯型检测则需要把延迟和存储成本明确写入系统约束。
可以把允许的最大队列等待换算成业务时间:当相机为 30 帧/秒时,队列中等待 15 帧就意味着仅排队时间约为 \(15/30=0.5\) 秒。若工件在这 0.5 秒内已经离开执行机构位置,结果即使最终正确,也可能无法用于当前控制动作。因此容量设计必须把“能否容纳停顿”和“结果是否仍然有效”同时写入验收条件。
下图用三个区域说明缓存设计的基本权衡。横向看是缓存容量增加,纵向看是系统状态;在“过小”区域会频繁丢帧,在中间区域可以吸收正常抖动,在“过大”区域则可能出现内存和延迟风险。
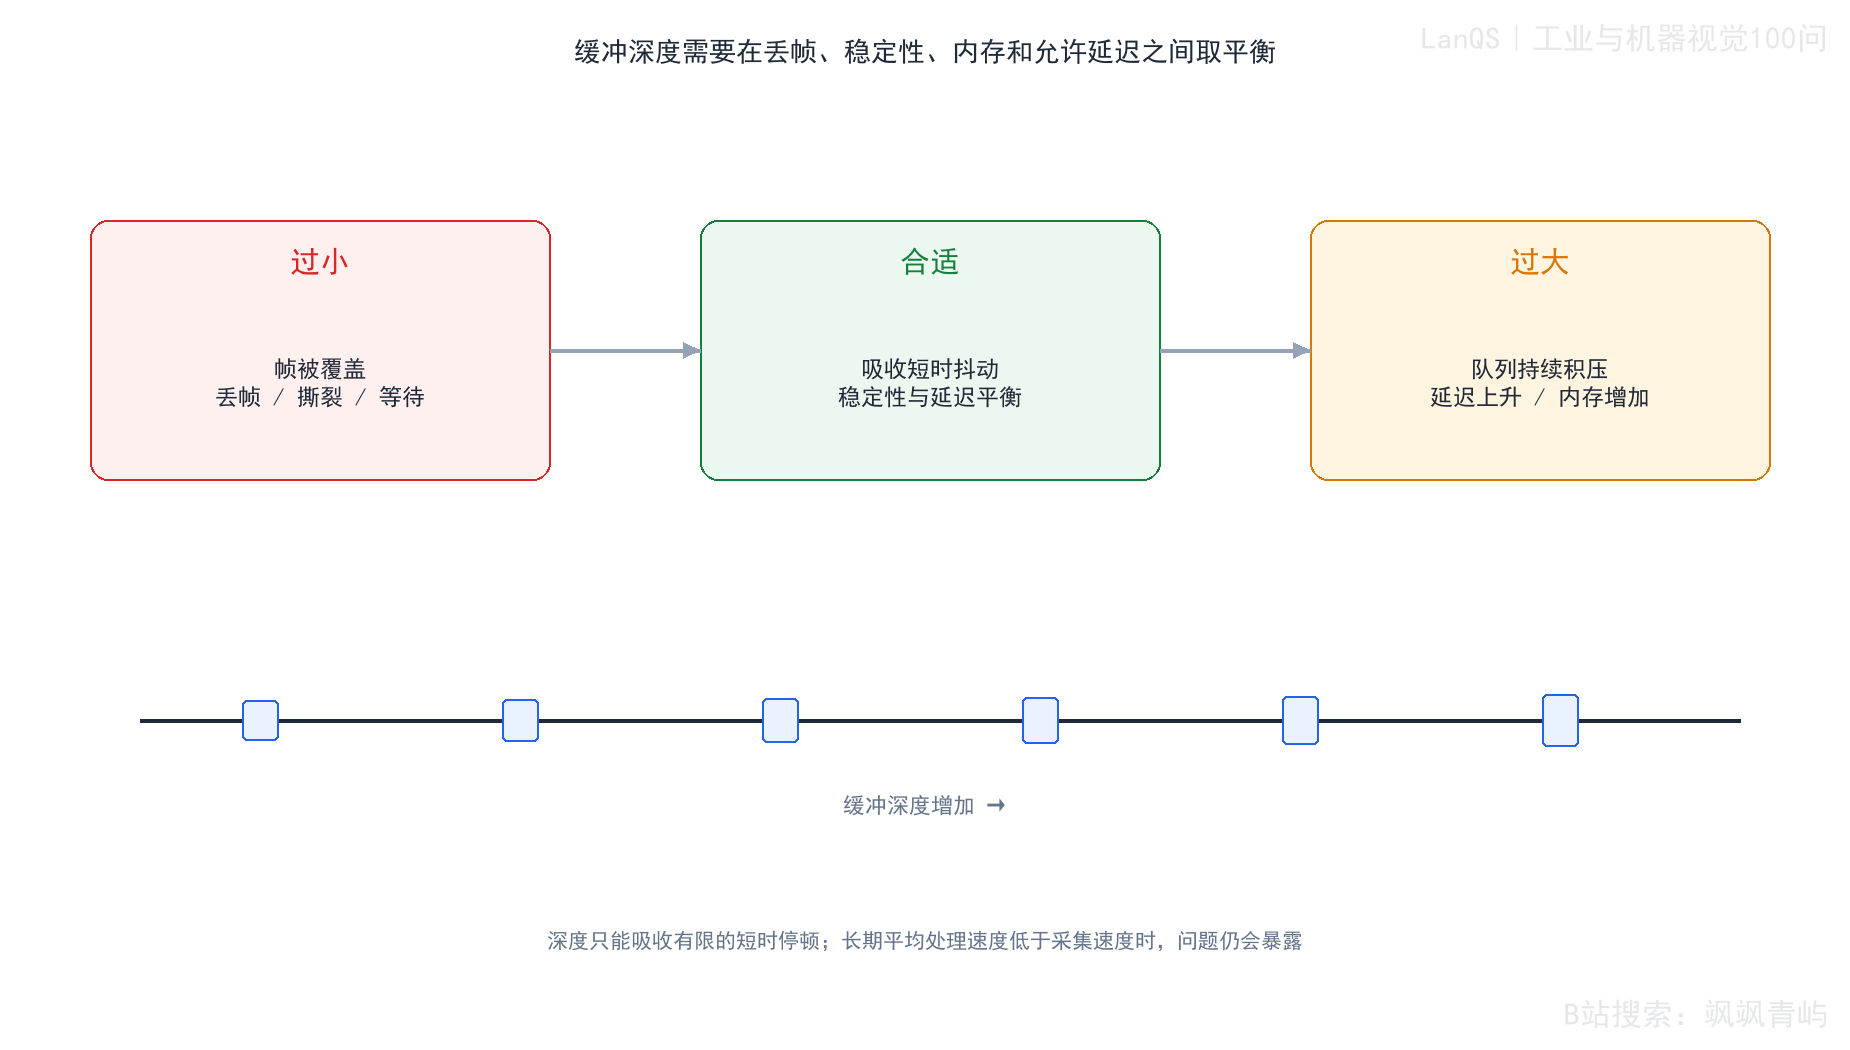
图98-1 图像缓存容量与实时性、资源占用的权衡
容量估算与管理策略
单帧内存可按像素数、每像素字节数和临时副本估算:
其中 \(W,H\) 是图像宽、高,\(B_{\mathrm{pixel}}\) 是像素格式的字节数,\(C_{\mathrm{copy}}\) 是同时存在的副本或缓冲层数量。缓存总内存近似为
带宽和内存预算应按峰值而非平均值估算。预处理可能把 Mono8 转成浮点张量,推理引擎还会申请中间张量;如果这些数据与原始图像同时存在,实际占用会高于单帧大小乘队列深度。
- 固定环形缓存:容量和内存上限明确,适合连续采集;满时必须规定覆盖旧帧还是拒绝新帧。
- 双缓冲:一个缓冲用于采集,另一个用于处理,结构简单,但只能吸收很短的停顿。
- 三缓冲:在采集、处理和显示或通信之间提供更多重叠,代价是额外内存和管理复杂度。
- 有界队列:把最大延迟和内存上限显式化,适合需要监控和背压的系统。
- 零拷贝或句柄传递:减少大图复制,但要求明确缓冲区所有权、生命周期和跨设备访问限制。
实时检测常见策略是保留最新帧,并记录丢弃计数;全量追溯则可选择阻塞采集、临时降低帧率或将原图写入独立存储。选型前应写出业务允许的最大结果延迟和可接受的丢帧类型。
对于环形缓冲,覆盖旧帧前应先确认旧帧没有被消费者持有。一个安全实现通常把“空闲、采集中、待处理、处理中、已完成”作为缓冲状态,只有已完成或已归还的缓冲才能重新使用。若采集回调和推理线程同时修改状态,应使用原子操作或锁保护,并在异常退出时回收所有非空闲缓冲。
缓存策略还会影响诊断证据。丢弃旧帧时应保存丢弃计数、起止序号和触发时的队列深度;阻塞采集时应记录阻塞起止时间和相机端状态;降级时应记录生效的分辨率、帧率、模型或 ROI。没有这些元数据,事后无法判断一次 NG 缺失是算法问题还是缓存策略主动舍弃了输入。
USB3 Vision 可能受主机控制器和带宽共享影响;GigE Vision 需要关注网络包、交换机、网卡接收缓冲和丢包重传;Camera Link 通常具有较稳定的专用链路,但采集卡和驱动配置仍会影响缓存;CoaXPress 具有较高吞吐,采集卡内存、DMA 和多路并行配置需要单独验证。
接口的名义带宽不能直接等于应用可用带宽。应在目标分辨率、帧率、像素格式和相机数量下实测接收速率,并将驱动、采集卡、操作系统和应用层的缓冲分别记录。多相机系统还要评估同时曝光造成的瞬时带宽峰值。
诊断、扫描与可靠调参
现场应至少采集以下指标:相机实际帧率、处理时延分布、队列平均与最大长度、丢帧数、丢帧位置、峰值内存、温度、接口错误和重连次数。若队列在低负载时逐步增长,说明平均处理能力已低于输入;增大缓存只能延后溢出。
常见模式及含义如下:
- 队列很快达到上限且处理时延稳定:处理能力不足或策略选择不当。
- 队列随温度升高逐步变长:可能存在热降频或资源竞争。
- 队列偶尔尖峰后恢复:更像短时 I/O、调度或通信抖动,可用尾部时延估算容量。
- 队列不高但仍丢帧:问题可能在驱动、接口包、采集卡或相机端,不应只调应用队列。
测试应至少包含正常生产速率、短时阻塞、连续高负载和恢复四个窗口。短时阻塞用于估计 \(T_{\mathrm{stall}}\);连续高负载用于判断生产速率是否长期高于消费速率;恢复窗口用于判断处理能力恢复后队列需要多久清空。若队列清空时间超过业务允许窗口,容量再大也只能延迟故障暴露。
容量扫描算例
源算例用固定参数模拟不同缓存容量下的丢帧和内存趋势。模拟设定包括:相机 30 帧/秒,处理能力低于输入,单帧图像占用约 6.4 MB;扫描容量 2、4、8、16、32 帧,并分别记录丢帧率、平均队列长度、最大队列长度和内存占用。
可复核的计算逻辑如下:
for each buffer_size in [2, 4, 8, 16, 32]:
    reset queue and counters
    for each simulated time step:
        if a camera frame arrives:
            if queue is full: count a dropped frame
            else enqueue one frame
        if processor is ready: dequeue one frame
    record drop_rate, average_depth, max_depth
    memory = buffer_size * 6.4 MB

处理时间的采样也应保留在复核记录中:固定随机种子 7;每次消费先从对数正态分布采样基础处理时间,约 2% 的样本再增加 45–75 ms 停顿;用 consumer_busy_until 表示消费者何时空闲;每个采集时刻先清理已经完成的队列元素,再在容量达到上限时计数丢帧,否则将当前时刻入队。这样得到的结果与随机生成一组丢帧率不同,能够复核容量、突发停顿和内存之间的关系。

源模拟固定随机种子 7,模拟 20,000 帧,采集周期为 \(1000/30\) ms;处理时间以中位数约 13 ms 的对数正态分布为主体,并以 2% 概率叠加 45–75 ms 的长停顿,用来代表写盘、垃圾回收或操作系统调度抖动。容量扫描为 1、2、3、4、6、8、12、16、24、32 帧。一次可复核运行的输出为:

| 缓存容量 | 丢帧率 | 平均队列长度 | 最大队列长度 | 图像缓存内存 |
| ---: | ---: | ---: | ---: | ---: |
| 1 帧 | 4.355% | 0.04 帧 | 1 帧 | 6.4 MB |
| 2 帧 | 2.780% | 0.10 帧 | 2 帧 | 12.8 MB |
| 3 帧 | 0.940% | 0.18 帧 | 3 帧 | 19.2 MB |
| 4 帧 | 0.570% | 0.24 帧 | 4 帧 | 25.6 MB |
| 6 帧 | 0.100% | 0.25 帧 | 6 帧 | 38.4 MB |
| 8 帧 | 0.005% | 0.28 帧 | 8 帧 | 51.2 MB |
| 12 帧 | 0.000% | 0.27 帧 | 12 帧 | 76.8 MB |
| 16 帧 | 0.000% | 0.29 帧 | 16 帧 | 102.4 MB |
| 24 帧 | 0.000% | 0.28 帧 | 24 帧 | 153.6 MB |
| 32 帧 | 0.000% | 0.29 帧 | 32 帧 | 204.8 MB |

从 1 帧到 4 帧,丢帧率快速下降,说明这一段主要受处理时间瞬时波动影响;从 6 帧开始,在该负载下丢帧率已经接近或等于零,继续增加容量只增加线性内存成本。6–8 帧是这个模拟负载的收益递减区间;32 帧并不自动更安全,它的图像缓存内存约为 6 帧的 5.33 倍。

这里的丢帧率是固定随机模型的输出,不能当作目标设备的实测指标;模拟没有包含驱动内部缓存、网络抖动、温度变化和真实接口时延。结果可用于说明容量增大通常会降低突发溢出概率,但收益会逐渐变小;它不足以单独确定现场应选 6 帧、8 帧或 32 帧。

图98-2把容量、内存和丢帧趋势放在一起。读图时先确认丢帧指标的定义和测试负载,再判断从更大容量获得的收益是否值得内存和延迟成本。

<p align="center"><img src="images/Q98/part18_98_02_buffer_sweep_cn.png" alt="缓存容量扫描结果图" width="92%"></p>
<p align="center">图98-2 缓存容量扫描中的丢帧与内存趋势</p>
<div class="figure-note">图中左轴表示模拟丢帧率的相对变化,右轴表示图像缓存内存,容量越大内存近似线性增加;约 6 帧以后,示例模型中的丢帧收益明显变小。该图用于解释趋势,具体容量仍需用现场的尾部停顿、驱动缓存和端到端延迟重新测定。</div>


缓存容量可以通过配置项调整,但不应在运行中无条件扩容。动态调参前要检查可用内存、当前队列深度和结果延迟;扩容仍无法追上长期速率差时,应转入降级、限速或报警。验收至少应规定:最大允许队列深度、最大结果延迟、丢帧率上限、峰值内存、接口错误和恢复时间。

建议把容量作为配置版本的一部分写入每帧或每次运行记录。更换图像格式、开启调试图、增加相机路数或升级驱动后,应重新测量单帧占用和停顿分布;不能沿用旧容量而只修改一个整数。配置变更还应触发固定样本回归、短时阻塞测试和长稳测试,确认容量增加没有把延迟推过控制边界。

### 常见误区

- 只按平均帧率和平均处理时间估算缓存,忽略尾部停顿。
- 把驱动内部缓冲、采集卡缓冲和应用队列混成一个数字。
- 认为缓存越大越安全,忽略旧帧延迟和系统内存上限。
- 发现丢帧就不断增加应用队列,却不检查接口、驱动和长期处理能力。
- 以模拟图表的丢帧率直接承诺现场性能。
- 使用零拷贝后不再管理缓冲区所有权,导致数据被提前复用或释放。

### 术语与符号表

- 应用层缓存:由视觉程序管理、用于暂存待处理图像的队列或环形缓冲。
- 驱动缓冲:采集驱动或采集卡为接收图像保留的缓冲区。
- \(f_{\mathrm{cam}}\):相机帧率,单位为帧/秒。
- \(T_{\mathrm{stall}}\):需要吸收的处理停顿时间,单位为秒。
- \(M\):额外安全余量,单位为帧。
- \(N_{\mathrm{buf}}\):应用层缓存容量,单位为帧。
- \(B_{\mathrm{frame}}\):单帧及其副本的估算内存。
- DMA:Direct Memory Access,直接内存访问。
- USB3 Vision、GigE Vision、Camera Link、CoaXPress:工业相机常用接口或通信标准。
- 尾部时延:时延分布高分位处的延迟,用于描述偶发但重要的长停顿。

### 延伸阅读

- USB3 Vision、GigE Vision、Camera Link 和 CoaXPress 的接口与采集卡文档。
- 目标相机 SDK 关于环形缓冲、超时、丢帧和重连的说明。
- 操作系统网络接收缓冲、DMA 和大页内存配置文档。
- 实时系统中的尾部时延、背压和内存预算方法。

---

# 第99问 如何实现生产者—消费者模式来处理图像队列?

> 模块:工业视觉系统并发控制与数据流策略

队列策略决定系统过载时保留哪些数据、阻塞哪些阶段,以及结果延迟如何变化。策略选择必须从业务目标出发:有的系统要求尽量处理每一帧,有的系统要求结果紧跟当前工件,还有的系统需要在过载时明确降级。本题先定义生产者、消费者和队列边界,再比较有界阻塞、丢弃和降级策略,并用统一模拟解释各自代价。

### 队列模型与基本实现

生产者负责生成数据,常见为相机采集、文件读取或上游算法;消费者负责取出数据并处理,常见为预处理、推理、通信和存储。队列在二者之间提供时间解耦,但解耦能力是有限的。

若生产速率为 \(\lambda_p\),消费速率为 \(\lambda_c\),当 \(\lambda_p>\lambda_c\) 持续存在时,队列深度会不断增加。无界队列最终消耗内存;有界队列则必须在满队列时阻塞或丢弃。短时的速率差可以由队列吸收,长期的速率差必须通过优化、限速、扩容或业务降级解决。

这里还要区分瞬时速率和长期平均速率。相机触发可能在很短时间内集中产生多帧,消费者虽然平均速度足够,仍需要队列吸收触发抖动;相反,如果消费者长期少处理每秒一帧,队列必然会在某个时刻溢出。验收时应分别施加突发负载和持续过载,不能用一段平稳流量覆盖两种情况。

队列深度本身也是一种业务状态:低深度表示处理链路通常跟得上,持续升高表示等待时间正在累积,频繁触顶表示已经进入过载。应为这些状态设置阈值、告警和恢复条件,并把策略变化写入结果记录。


以 2448×2048 的 Mono8 图像为例,单帧原始数据约为

$$
B_{\mathrm{raw}}=2448\times2048\times1=5,013,504\ \mathrm{bytes}\approx5.0\ \mathrm{MB}
$$

若预处理还保留浮点张量、推理输入和结果副本,队列中每个元素的实际成本可能远高于 5.0 MB。队列容量应由峰值内存、允许的等待时间和过载策略共同决定,而不能只按“内存足够”设置一个很大的数字。


队列元素至少应携带图像引用、帧序号、硬件或单调时钟时间戳、相机编号、工件编号、模型版本和配置版本。若消费者只拿到裸指针而生产者已复用缓冲区,可能出现图像内容与序号不匹配的隐蔽错误。

应明确三类责任:谁创建或取得缓冲区,谁在处理期间拥有它,谁负责归还或释放它。跨线程可以通过引用计数、对象池或所有权转移实现;跨进程则要额外说明共享内存句柄和序列化边界。队列关闭时,仍在处理的元素、未消费元素和异常元素都应有明确的回收路径。

为了避免把一帧错误地关联到另一件产品,元数据应随图像一起移动,不能在消费者侧用“当前时间”或“最近一帧”补写。结果合并时,若发现序号缺口、版本变化或时间戳超出窗口,应生成状态明确的未判定记录,并让控制层决定是否停机或复检。


有界队列需要同时处理正常入队、队列已满、消费者超时、停止信号和工作线程异常。伪代码如下:

```text
put(item):
    if stop_event is set: release(item); return STOPPED
    if policy == BLOCK:
        wait until space or timeout or stop_event
        if timeout: record producer_blocked; apply_timeout_policy
    if policy == DROP_OLDEST and queue is full:
        old = pop_oldest(); release(old); count_drop_oldest += 1
    if policy == DROP_NEWEST and queue is full:
        release(item); count_drop_newest += 1; return DROPPED
    enqueue(item)

get():
    wait until item or sentinel or timeout
    if sentinel: release_sentinel_if_needed; return STOPPED
    return item

shutdown():
    stop_event.set()
    stop producers first
    enqueue one sentinel per consumer, or close queue with an explicit state
    join workers and release every remaining item
实现中还要保证 Full、Empty、超时和消费者异常不会被静默忽略。若使用任务计数,应让每个成功取出的元素最终对应一次完成通知;停止路径也要单独定义,避免主线程永远等待未完成任务。
满载策略与实时性取舍
队列满时阻塞生产者,尽可能保留每一帧。它适合完整记录、每帧都必须判定的质量流程,但会把下游变慢传回采集端。若相机驱动不能阻塞,最终仍可能在更低层丢帧;因此必须监控生产者阻塞时间和实际采集丢帧。
队列满时删除等待时间最长的旧帧,再放入最新帧。它适合当前画面价值高于历史画面的实时监控和控制。代价是部分工件没有被处理,必须记录丢弃序号、时间戳和计数。
队列满时拒绝新到的帧,保留已进入队列的处理顺序。它适合已入队数据更重要、且希望避免改变既有处理序列的场景,但会让系统持续处理旧画面,实时性可能恶化。
降级可以包括降低采集帧率、只保留 ROI(Region of Interest,感兴趣区域)、降低图像分辨率、跳过非关键模型或只保存异常图像。降级必须是显式的状态机:触发条件、告警、恢复条件和对检测能力的影响都要记录,不能在后台静默改变判定逻辑。
策略选择可以用四个问题落地:是否每帧都必须判定,结果允许等待多久,丢失哪一类帧更危险,以及过载时控制设备应做什么。质量追溯通常优先保证样本完整性;在线控制通常优先保证结果新鲜度;人工复核流程则可能优先保留低置信度和边界帧。答案不同,队列策略也应不同。
下图显示采集、处理和结果合并之间的队列边界。图中的四种策略是概念选项;后面的统一算例只比较三种可复核策略:无界队列、有界阻塞和有界丢弃最旧帧。
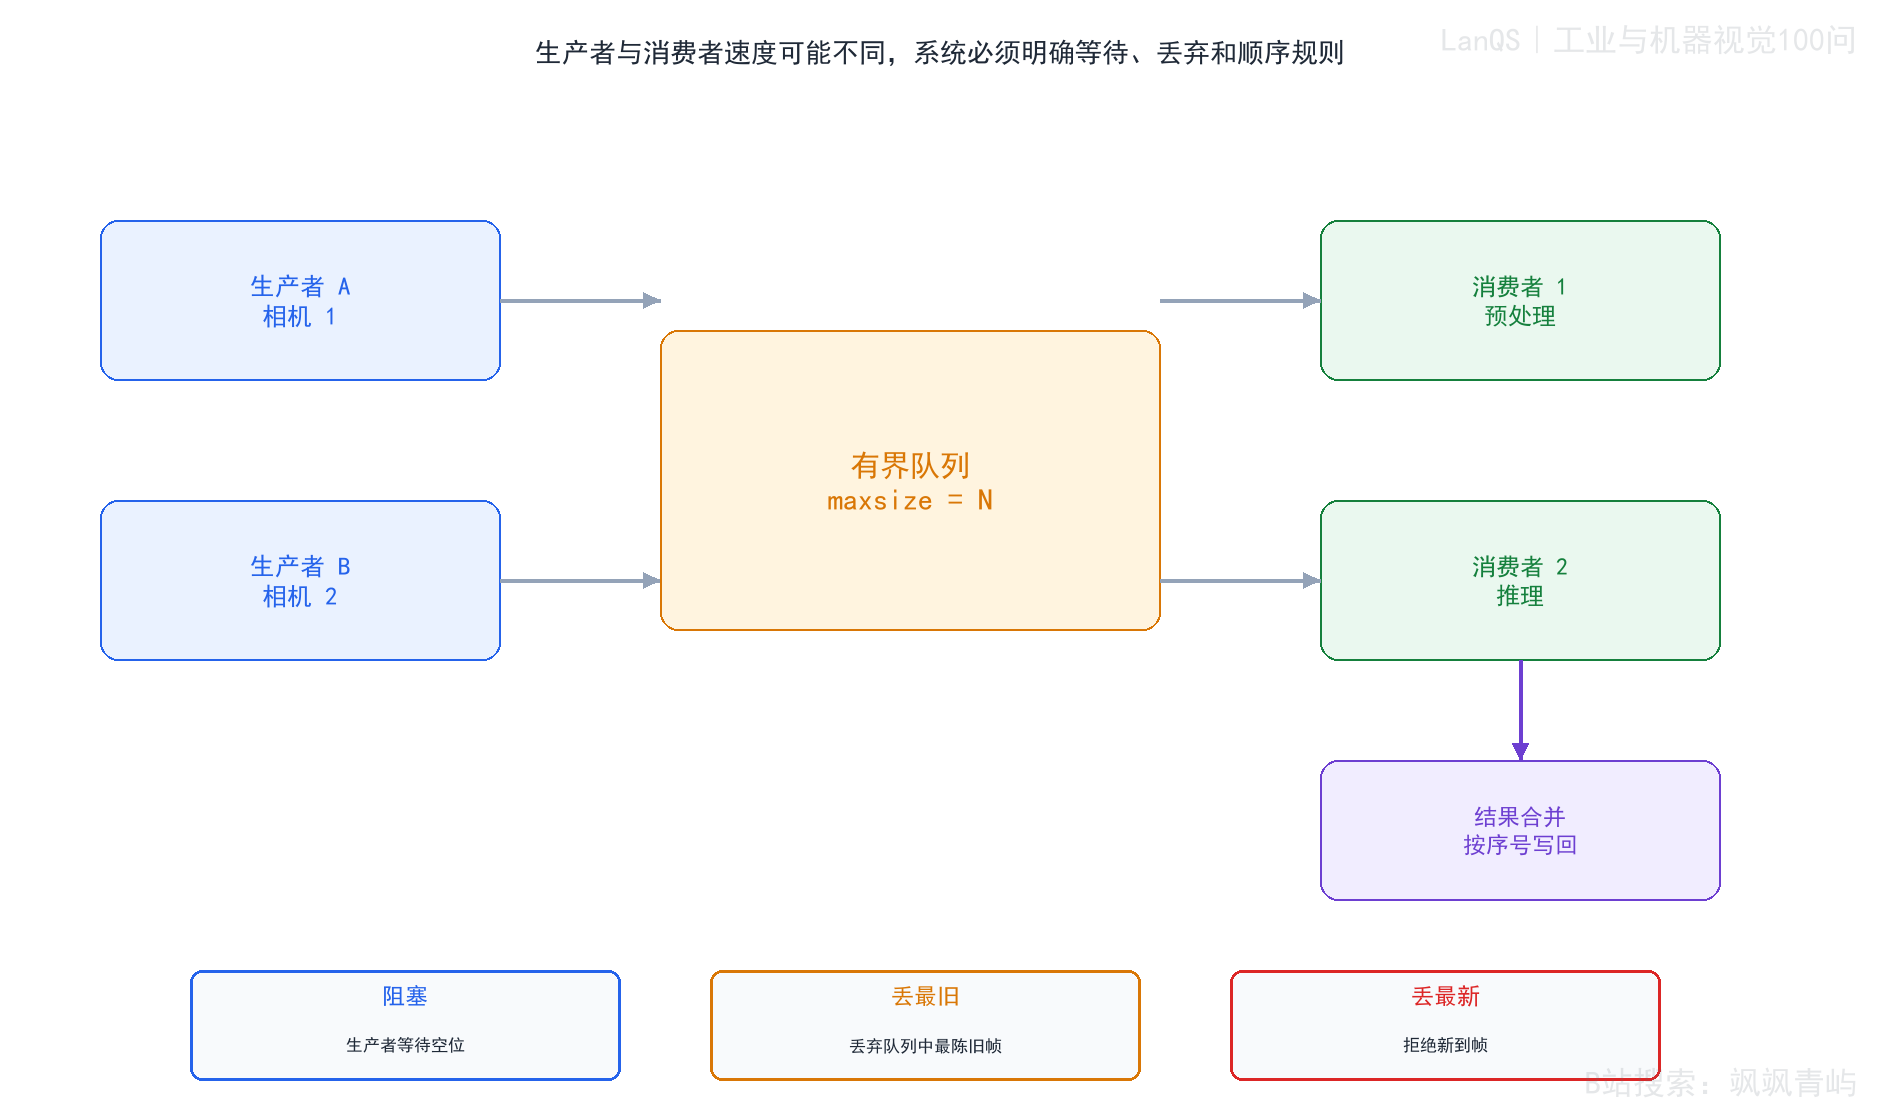
图99-1 生产者—消费者队列及过载策略
多阶段系统可能同时存在采集队列、预处理队列、推理队列和写盘队列。每级队列都设得很大,会把内存和延迟相乘;每级都立即丢弃,又可能让数据在不易观察的位置消失。应为每级队列设置容量、丢弃计数、最大等待时间和上下游关联标识,并建立全局过载状态。
若推理队列达到阈值,可以先降低日志级别或暂停非关键保存;若通信连续超时,应阻止新的非关键任务进入,避免队列继续扩大。背压动作必须与安全策略相容,不能为了维持画面而跳过必须发送给控制器的关键结果。
丢弃旧帧会改变输出帧序列;多线程处理完成顺序也可能与采集顺序不同。若业务需要严格顺序,应在结果合并点按帧序号重排,并为缺失帧设置超时;若业务只关心当前工件,应优先使用工件编号和时间戳,不要假设“第 N 个结果对应第 N 个采集消息”。
实时系统要同时报告队列等待时间和处理时间。仅报告消费者的推理时延,会掩盖图像在队列中等待数百毫秒的事实。
三种队列策略的统一算例
源算例设置生产速率 60 帧/秒、消费速率 35 帧/秒、运行 6 秒、有界容量 8 帧。三种策略分别为:无界队列、有界阻塞、有界丢弃最旧帧。一次运行的结果如下:
| 策略 | 产生帧数 | 消费帧数 | 最终队列 | 峰值队列 | 丢弃帧数 | 生产者阻塞时间 |
|---|---|---|---|---|---|---|
| 无界队列 | 361 | 175 | 186 | 194 | 0 | 未统计 |
| 有界阻塞 | 176 | 176 | 0 | 8 | 0 | 5.733 s |
| 有界丢弃最旧帧 | 361 | 175 | 0 | 8 | 186 | 未统计 |
模拟逻辑可以概括为:生产者按约 16.7 ms 产生一帧,消费者按约 28.6 ms 消费一帧;每次入队依据策略处理满队列,每次消费更新计数和队列深度,最后等待消费者完成并统计结果。结果表明,无界队列保留了数据但积累了 186 帧;有界阻塞把生产速率压回消费能力,并付出了 5.733 s 的生产者等待;丢弃最旧帧维持了最新数据,但丢弃了 186 帧。
表中“产生帧数”不等于相机实际永远能产生的帧数:阻塞策略会限制生产者继续生成。模拟没有直接计算每一帧的端到端延迟,因此不能从队列深度表直接推出完整的时延分布。现场还应记录每帧入队、出队和输出时间。
这个算例还展示了策略之间的守恒关系:在丢弃最旧帧策略中,产生帧数与消费帧数之差正好对应丢弃帧数;在有界阻塞策略中,产生帧数下降,差值由生产者等待时间体现。检查这些计数关系,可以及早发现统计代码把“拒绝入队”“消费失败”和“相机没有产生”混在一起的问题。
下图按统一算例汇总三种策略的核心结果。柱形数值以表格为准,曲线用于帮助理解队列是否保持有界;它不替代现场逐帧时间戳记录。
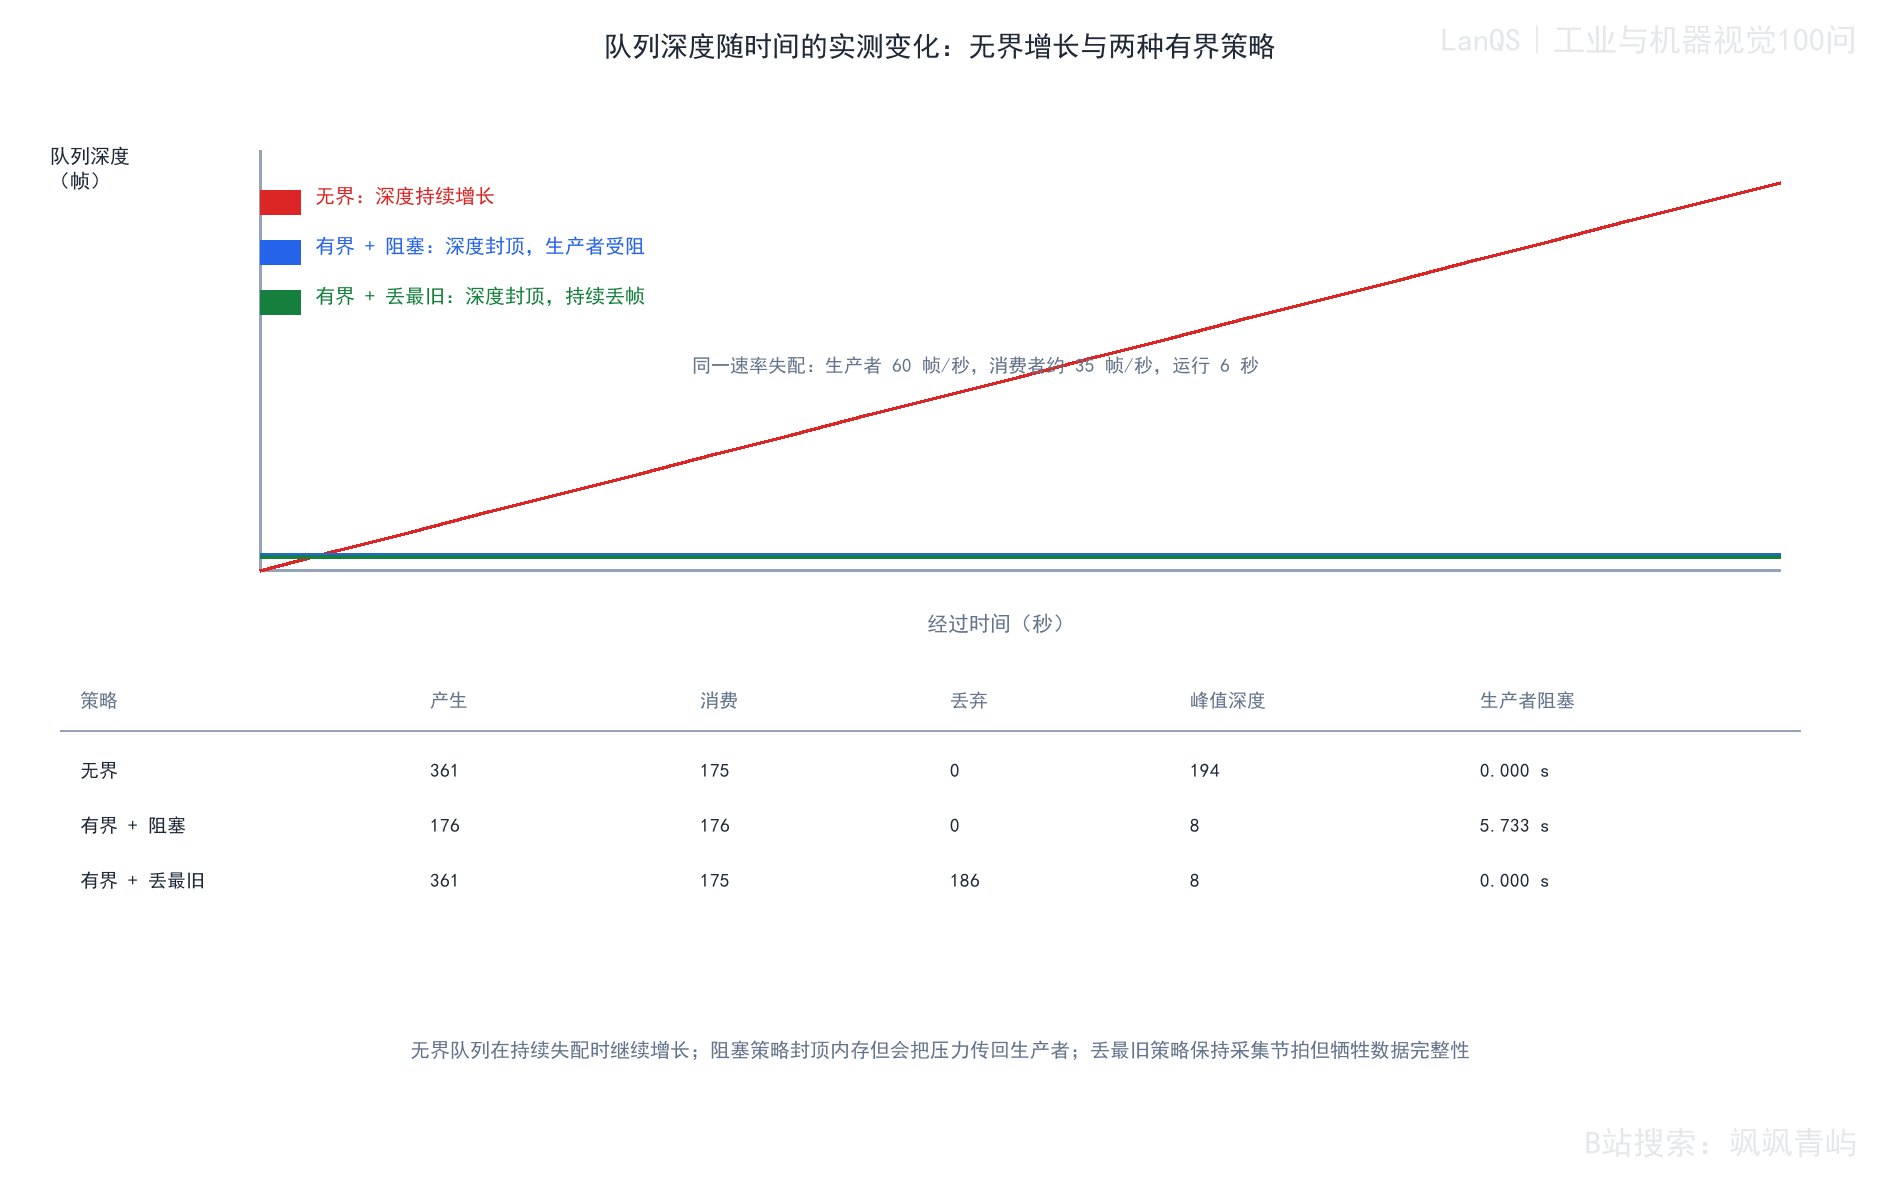
图99-2 三种队列策略的统一模拟结果
验证、安全边界与验收
无界队列牺牲内存和延迟换取暂时不丢帧;阻塞策略牺牲采集连续性或生产者吞吐换取完整处理;丢弃策略牺牲部分数据换取有界延迟;降级策略牺牲部分算法能力换取系统继续工作。没有一种策略在所有视觉任务中都占优。
策略确定后,应在结果、报警、日志和班次统计中体现其影响。例如丢弃最旧帧时,产品质量统计应区分“检测为 OK”和“没有被检测”;阻塞导致相机停采时,系统应记录生产者阻塞和采集暂停,而不能把它们归为正常无缺陷。
队列本身线程安全,不代表队列元素内部的图像对象线程安全。共享模型、相机句柄、显示对象和日志对象仍要遵守各自的线程限制。锁的顺序应全局统一,回调中不应再次同步等待持锁线程;异常应沿任务边界传递到监控线程。
关闭系统时,推荐先停止生产者,再让消费者处理或丢弃剩余数据,发送明确哨兵,等待工作线程退出,最后释放相机、模型和缓存资源。若业务要求快速停机,应定义哪些数据可以丢弃以及如何记录。
验收应在正常、峰值和异常三类负载下进行:
- 正常负载:确认队列深度稳定、结果顺序和资源占用。
- 峰值负载:人为增加推理或写盘时延,验证满队列策略和告警。
- 异常负载:断开相机、暂停消费者、制造通信超时,验证停止、恢复和数据回收。
必须记录产生、消费、丢弃、阻塞、最终队列、峰值队列、等待时间和恢复时间。只有把这些指标与业务允许的漏检、延迟和追溯要求对应起来,队列策略才算完成设计。
放行前还应验证重启和升级场景:运行中停止生产者,检查剩余元素是否按规则处理;重启后检查帧序号、配置版本和统计计数是否重新初始化或正确续接;升级策略后用同一负载复现实验,确保丢弃和阻塞的含义没有悄悄改变。
常见误区
- 把“零丢帧”当成唯一目标,忽略无界队列造成的内存增长和结果陈旧。
- 采用丢弃最旧帧,却不记录丢弃序号,导致质量统计失真。
- 只给单个队列设容量,没有评估多级队列的总内存和总延迟。
- 让降级逻辑静默修改分辨率、阈值或模型,造成结果不可追溯。
- 关闭线程时直接销毁相机或模型,遗留正在使用的缓冲区。
- 用最终队列深度代替逐帧端到端延迟。
术语与符号表
- 生产者:向队列写入图像或任务的线程、进程或设备。
- 消费者:从队列取出并处理图像或任务的线程、进程或服务。
- 背压:下游处理能力不足时限制上游生产的机制。
- 有界队列:容量有明确上限的队列。
- 无界队列:逻辑上不设固定上限的队列,实际受内存限制。
- BLOCK:满队列时阻塞生产者。
- DROP_OLDEST:满队列时丢弃最旧元素。
- DROP_NEWEST:满队列时拒绝新元素。
- ROI:Region of Interest,感兴趣区域。
- \(\lambda_p\)、\(\lambda_c\):生产速率和消费速率,单位为帧/秒。
延伸阅读
- Python
queue、C++ 并发队列和生产者—消费者模型文档。 - 目标相机 SDK 的采集阻塞、丢帧和缓冲回收说明。
- 工业控制系统对漏检、延迟、追溯和安全停机的业务规范。
- 多线程程序的锁顺序、超时、异常传递和生命周期管理规范。
第100问 程序应该如何记录事件?工业现场实际需要哪些日志(错误、警告、逐帧结果、生产统计)?
模块:工业视觉系统的可观测性、追溯与运维
日志系统要同时服务于实时运行、故障定位、质量追溯和长期统计。每帧都保存完整原图与调试信息,通常会迅速耗尽存储;只保留最终 OK/NG,又无法解释边界判定和现场异常。本题建立分层日志架构,定义每帧结果字段,估算不同留存策略的容量,并说明日志如何支持 OEE、报警审计和故障重建。
日志分层与事件记录
一套可用的工业视觉日志至少应回答:某一帧何时采集、来自哪台相机和哪件产品;使用了哪个模型、阈值和配置;各阶段耗时如何;最终判定是什么;为什么触发报警;当时的图像、结果和设备状态是否仍可追溯。
这些问题对应不同数据粒度。实时控制需要短小、低延迟的事件;故障分析需要带上下文的警告和错误;质量追溯需要按帧关联图像和结构化结果;班次与设备管理需要聚合统计。把所有信息写成同一种字符串,会降低查询能力并扩大存储量。
日志设计还要先区分事实、推断和人工处置。采集时间、帧序号和推理耗时属于系统事实;低置信度是依据阈值计算出的状态;误检确认则可能来自人工复核。三者应使用不同字段保存,避免把事后结论覆盖原始判定。时间同步和时钟漂移也要纳入设备状态,跨设备关联时应保留原始时间戳与统一时间戳。
日志写入失败不能改变视觉判定的含义。对必须发送给控制器的结果,应把发送成功、超时、重试和最终确认分开记录;对可延后写入的调试数据,可以采用采样和降级。任何因日志压力导致的丢弃,都要有计数和时间窗口。
推荐把事件采集、等级判断、异步写入、留存和统计分开:
- 事件采集层:接收采集、预处理、推理、后处理、通信、温度和设备状态事件。
- 等级层:按 DEBUG、INFO、WARNING、ERROR 分级,决定字段和保存策略。
- 异步写入层:用有界队列、批量写入和后台线程减少对实时处理的阻塞。
- 关联层:按帧、工件、班次和报警编号关联图像、结果与统计。
- 留存层:本地轮转、数据库或文件服务器、仪表板和备份分别承担不同查询与保存周期。
下图给出这些组件之间的关系。阅读时先从“事件捕获”沿箭头检查一条事件如何进入等级判断,再检查它是否会阻塞实时链路,最后确认每种数据的留存位置和生命周期。
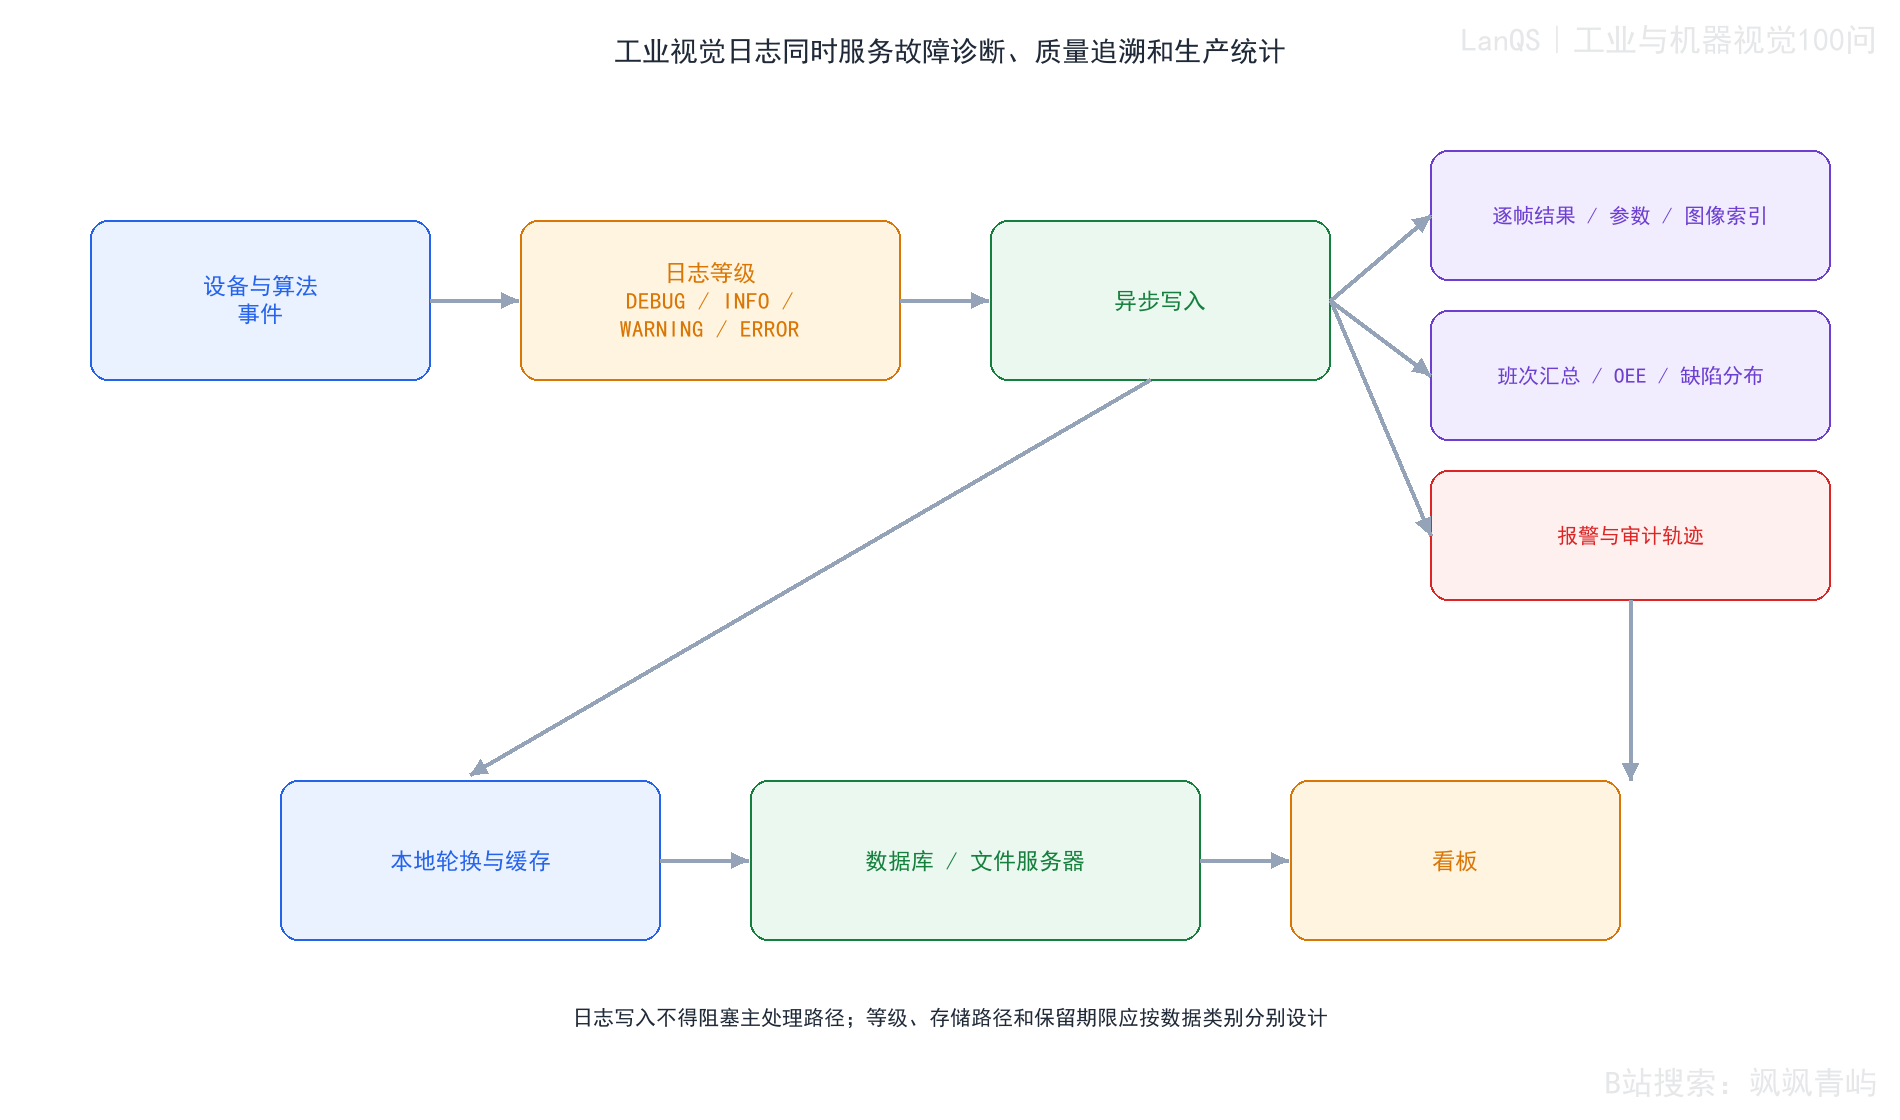
图100-1 工业视觉日志、统计与留存架构
ERROR 日志的最低字段
错误日志至少应包含时间戳、设备与工位、相机或服务标识、错误码、可读消息、触发操作、相关帧或工件编号、关键参数、异常堆栈或驱动返回值、系统采取的恢复动作以及最终状态。相机断线、模型加载失败、推理异常、通信超时和磁盘写满应使用不同错误码,不能都写成一条“程序异常”。错误记录还应带关联 ID,使它能追到对应的帧结果、报警审计和重启记录。
错误日志的目标是说明发生了什么、影响了哪些对象、系统做了什么以及是否恢复。只记录错误字符串,无法判断是一次可重试超时,还是已经导致整批产品未检测。参数上下文要避免写入敏感信息,但应保留足以复现问题的版本、输入尺寸、队列深度和状态码。
| 等级 | 典型内容 | 建议留存 |
|---|---|---|
| DEBUG | 中间张量摘要、详细计时、调试图和算子诊断 | 仅调试窗口或短期留存 |
| INFO | 启停、配置加载、正常统计、关键状态变化 | 按班次或周期留存 |
| WARNING | 低置信度、边界样本、队列接近上限、温度偏高、重连 | 与相关帧或时间窗关联 |
| ERROR | 推理失败、相机断线、通信失败、磁盘写满、服务崩溃 | 强制保存并审计 |
等级不应只由程序员临时决定。应为每个等级定义字段、采样率、图像保存规则、轮转周期和报警动作。低置信度或边界样本常适合保留缩略图和结构化结果;ERROR 通常需要保留原图、完整配置上下文和异常堆栈。
等级之间还要有升级关系。例如队列接近上限可以先产生 WARNING;若持续超过时间阈值或发生丢帧,则升级为 ERROR;恢复后应记录恢复事件和恢复时间。等级升级应包含去抖和重复抑制,避免同一故障每帧写出一条相同错误,同时保留发生次数和首次、最后一次时间。
逐帧记录、统计与容量
每帧记录建议包含以下字段:
- 时间:采集时间、处理开始和结束时间,统一时区或使用明确的 UTC 偏移。
- 身份:设备编号、相机编号、生产线、工位、工件编号和帧序号。
- 版本:软件版本、模型版本、配置版本、标定版本和引擎版本。
- 输入:图像尺寸、像素格式、曝光、增益、触发计数或 ROI。
- 结果:类别、置信度、缺陷位置、测量值、阈值和最终 OK/NG 判定。
- 性能:采集、预处理、推理、后处理、通信和写盘耗时。
- 状态:温度、内存、队列深度、功耗模式、接口错误和重连次数。
- 关联:原图或缩略图路径、报警编号、班次编号和审计事件编号。
字段名称和单位必须固定。时间戳不能一部分使用本地时间、一部分使用设备启动后的相对秒数;坐标必须写明像素坐标、标定后的物理坐标或 ROI 局部坐标。
字段还应规定精度和枚举的演进方式。置信度应记录原始浮点值以及阈值版本,测量值应带单位和标定版本,缺失值应使用统一的 null 或状态码,不能把 0 当成“没有测量”。当模型输出类别发生变化时,旧记录仍应能按模型版本解释,禁止用新类别表覆盖历史含义。
对于图像路径,应记录保存介质、相对路径、校验值和可用期限。路径存在不等于图像可恢复;归档迁移后仍要能由结构化记录解析到新位置,或者保留明确的迁移映射。
如果一帧没有检测框,也应把 detections 记录为空数组,并保留阈值、模型版本和判定状态;如果推理失败,则应使用明确的 processing_status 和错误编号,不能把失败结果写成低置信度 OK。这样才能在统计中区分“检测到正常产品”“检测到缺陷”和“没有完成检测”。
推荐使用 JSON、数据库表或其他可查询的结构化格式,并把大图作为外部对象,通过稳定路径或对象键关联。一个每帧结果可以包含:
{
  "timestamp": "2026-06-13T14:38:20.123+08:00",
  "frame_id": "F20260613-143820-000231",
  "product_id": "P-240613-0185",
  "station_id": "ST-02",
  "camera_id": "CAM-RIGHT",
  "recipe_id": "RECIPE-A3",
  "image": {
    "width": 2448,
    "height": 2048,
    "format": "Mono8",
    "exposure_us": 9000,
    "gain_db": 3.0
  },
  "result": {
    "decision": "NG",
    "confidence": 0.91,
    "defect_type": "SCRATCH",
    "bbox": [812, 564, 96, 18]
  },
  "timing": {
    "capture_ms": 4.8,
    "preprocess_ms": 2.1,
    "inference_ms": 23.7,
    "postprocess_ms": 1.9,
    "total_ms": 32.5
  },
  "artifacts": {
    "raw_image": "images/Q100/ng/20260613/F20260613-143820-000231.png",
    "overlay_image": "images/Q100/overlay/20260613/F20260613-143820-000231.png"
  }
}
示例中的 frame_id、product_id、station_id、recipe_id 和图像路径用于跨表、跨文件和跨系统关联;bbox 明确表示像素坐标;曝光、增益和各阶段耗时的单位在字段名或结构中写明。实际项目还应规定字段是否必填、缺失值如何表示、枚举值如何演进以及版本升级时如何兼容旧记录。
日志与图像存储容量算例
下面按源算例的假设估算容量:相机 30 帧/秒,每天运行 16 小时,因此每天帧数为
假设 NG 帧占 3%,低置信度或边界帧另占 2%,两者不重叠,因此需要详细留存的帧占 5%。分层文本日志按普通帧约 220 bytes、详细帧约 1,800 bytes 估算;详细帧图像按约 2,200 KB/帧估算,普通帧不保存原图。再加上错误、告警和统计记录,源算例得到:
容量计算还采用以下固定输入:每天 40 条 ERROR、每条 400 bytes;每天 220 条 WARNING、每条 300 bytes;每分钟一条生产统计、每条 500 bytes;DEBUG 每帧覆盖采集、预处理、推理和后处理 4 个阶段,每条追踪记录 350 bytes。DEBUG 全量方案为每帧写 1,800 bytes 的详细结果和 4 条阶段追踪,并保存每帧图像;分层方案只对 5% 的详细帧保存这些内容,其余帧写 220 bytes 的摘要。
| 项目 | 分层留存 | DEBUG 全量留存 |
|---|---|---|
| 文本日志 | 约 493.3 MB/天 | 约 5,274.0 MB/天 |
| 图像 | 约 181.756 GB/天 | 约 1,552.575 GB/天 |
| 30 天合计 | 约 5,452.68 GB | 约 46,577.25 GB |
分层方案的文本量可按“详细帧数 × 1,800 bytes + 普通帧数 × 220 bytes”复核;DEBUG 方案还为每帧保留约四类额外调试记录,每类约 350 bytes。图像部分按详细帧数乘 2,200 KB 估算,DEBUG 方案则按 NG 图像 2,200 KB、普通图像 900 KB 的混合大小估算。这里的图像大小属于容量规划假设,应在目标格式、质量参数和实际缺陷分布下复测。
图100-2用对数纵轴展示两种方案的日容量和 30 天容量。对数轴适合同时显示 MB 与数十 TB 量级;读图时必须先看单位和留存周期,不能把日容量直接当作月容量。
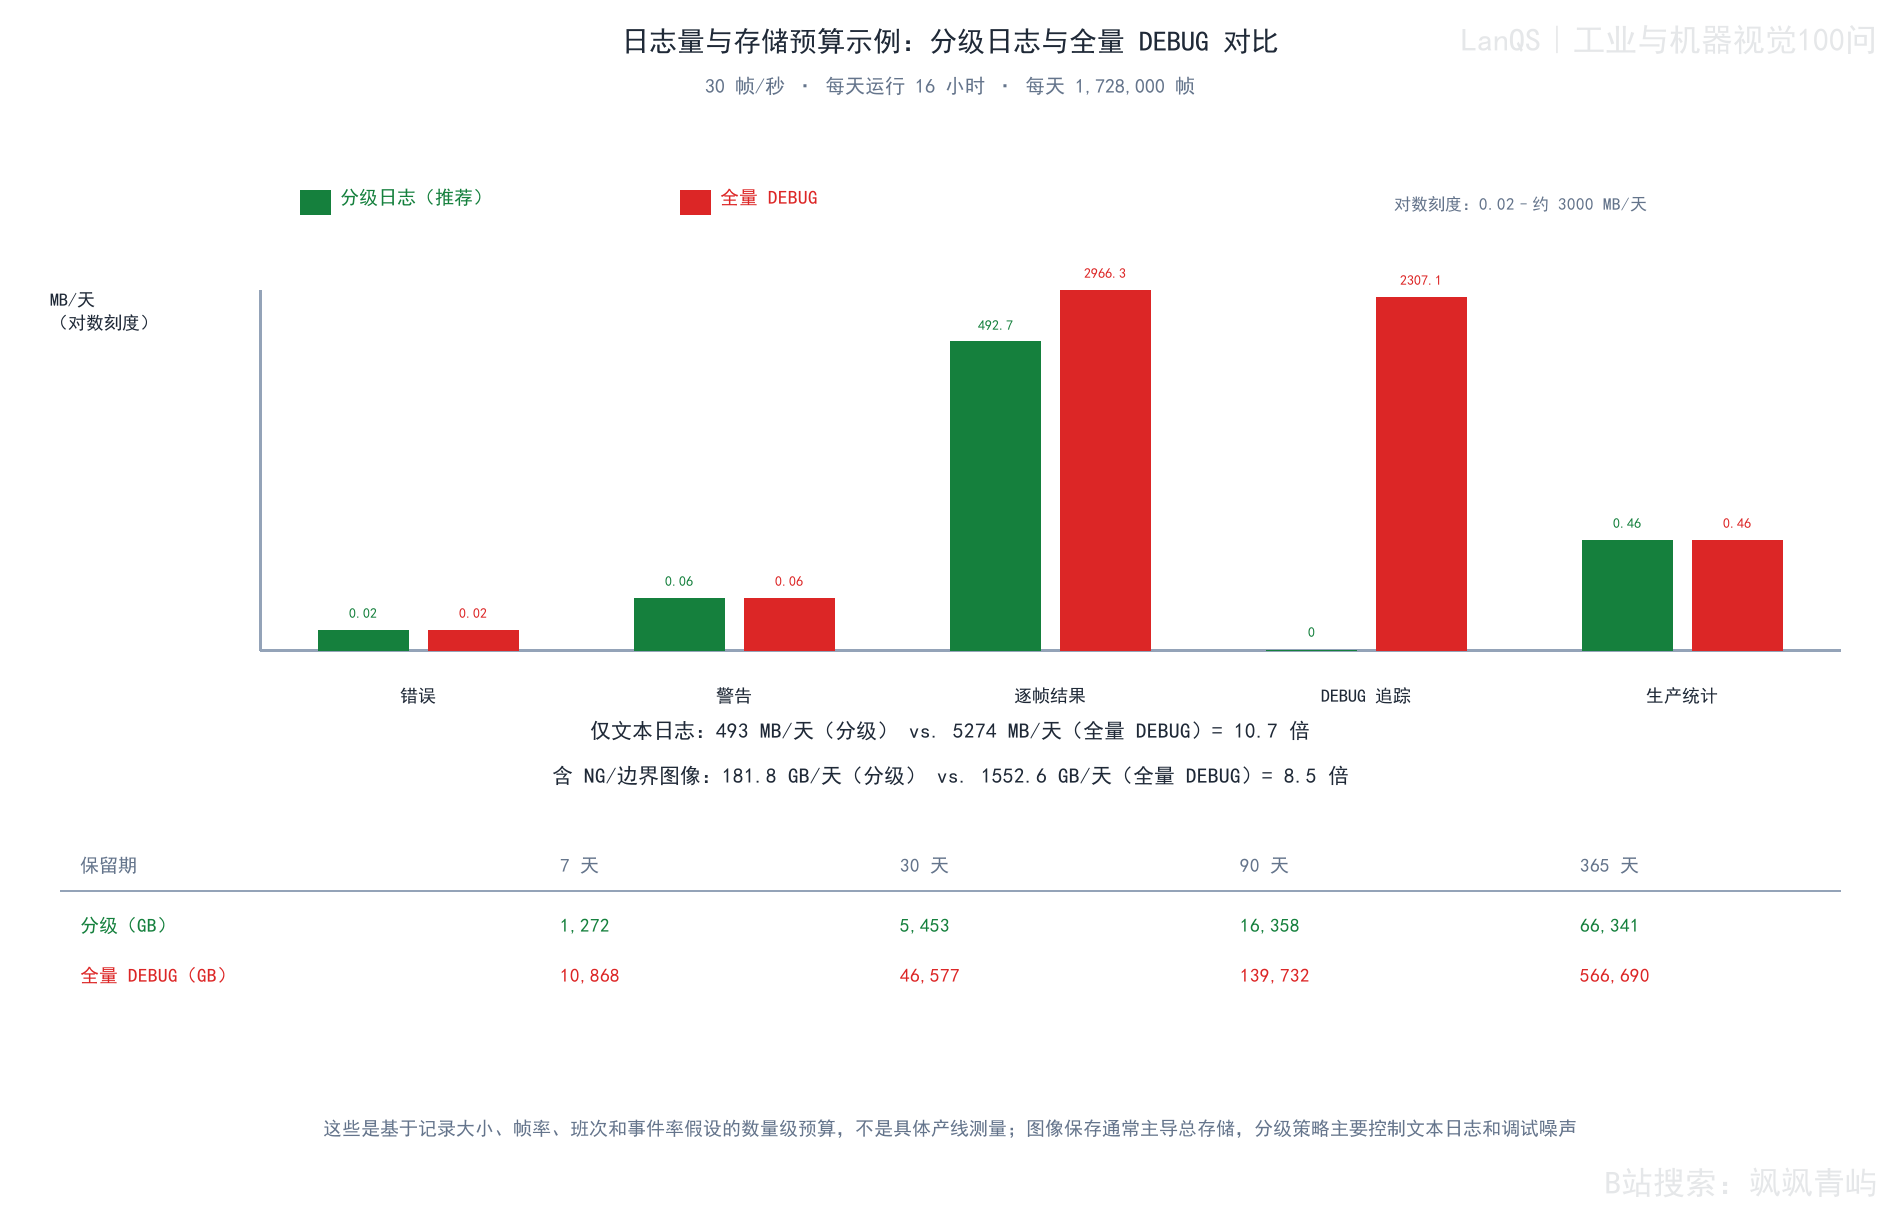
图100-2 分层留存与 DEBUG 全量留存的容量预算
统计窗口必须定义边界:班次交接时采用哪个时间、跨午夜如何归属、设备停机是否从计划时间扣除、未处理帧是否进入总数量。统计程序应保存原始计数和派生比例,避免日后更换公式后无法重算。对人工复核结果,还要保留复核时间、人员和复核依据。
数据仪表板可以展示趋势,但不应成为唯一数据源。图表应能回溯到原始事件或聚合批次,且显示当前模型、配置和时间范围。
班次统计不应只保存最终合格率,还应包括总帧数、OK/NG 数、低置信度数、未处理或丢帧数、平均与尾部处理时延、相机重连、通信失败、停机时间和人工复核结果。统计记录应关联设备、工位、班次、模型版本和配置版本,避免换班或换模后无法解释指标变化。
报警审计至少应记录报警开始时间、结束时间、触发条件、相关帧、设备状态、操作员确认、恢复动作和最终原因。若报警由队列溢出触发,应同时记录队列深度和丢弃策略;若由低置信度触发,应保留阈值和模型版本。
OEE(Overall Equipment Effectiveness,设备综合效率)通常写为
其中可用率、性能和质量分别为
\(T_{\mathrm{plan}}\) 是计划生产时间,\(T_{\mathrm{run}}\) 是实际运行时间,\(N_{\mathrm{out}}\) 是产出数量,\(T_{\mathrm{ideal}}\) 是理想单件周期,\(N_{\mathrm{good}}\) 是合格数量,\(N_{\mathrm{total}}\) 是总数量。视觉系统应把停机、节拍下降、NG、未检测和人工复核分别记录,避免把缺陷、漏检和设备停机混在一个比例里。
OEE 是运营指标,不能替代视觉模型准确率。它能帮助定位时间损失、速度损失和质量损失,但不能单独证明模型没有漏检;模型评估仍需要独立的标注数据和混淆矩阵。
存储、备份与长期价值
本地磁盘应设置按时间、文件大小或事件数量轮转的规则,并预留最低可用空间。磁盘写满时,系统要优先保护 ERROR 和报警数据,明确哪些 DEBUG 或普通图像可以删除。文件命名和目录结构应包含日期、设备、工位或批次,跨文件和跨系统的关联仍依赖结构化索引。
长期归档可以使用数据库、文件服务器或对象存储。归档记录应带校验值、写入时间、来源版本和恢复测试结果。备份策略要规定保留周期、跨设备副本、访问权限和删除审计;仅“复制过文件”不等于已经验证可恢复。
断电保护是异步日志的边界条件。关键事件可以采用同步落盘、独立电源或带事务的存储;普通事件可以接受最近一个批次丢失,但必须在启动后记录上次非正常关闭。写入线程恢复时应校验半写文件、重复批次和损坏索引,避免把不完整记录提供给追溯查询。
日志写入、图像压缩和网络上传可能产生不可预测的 I/O 延迟,建议通过独立线程或服务异步处理,并使用有界队列。队列满时应按日志等级降级:普通 DEBUG 可采样或丢弃,关键 ERROR 应同步落盘或进入独立高优先级通道。任何降级都要计数并报警,否则日志缺失本身会变成不可见故障。
批量写入可减少系统调用,压缩可降低带宽和存储,但会增加 CPU、延迟和故障时的未落盘数据量。批量大小、刷新周期和断电保护应通过现场测试确定。
最终验收可以用一次完整演练确认闭环:制造一帧正常样本、一帧 NG、一帧低置信度样本和一次相机断线,检查它们是否能在日志、图像、报警审计和班次统计中互相关联;随后升级一个配置版本并重放样本,确认历史记录仍按旧版本解释。只有当查询、恢复和重放都成功,日志设计才具备现场运维价值。
发生异常后,可以按以下顺序重建现场:
- 用设备、工位、时间窗口和报警编号定位事件。
- 按帧序号或工件编号关联原图、缩略图、结构化结果和模型版本。
- 对齐采集、预处理、推理、通信和写盘时间,区分处理慢与等待慢。
- 检查温度、内存、队列、接口错误和重连记录,判断是否存在资源或硬件诱因。
- 用同版本模型、同配置和同输入重放,记录重放环境和差异。
- 将根因、处置动作、人工确认和最终结论写回报警审计。
日志系统的最终价值在于让一帧结果、一次报警、一班统计和一次软件升级能够互相解释。字段稳定、版本可追溯、容量可控和恢复可验证,是长期运行的基本条件。
常见误区
- 每帧永久保存原图和全部 DEBUG 信息,未做容量预算和轮转。
- 只记录 OK/NG,不记录阈值、模型版本、置信度和边界状态。
- 使用不可查询的自由文本,导致帧、工件、报警和班次无法关联。
- 让日志写盘和图像压缩直接阻塞实时推理线程。
- 磁盘写满后静默丢弃关键 ERROR,或没有记录日志降级次数。
- 用 OEE 代替模型准确率评估,混淆设备效率与检测质量。
- 备份后从未做恢复演练,无法确认归档数据真实可用。
术语与符号表
- DEBUG:调试级日志,信息最详细,通常短期留存。
- INFO:正常运行和状态变化日志。
- WARNING:需要关注但系统仍可运行的异常或边界状态。
- ERROR:导致功能失败、需要报警或人工介入的错误。
- OEE:Overall Equipment Effectiveness,设备综合效率。
- (A):可用率。
- (P):性能指数。
- (Q):质量指数。
- \(T_{\mathrm{plan}}\):计划生产时间。
- \(T_{\mathrm{run}}\):实际运行时间。
- \(N_{\mathrm{out}}\):产出数量。
- \(T_{\mathrm{ideal}}\):理想单件周期。
- \(N_{\mathrm{good}}\):合格数量。
- \(N_{\mathrm{total}}\):总数量。
- 结构化日志:字段、类型和单位固定,可被程序查询和统计的日志。
- 轮转:按时间、大小或数量关闭旧日志并创建新日志的机制。
延伸阅读
- 结构化日志、JSON Schema、时间戳和版本兼容规范。
- 目标数据库、文件服务器或对象存储的轮转、校验与备份文档。
- 工业设备 OEE、停机分类和报警审计规范。
- 视觉模型验证、数据集追溯和软件配置管理规范。