第81问 工业视觉系统如何管理软件版本和参数配置文件?
模块:软件工程、系统架构与项目交付
一条视觉产线出现漏检时,现场通常先问“最近改了哪段代码”。这个问题常常不够用。相机 SDK、驱动、图像处理库、深度学习框架、推理运行时、PLC(Programmable Logic Controller,可编程逻辑控制器)通信组件、业务代码、模型权重和工位配置,都会参与一次检测。工程师还可能在调试时改过曝光、增益、阈值或剔除延时。即使 Git 中的代码提交号没有变化,实际运行的系统也可能已经换了状态。本题讨论如何把这些共同影响检测结果的对象组织起来,使系统可以追溯、验证、回退,并让下一位工程师知道现场参数为什么这样设置。
版本与配置管理的基本结构
工业视觉软件比一般业务软件更难追溯,原因来自两方面。一方面,运行环境由许多异构依赖叠加而成。相机 SDK 负责调用相机接口,驱动负责让操作系统与硬件通信,图像库负责处理像素,深度学习框架和推理运行时负责模型计算,PLC 通信组件负责把检测结果送给产线控制,业务代码再把这些结果组织成放行、报警或剔除动作。任意一层升级,都可能改变最后的检测结果。
另一方面,现场参数彼此耦合。曝光时间决定传感器接收光子的时间,增益会放大信号和噪声,白平衡会改变颜色通道,触发模式决定采图时刻,光源强度影响图像对比度,ROI(Region of Interest,感兴趣区域)影响参与计算的像素范围,阈值和模板尺寸影响判定,剔除延时则影响检测结果对应到哪一个工件。这些参数在配置界面上可能属于不同模块,但现场调整一个参数时,常常需要重新检查其他参数。例如提高曝光可能使图像变亮,也可能造成反光区域饱和;为了补偿亮度而调整增益,又会改变噪声水平。参数之间的关系必须留在配置记录和验证记录中,不能只依靠调试人员的记忆。
因此,“一个版本”不能只用一个代码提交号表示。Git 是分布式版本控制系统,它能记录源代码的提交历史,却不会自动告诉你工位加载了哪个模型权重、使用了哪一份配置,或者当天的 CUDA(Compute Unified Device Architecture,NVIDIA 的并行计算平台)和驱动是什么版本。两个工位运行相同的代码提交,也可能因为模型权重被替换、配置文件被手工修改、自动曝光被重新打开,或者运行环境不同而得到不同结果。
为了表达一次可复现的系统状态,可以把它记录为四元组:
这里的四个量分别表示有顺序关系的版本标识,不参与物理量的相加或相乘。\(V_{\mathrm{code}}\) 表示业务程序版本,\(V_{\mathrm{model}}\) 表示模型或传统视觉模板版本,\(V_{\mathrm{config}}\) 表示参数配置版本,\(V_{\mathrm{env}}\) 表示操作系统、驱动、运行时和设备镜像组成的环境版本。它们没有物理单位,通常由提交号、不可变标签、文件哈希或镜像摘要表示。
式(81-1)要回答的是“当时到底运行了哪一个系统状态”。如果只保存 \(V_{\mathrm{code}}\),只能知道程序文本属于哪次提交,不能排除另外三个坐标发生变化。只有四个坐标一起记录,才有条件重建过去的检测结果。这个四元组能证明版本对象已经被完整指认,不能单独证明系统一定检测正确,也不能替代固定样本、现场节拍和光照条件下的验证。
版本对象适合按变化频率和故障影响范围分成三层。第一层是基础环境层,包括操作系统、硬件驱动、GPU 运行时和相机 SDK。它直接影响设备能否采图、数据如何进入程序以及加速计算如何执行,通常应少改动,并通过容器镜像、标准化工业计算机镜像或金样机镜像冻结。工业计算机常简称 IPC(Industrial Personal Computer,工业计算机),它可能长期运行在现场,因此需要有可恢复的镜像版本,而不能只依赖某位工程师记得曾经安装过什么。
第二层是算法与框架层,包括 OpenCV(Open Source Computer Vision Library,开源计算机视觉库)、PyTorch(深度学习框架)、ONNX Runtime(用于执行 ONNX 模型的推理运行时)、厂商视觉库以及相关推理配置。依赖版本应写入环境清单或锁定文件。锁定文件的作用是把“当前能安装到的版本”变成“本次发布明确使用的版本”,避免重新安装时自动取得另一套依赖。
第三层是业务与配置层,包括检测流程、界面逻辑、模型权重、阈值和工艺参数。它离现场最近,变化也通常最频繁,所以每次发布都应绑定变更原因、验证范围和回退包。三层分开管理,是为了缩小排障范围。采图在相机 SDK 升级后失败,应该先查基础环境层;误检随曝光和阈值一起变化,则应先查配置和发布记录。问题属于哪一层,会影响应当回退哪一层,以及回退后要重新验证哪些结果。
图 81-1 先给出层次关系,再读配置文件如何挂接到发布记录。读图时可以问两个问题:哪些对象变化慢,哪些对象随现场发布变化;一份配置文件除了参数文本,还需要和什么信息绑定?
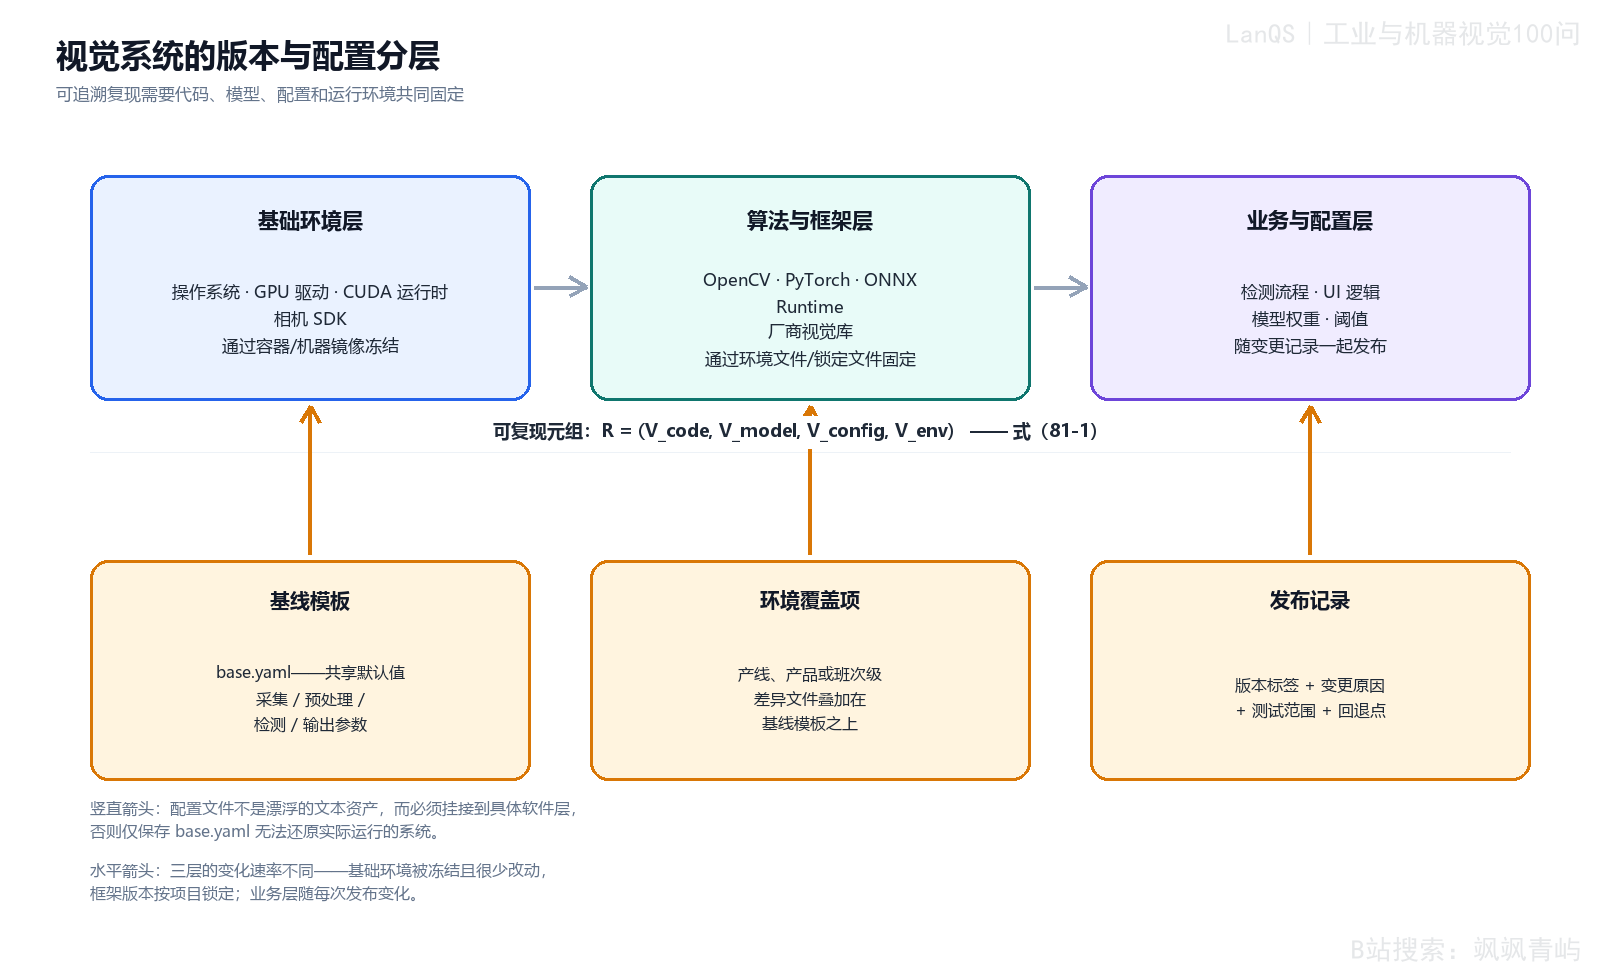
图 81-1 视觉系统的环境、算法与框架、业务配置及发布记录分层
图中上排的三个框表示软件依赖层,箭头表示它们在运行时相互依赖。基础环境层变化最慢,算法与框架层按项目锁定,业务与配置层则随版本发布和现场变更更新。下排的基线模板、环境覆盖项和发布记录说明配置的组织方式:基线保存共享默认值,覆盖文件只保存产线、产品或班次的差异,发布记录保存版本标签、变更原因、测试范围和回退点。竖向箭头提醒读者,配置不能脱离具体软件层和发布状态单独保存。只拿到 base.yaml,却不知道它与哪个代码、模型和环境配对,仍然无法完整重建当时运行的系统。图示表达的是管理框架,基础环境究竟用容器、虚拟环境还是整机镜像冻结,要根据现场工控机的维护方式和客户 IT 条件决定。
应用代码、环境清单和基线配置模板属于文本资产,适合放入普通 Git 仓库,因为它们便于比较差异,提交历史也能成为审计轨迹。基础环境一般不以操作系统安装过程的逐行差异保存,而是构建成带标签的容器镜像或金样机镜像,并在发布记录中保存镜像标签或摘要。
模型权重是另一类资产。检测或分类模型的权重文件可能从几十 MB 到数 GB,反复提交到普通 Git 仓库会使仓库膨胀、克隆变慢。Git LFS(Large File Storage,大文件存储)会在 Git 中保留轻量指针,把实际二进制文件放在 LFS 存储中;模型或制品仓库则专门管理权重、镜像等构建产物,并可控制谁有权限把新权重提升到生产环境。无论采用哪一种方式,发布记录都应保存精确权重文件的内容哈希或不可变版本标签,并与代码提交号、配置版本一起记录。best.pt 或 final.onnx 只是文件名,不能作为唯一身份。
参数文件需要同时满足三件事:程序能稳定解析,工程师能读懂,版本系统能清楚显示差异。YAML(YAML Ain't Markup Language)、JSON(JavaScript Object Notation)和 TOML(Tom's Obvious, Minimal Language)都可以满足这些要求。工程师经常手工维护时,YAML 的层次结构较直观;配置主要由程序生成和严格解析时,JSON 也很合适。格式本身不是决定因素,字段的组织和命名才会直接影响调试。
一份配置可按采集、预处理、检测、输出和现场联锁分组。采集组放曝光、增益、白平衡和触发方式,预处理组放滤波、归一化等图像处理参数,检测组放阈值、模板尺寸或分类阈值,输出组放图像保存和结果输出,联锁组放与产线停机或剔除有关的参数。这样组织后,工程师能先把现场现象定位到一组参数,不必在一个平面键值表中逐项猜测。
字段名应同时说明含义和单位。exposure_us 比 exp 更明确,reject_delay_ms 比 delay2 更容易在现场复核。带单位的数值必须在键名中体现单位,避免同一文件混用 ms、μs 和 s 却没有标识。布尔开关也应表达实际动作,例如 enable_auto_gain 表示是否启用自动增益,save_ng_image 表示是否保存不合格图像;flag1 无法告诉维护人员打开后会改变什么。
当多条产线或多种产品共用一套程序时,适合采用“模板 + 覆盖”结构。基线模板保存共享配置,差异文件只保存某条线、某种产品或某个班次的变化,加载时先读取基线,再按书面规定的顺序应用覆盖。典型目录可以写成:
configs/base.yaml
configs/overrides/line_03.yaml
configs/overrides/product_A.yaml
configs/overrides/night_shift.yaml
合并顺序必须写进项目文档,因为同一个字段在多个覆盖文件中出现时,后应用的文件会决定最终值。共享默认值变更时只改 base.yaml,产线调试时只改对应覆盖文件。这样既能看到一条线的差异,也能避免把完整配置复制到十几个目录后逐渐漂移。
变更追踪、验证与复现
配置文件应和代码一起进入版本控制,也可以使用具有同等审计能力的独立配置仓库。每次配置变化至少要能够回答三个问题:谁改了什么,为什么改,改完在哪些样本和现场条件下验证过。记录还应注明影响范围和回退依据。没有这些信息,后来即使看到文本差异,也无法判断这个变化是否与误检或漏检发生在同一时间窗口内。
参数的数值变化可能对应离散的图像结果。比如二值化阈值从 118 改为 112,看起来只是减少了 6 个灰度级,但它可能改变缺陷区域在二值图中是否连通,进而改变后续面积判断和误剔结果。变更记录至少应保留测试样本范围、修改目的和回退版本,不能只保存“118 改成 112”这一行差异。
变更控制还要能适应调试现场。把所有改动都放进缓慢的正式审批链,调试人员可能为了赶上调试窗口而直接在工位手改文件,最后现场状态和系统记录不一致。更实际的做法是设置两条路径:对调试阶段的低风险、可逆参数,允许快速调整,但在事后补齐轻量记录;涉及放行或剔除逻辑、联锁,或者需要同步到多个工位的变化,进入正式评审和受控发布。快速路径的前提是可回退、可记录,不能成为永久绕过版本管理的入口。
从版本四元组重建一次事故
假设某条线从上周二开始漏检率上升,调查窗口内出现过 3 个代码提交、2 个模型文件、5 个配置版本和 2 个基础镜像。这些数字是为说明计算方法而设置的示例数,不是任何真实部署的测量结果。若只知道四元组中的一部分坐标,仍有多个历史系统状态符合现象。把尚未确定的候选数相乘,就能得到剩余可能状态数:
| 已确定的维度 | 计算 | 仍可能的历史系统状态数 |
|---|---|---|
| 尚未确定任何维度 | \(3\times2\times5\times2\) | 60 |
| 已确定 \(V_{\mathrm{code}}\) | \(2\times5\times2\) | 20 |
| 已确定 \(V_{\mathrm{code}},V_{\mathrm{model}}\) | \(5\times2\) | 10 |
| 已确定前三个维度 | \(2\) | 2 |
| 四个维度全部确定 | \(1\) | 1 |
这个算例的代码逻辑是:把每个坐标的候选数放入字典,依次假定前 \(k\) 个维度已经确定,再对剩余候选数做乘法。完整确定四个坐标后,程序断言剩余状态数必须为 1。用伪代码表示如下,变量 states[k] 表示确定前 \(k\) 个维度后仍需排查的状态数:
candidates = {
    "V_code": 3,    # 一周内部署过的代码提交数
    "V_model": 2,   # 一周内实际推送过的权重文件数
    "V_config": 5,  # 阈值和曝光调参形成的配置版本数
    "V_env": 2,     # 轮换使用的基础镜像数
}

dims = ["V_code", "V_model", "V_config", "V_env"]
counts = [candidates[name] for name in dims]
states = []
for k in range(len(dims) + 1):
    total = 1
    for count in counts[k:]:
        total *= count
    states.append(total)

print(states)       # [60, 20, 10, 2, 1]
assert states[-1] == 1
只知道代码版本时,仍有 20 种候选状态,原因是模型、配置和环境仍分别有 2、5、2 个候选值。四个维度都锁定后,组合数才收敛到 1。图 81-2 左侧使用对数坐标显示这种收缩,右侧对应实际追溯时应当查找的记录。
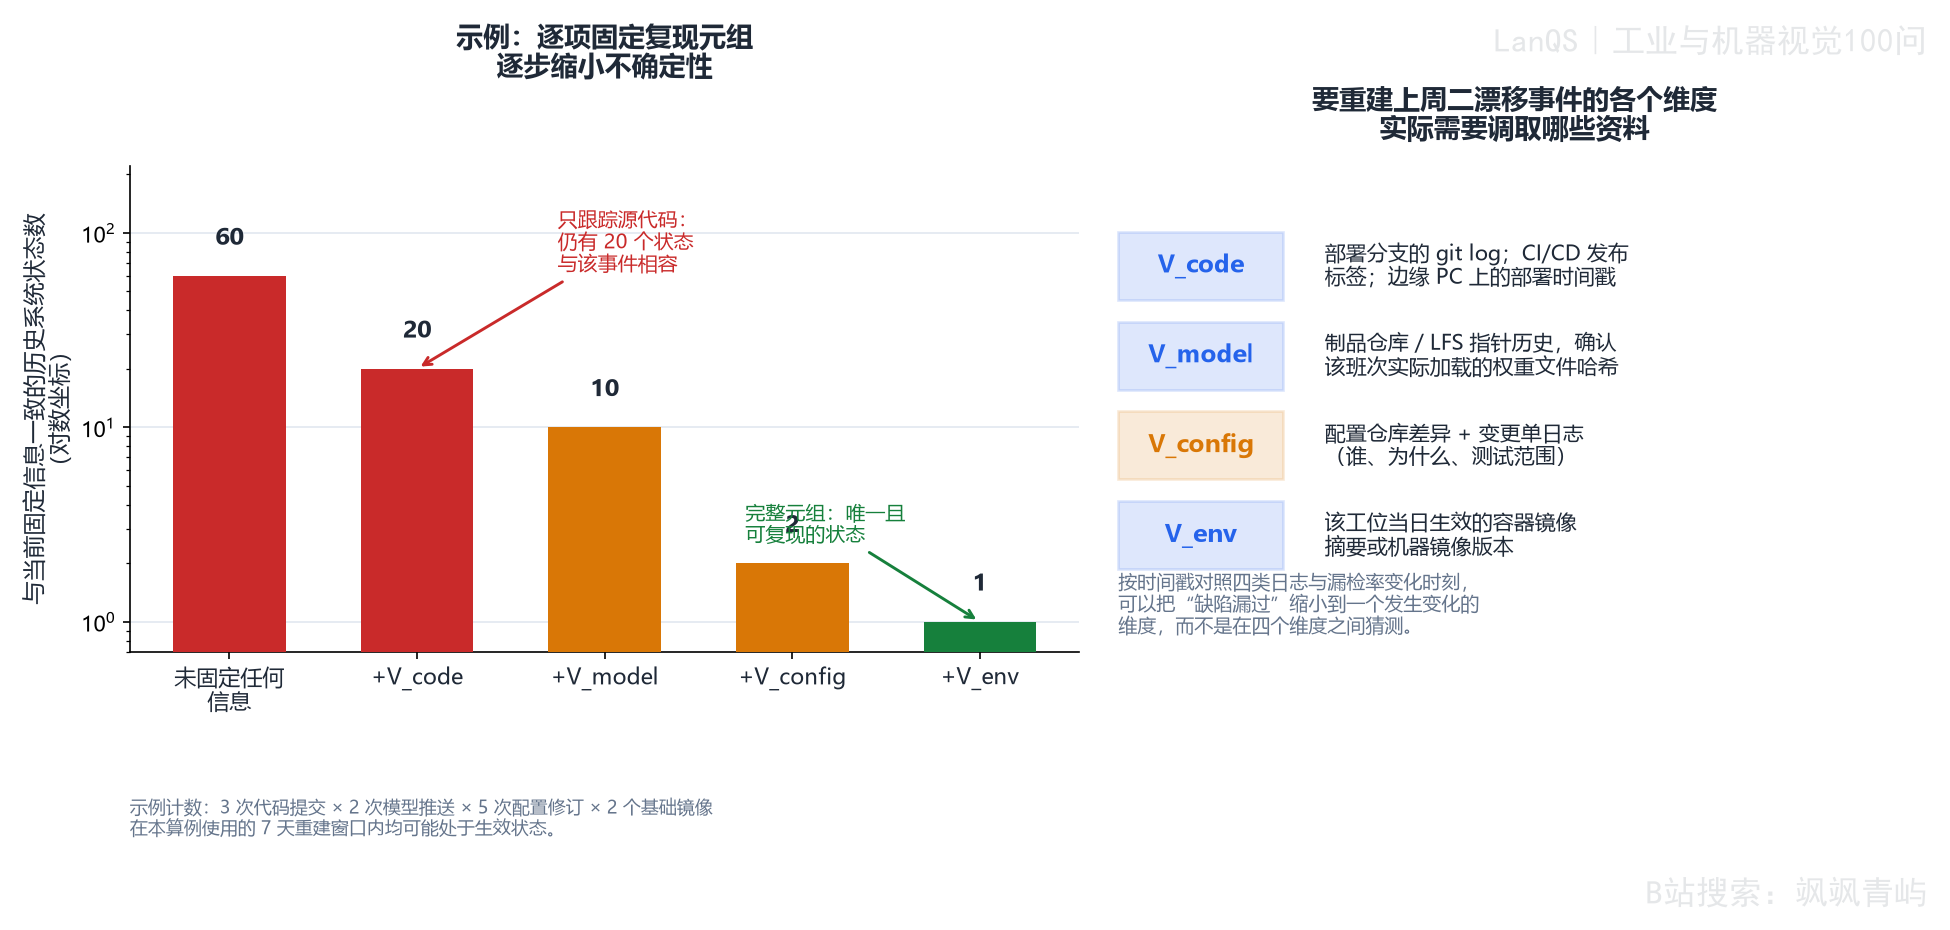
图 81-2 从候选版本组合到唯一可复现系统状态的算例
读图时,左侧柱形的高度表示在当前已知条件下还剩多少种可能状态,纵轴采用对数坐标,因此 60、20、10、2、1 的差异不会被压在同一条线附近。右侧把四个坐标与记录来源对应起来:代码查部署分支的 Git 日志、CI/CD(持续集成与持续交付)发布标签和边缘工控机部署时间;模型查制品仓库或 Git LFS 指针历史,确认当班实际加载的权重哈希;配置查配置仓库差异和变更单;环境查容器镜像摘要或机器镜像版本。四类记录必须按时间与漏检率开始变化的时刻对齐,图中的唯一状态只表示版本组合被唯一指认,不能证明漏检一定由某一个坐标造成,还需要结合样本和现场测试验证因果关系。
实际事故重建时,可以沿着四个坐标分别取证。代码侧查看部署分支的 git log、CI/CD 发布标签和边缘工控机上的部署时间。模型侧查看制品仓库或 Git LFS 指针历史,确认受影响班次实际加载的文件哈希,而不是只查看最近上传的文件。配置侧比较配置仓库差异,并对照变更单确认谁在什么时间、因为什么目的做过修改,以及修改覆盖了哪些样本。环境侧确认当天该工位使用的容器镜像摘要或机器镜像版本,因为中途重装某台机器也可能在代码、模型和配置均未改动时改变 \(V_{\mathrm{env}}\)。把四类日志与漏检率变化时间交叉核对,才能形成可检验的变化判断,而不是在四个方向之间猜测。
调参前先冻结一份当前可工作的基线,并写明本轮要解决的现象。例如目标是降低反光工件的误剔,就应使用多个批次、不同反光程度的样本,而不是挑两三张看起来有代表性的图片。每次调整都应有明确目标,例如验证曝光变化是否改善缺陷对比度,或验证阈值变化是否减少误剔,同时记录对应的代码、模型、配置和环境版本。
验证至少分为离线和在线两个阶段。离线验证使用固定图像集,让不同参数版本在相同输入上比较检测率、误接受率、误剔率和边界样本表现。离线图像适合回答“这套参数对已保存样本产生了什么变化”,但它没有包含生产中的触发抖动、工件姿态变化和真实节拍。
在线验证需要把候选版本放回真实工位,检查节拍、触发同步、光照漂移、振动、工件姿态和光源温度变化。现场参数可能在机器升温、输送速度变化或批次切换后表现不同。离线通过只能说明固定样本上的结果满足当前比较条件,不能自动推出在线运行稳定,更不能替代回退验证和异常样本验证。发布记录应把离线结果、在线条件、采用的版本四元组和回退点放在一起。
模型、部署与团队协作
模型发布至少要记录网络结构、权重文件、训练数据、标注规范、输入分辨率、数据增强策略和训练配置。部署时还要记录模型输入尺寸、预处理方式以及叠加在模型输出上的阈值。只保留一个叫 best.pt 或 final.onnx 的文件,无法说明它由哪批数据训练、怎样标注、采用什么输入分辨率和阈值,也无法可靠重建过去的性能。
传统视觉方法没有神经网络权重,但同样存在模型资产。模板文件、标定文件、灰度参考图和几何检测基准都会影响检测结论,应和权重文件一样纳入版本管理。模型版本应与对应的代码和配置版本绑定发布,避免程序已经更新、权重仍停留在旧版,或者模型输入分辨率与预处理配置不匹配。发布记录中的权重哈希、训练集版本、验证结果和回退包,构成模型能够被复核的依据。
当同一视觉系统部署到多条产线、多台工位或多个工厂时,配置如果只散落在本地机器,很快就会失去可比性。集中管理平台应保存共享模板、站点覆盖项、发布记录和回退点。它不要求所有站点使用完全相同的参数,而是让每个站点的差异有明确来源,并能与基线直接比较。
远程部署应先在测试工位或金丝雀工位验证,再分批推送到生产工位。金丝雀发布是先让少量试点设备运行候选版本,再扩大范围的部署方式。推送过程中要保留旧版本和回退路径,确认新配置完整加载后再使其生效,避免代码、模型和配置只更新了一部分。涉及放行、剔除、停线或联锁的关键参数,应通过受控发布变更,不能允许普通账户在本地页面永久写入。配置一旦参与质量判定和生产动作,它就属于生产质量控制的一部分。
配置文档要把依赖个人经验的内容变成团队可以查询的记录。参数字典至少应说明字段含义、单位、有效范围、默认值和修改影响。对相互耦合的参数,还要说明耦合方向和验证方法。例如提高曝光后,为什么需要重新检查增益和高光饱和;缩小 ROI 后,计算量可能下降,但边缘缺陷是否仍在区域内需要重新确认。这样的说明让工程师知道参数改变后应观察什么,而不只是知道一个推荐数值。
知识库适合记录场景化案例。镜面材料换批后误剔增加,可以记录先检查光源角度和偏振设置;夜班漏检或误检上升,可以记录检查环境光变化。案例还应注明适用条件,避免把一次现场经验当成所有工位的固定规则。参数字典和案例库共同使用时,新工程师可以分辨哪些参数能由现场例行调整,哪些变化必须重新做离线和在线验证。
常见误区
- 代码提交号没有变化,就认为系统没有变化。模型、配置、驱动和运行时仍可能改变四元组的其他坐标。
- 把大型模型权重反复提交到普通 Git 仓库。应使用 Git LFS 或制品/模型仓库,并在发布记录中保存文件哈希或不可变标签。
- 使用
flag1、delay2等无法表达作用和单位的字段名。维护人员无法从字段名判断它影响采集、判定还是剔除。 - 把共享默认值复制到每条产线的完整配置中。模板加覆盖文件更容易比较差异,也更容易统一修改默认值。
- 正式审批过慢,现场工程师直接改机而不回填记录。低风险、可逆的调试变化可以走快速记录路径,影响放行逻辑或多个工位的变化仍需正式发布。
- 模型、代码和配置分别发布。三者未绑定时,即使每个对象各自有版本号,也可能组成无法复现的混合状态。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| \(R\) | 可复现系统状态的四元组,按顺序包含代码、模型、配置和运行环境版本。 |
| \(V_{\mathrm{code}}\) | 业务程序或应用代码版本。 |
| \(V_{\mathrm{model}}\) | 深度学习模型、传统视觉模板或其他检测资产的版本。 |
| \(V_{\mathrm{config}}\) | 参数配置文件及其覆盖关系的版本。 |
| \(V_{\mathrm{env}}\) | 操作系统、驱动、GPU 运行时、相机 SDK 和设备镜像组成的环境版本。 |
| 基础环境层 | 管理操作系统、驱动、GPU 运行时和相机 SDK 的层。 |
| 模板 + 覆盖 | 基线模板保存共享默认值,覆盖文件保存产线、产品或班次差异的配置方式。 |
| Git LFS | Git 的大文件存储扩展,在 Git 中保存轻量指针,把大型二进制文件放在独立存储中。 |
| 制品/模型仓库 | 保存模型权重、容器镜像等构建产物,并提供版本和权限管理的存储系统。 |
| 金丝雀发布 | 先在少量测试或试点工位验证,再分批推广到生产设备的部署方式。 |
| ROI | Region of Interest,感兴趣区域,表示参与处理或判定的图像区域。 |
| IPC | Industrial Personal Computer,工业计算机,指部署在现场执行视觉软件的计算机。 |
| SDK | Software Development Kit,软件开发工具包,提供调用相机或其他设备功能的接口和组件。 |
| PLC | Programmable Logic Controller,可编程逻辑控制器,用于接收检测结果并协调产线动作。 |
| CI/CD | Continuous Integration and Continuous Delivery,持续集成与持续交付,用于自动构建、测试和发布软件。 |
延伸阅读
- Sculley, D. 等,《Hidden Technical Debt in Machine Learning Systems》,NeurIPS,2015。讨论机器学习系统的可复现性不只取决于模型代码。
- Humble, J. 与 Farley, D.,《Continuous Delivery: Reliable Software Releases through Build, Test, and Deployment Automation》,Addison-Wesley,2010。介绍发布、环境一致性和回退管理。
- Git LFS 文档。用于了解模型权重等大型二进制文件如何与源代码协同版本管理。
- Sato, D.,《Canary Release》,martinfowler.com。介绍适用于配置和模型部署的分阶段、可回退发布方式。
第82问 现场人员可能误操作,工业视觉系统应该如何设计权限?
模块:软件工程、系统架构与项目交付
工业视觉系统往往同时连接相机、PLC(Programmable Logic Controller,可编程逻辑控制器)、机器人、剔除机构和生产数据库。操作员在屏幕上切换一个配方,可能改变下一批工件的判定阈值;维护人员在错误模式下写入一组标定值,可能让机器人或剔除机构使用错误坐标。权限设计要回答的不只是“谁能看到哪个按钮”,还要回答谁能发起动作、动作在什么状态下才允许执行、写入后如何确认已经生效,以及发生问题后能否追溯到具体的人和具体的版本。
权限设计与误操作防护的基本原则
工业系统中的误操作很少只是“按错一次按钮”。视觉系统处在采图、判定和设备动作组成的闭环中:相机获得图像,算法给出结果,PLC 或机器人据此控制输送、剔除、停线或下一步动作。一个看起来很小的界面操作,可能同时改变设备运动节拍、视觉判定逻辑和工艺状态。比如,工位在没有确认相机触发延时的情况下直接切换自动运行,整批工件可能错过视野;维护期间把测试配方发布到生产线,在线工件会立刻按照另一套放行阈值判定;在生产模式下写入标定参数,检测坐标或执行器坐标可能立即失效。
风险的大小取决于视觉系统在设备链中的位置。相机只提供观察画面时,误操作可能只是打开了错误窗口;检测结果一旦直接驱动剔除、停线或机器人动作,错误就会沿控制链传播。因而权限管理的对象应当是会改变设备状态、质量结论或安全边界的动作,而不只是 HMI(Human-Machine Interface,人机界面)上的按钮。
还要考虑动作的生效时机。参数写入可能发生在工件已经进入视野之后,PLC 已经发出触发但检测结果还没有返回;如果系统没有规定新配置从哪一个工件或哪一个周期开始生效,操作员无法判断当前结果使用的是旧配方还是新配方。权限设计应把运行模式、在途工件、配置版本和回退状态一起纳入系统状态机。权限控制保护的是动作发生的条件,时序控制则保护动作发生的时间,两者缺一都会留下误操作路径。
权限设计可以从四个原则开始。最小权限要求账户只拥有完成当前岗位任务所需的权限。操作员可以启停设备、复位报警和选择已批准配方,并不意味着他需要改阈值、换模型或写入标定值。权限范围越大,误触和误改的影响面越大,培训和审计也越难保持清楚。
职责分离把高影响动作拆开。例如,调试人员可以编辑阈值,另一位工程师负责复核,受控发布服务负责把通过验证的版本推送到生产。若一个账户既能编辑又能发布,而且不需要第二人确认,它就成为整个流程的单点失效位置。职责分离不要求每一个低风险动作都经过两个人,而是把复核放在会改变质量结论、联锁或多工位行为的节点上。
可审计性要求每次重要动作留下可检索的记录。至少要能查到身份、时间、工位、对象、前值、后值、来源和结果。只有日志能够还原一次变更,团队才知道问题发生前改了什么,也才能区分误操作、合法调试和设备自身故障。
界面和后端必须执行同一套规则。把按钮置灰只会改变提示,不能阻止旧客户端、远程工具或直接 API(Application Programming Interface,应用程序接口)继续发起写请求。认证与授权也要区分:认证回答“登录者是谁”,授权回答“这个身份在当前工位、当前模式和当前时间窗口内能做什么”。刷卡或输入 PIN(Personal Identification Number,个人识别码)只完成身份确认,后台还要检查角色、工位、运行状态、参数范围和动作前置条件。
以配方发布为例,正常生产中的操作员可以选择已批准的配方,却不应长期拥有重写判定阈值的权限;工程师在短时间调试时可以获得受限的临时修改权,但把修改推到生产线仍应通过复核或双人确认。权限设计最后要落到两个层面:组织层面规定谁负责、谁复核,技术层面规定系统实际接受哪些请求。
权限分层、技术机制与审计
RBAC(Role-Based Access Control,基于角色的访问控制)先定义岗位角色和每个角色的操作范围,再把人员加入角色,而不是为每个账户逐个配置按钮。这样新操作员入岗时继承操作员角色,换班或岗位调整时修改角色成员即可。角色应对应现场真实岗位,不能拆成几十个维护人员自己也说不清的微小开关。
典型划分如下:
| 角色 | 可以执行的典型动作 | 应限制的动作 |
|---|---|---|
| 访客或只读 | 查看状态、图像、报表和日志 | 修改配方、阈值、模型和标定 |
| 操作员 | 启停、复位、确认报警、选择已批准配方 | 修改模型、标定和安全联锁 |
| 工程师 | 标定、诊断、参数调试、切换配方 | 未经复核发布全线配置 |
| 管理员 | 账户、角色、备份和系统策略管理 | 绕过审计改变质量结论 |
高风险行业或生产环境还可能需要质量工程师、安全员等角色。是否增加角色,应由实际审批链和责任边界决定,而不是为了让权限表看起来更细。操作员角色对应正常生产节奏,工程师角色对应维护和调试,管理员角色对应账户及系统治理,这种对应关系也应出现在培训资料和交接记录中。
RBAC 只缩小“谁可以发起动作”的范围,不保证有权限的人一定判断正确。一个拥有工程师权限的人仍可能把看似合理的阈值改错;一个多人共用的工程师账户则会同时破坏权限边界和审计身份关联。角色定义完成后,还要为每个高风险动作规定前置模式、参数范围、确认方式和审计字段。
现场可以从只读、操作、工程和管理员四个基本层级开始。只读层用于查看状态、图像和报表;操作层处理正常生产、复位和常规报警;工程层进入维护、标定和调试;管理员层管理账户、备份和系统策略。层级名称应与岗位名称、培训材料和日志中的角色名称一致,否则现场人员知道“工程师模式”,系统却记录成另一个不易理解的权限名,排查时会增加歧义。
层级不能替代高风险动作的独立门槛。发布生产配方、修改安全联锁或执行联锁旁路,可以再要求双人确认、实体钥匙或限时授权。只依靠层级时,拥有工程师权限的人可能在任何时间直接改值;加入模式、范围和时序约束后,系统才能限制动作发生的场景。层级过粗会暴露不必要的入口,层级过细则会增加登录和培训负担,现场最终可能共享最高权限账户。设计完成后要用轮班、维护和应急流程演练,验证它是否真的能被使用。
可以把动作按影响范围分开。操作员选择已批准配方属于正常生产动作,系统应确认产品型号和工位;工程师修改阈值属于维护动作,系统应要求进入维护模式、限制可调范围并记录验证批次;管理员修改账户属于治理动作,系统应保留更严格的审计。若三类动作都放在一个没有风险提示的“设置”页面里,使用者看不到区别,软件也无法针对不同动作执行不同保护策略。
图 82-1 将角色范围、风险动作和技术机制连接起来。读图时先从左到右观察角色权限如何扩大,再从角色向下查看二次确认、顺序联锁和审计追踪分别限制什么,最后检查登录会话、受保护 PLC 标签、实体钥匙和写入留痕是否落在实际执行路径上。
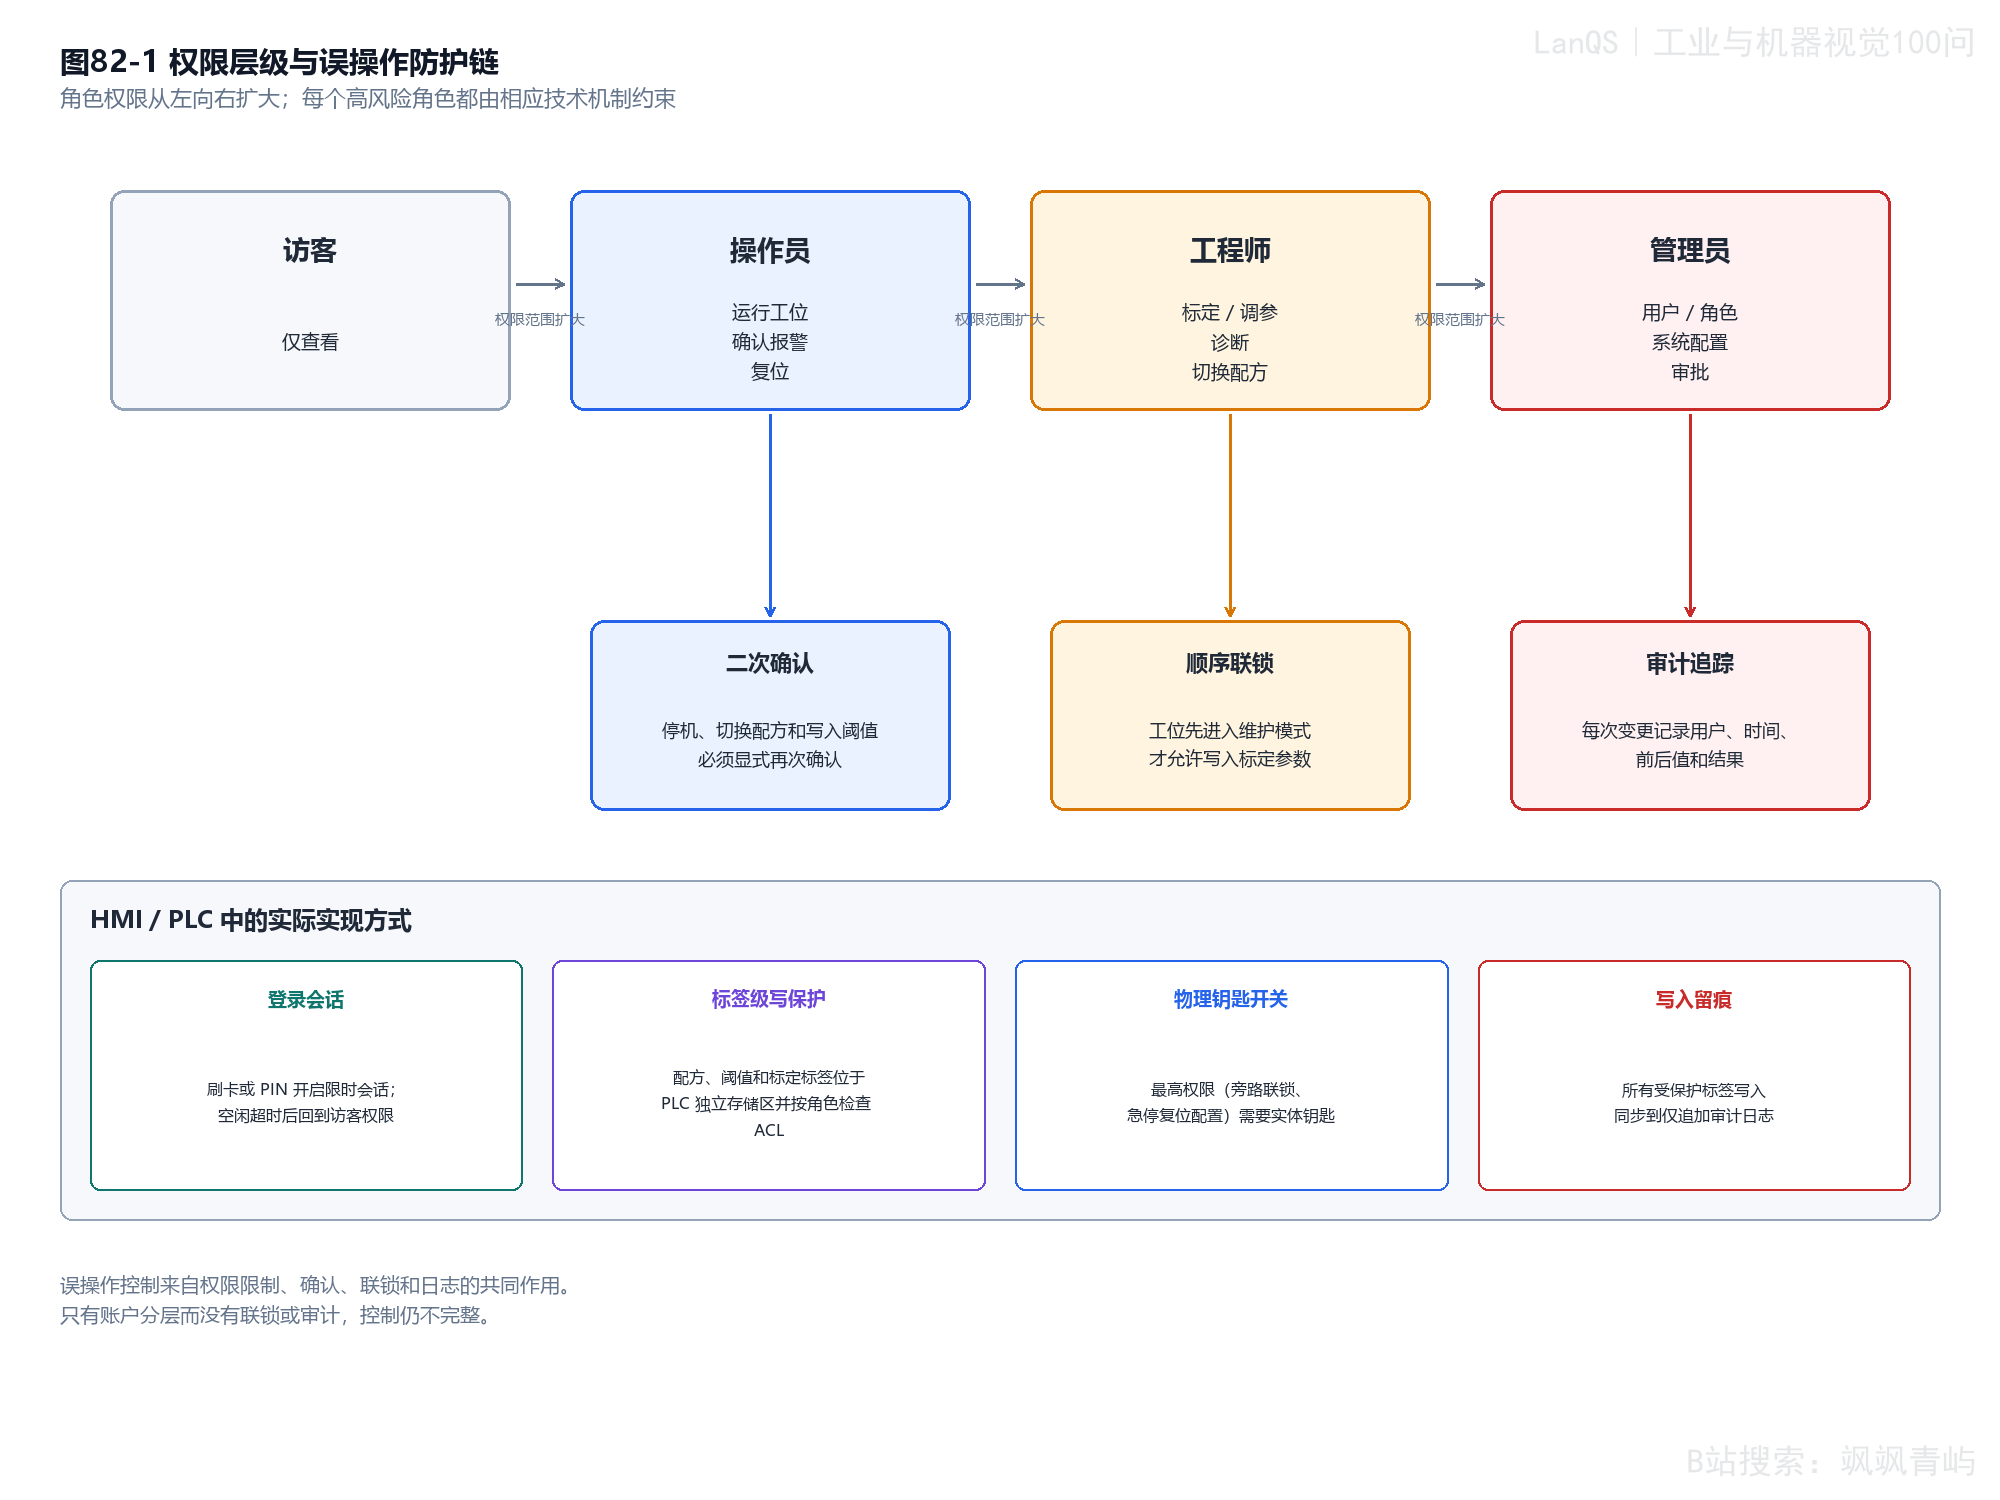
图 82-1 权限层级与误操作防护机制的对应关系
访客只能查看,操作员承担运行和报警确认,工程师承担标定、调试和配方切换,管理员承担账户与系统策略。图中二次确认对应停机、配方和阈值写入;顺序联锁要求工位先进入维护模式,才允许写入标定参数;审计追踪保存管理员级变更和其他受保护写入。底部的登录会话、标签级保护、物理钥匙开关和写入留痕说明这些规则应在哪里实现。角色框数量增加,不代表控制自动变强;如果后端仍接受越权写入,或没有任何前置状态检查,高权限动作仍然可以误执行。
二次确认的作用是让操作者在高风险动作真正执行前重新看到对象和影响范围。提示语应写清“将产品 A 配方发布到 3 号工位”或“把阈值从 118 改为 112”,而不是只显示“是否确定”。确认框不能替代授权检查,它解决的是操作者没有意识到动作影响的问题;授权检查解决的是这个账户有没有资格执行动作。
顺序联锁把设备状态作为写入前提。工位没有进入维护模式时,后端直接拒绝标定写入;设备仍处于自动运行或有在途工件时,系统可以拒绝某些会改变判断时序的配置切换。范围限制则对曝光、增益、速度补偿和剔除延时设置允许区间,输入越过区间时不进入设备。范围限制只能挡住超出预设边界的数字,不能判断一个范围内的值是否适合当前产品,因此仍需样本验证。
更高风险的动作可以使用双人确认和限时授权。双人确认适合影响整条线质量或安全边界的发布,要求发起人和复核人使用不同身份确认;限时授权适合售后支持或短时间工程调试,授权应带有开始时间、结束时间、授权人和自动降权动作。联锁旁路或急停响应配置还可以加实体钥匙开关,使远程账户不能单独完成最高风险操作。物理钥匙不能代替日志,钥匙的领取、使用和归还仍应纳入管理记录。
这些机制必须落在实际请求链路上。刷卡或 PIN 开启带角色和有效期的会话,空闲超时后自动降为只读,避免终端跨班次保留工程师权限。配方、判定阈值和标定数据应作为受保护标签或数据类,由 PLC 或后端在每一次写请求时检查 ACL(Access Control List,访问控制列表)。检查不能只发生在 HMI,因为 HMI 隐藏了按钮,远程工具或旧客户端仍可能直接调用接口。每次受保护写入还要写入独立日志,记录用户、时间、前值、后值、来源和结果。
写入前可以进行事务性检查:先读取当前运行模式和当前配方版本,确认没有其他会话在这段时间修改目标字段,再检查新值范围和依赖关系,最后提交。提交失败时保持旧值,并向 HMI 返回明确原因;如果写入成功但尚未完成复核和发布,系统应显示“已修改、未批准”,不能让它看起来像新的生产基线。这样可以区分一次失败的尝试、一次暂存变化和一次真正生效的发布。
权限分层的效果算例
权限分层对不同误操作类别的作用并不相同。下面的算例以每 1,000 个操作员班次为统计分母,比较三种方案:没有角色分层且使用共享账号的扁平方案、只使用 RBAC 的方案,以及 RBAC 加上针对该类别的二次确认、顺序联锁、审计或会话刷卡机制。所有数字都是为了说明计算关系而设置的示例数,不是现场测量结果。
| 误操作类别 | 扁平方案 | 仅 RBAC | RBAC + 针对性机制 |
|---|---|---|---|
| 未培训操作员修改阈值 | 8.0 | 2.8 | 0.56 |
| 错误配方发布到产线 | 5.0 | 1.5 | 0.23 |
| 在维护模式外覆盖标定 | 4.0 | 2.2 | 0.22 |
| 角色正确但判断错误的工程师修改 | 3.0 | 2.85 | 2.28 |
| 换班后继续使用共享账号 | 6.0 | 4.2 | 0.63 |
| 合计 | 26.0 | 13.55 | 3.91 |
计算使用三个比例数组。baseline_flat 是扁平方案的基线事件率,remaining_role_only 是加入 RBAC 后仍保留的比例,remaining_with_mechanism 是在 RBAC 结果上再加入针对性机制后仍保留的比例。对第 \(i\) 类事件:
这些比率没有物理单位,事件率的单位是“每 1,000 个操作员班次的事件数”。例如第一类事件的计算为 \(8.0\times0.35=2.8\),再加入二次确认后为 \(2.8\times0.20=0.56\);第二类为 \(5.0\times0.30=1.5\),再加入针对性机制后为 \(1.5\times0.15=0.225\),表中按两位小数写成 0.23。合计按未四舍五入的类别结果计算,三种方案分别是 \(26.00\)、\(13.55\) 和 \(3.91\)。
原始代码的计算逻辑如下:
import numpy as np

categories = [
    "未培训操作员修改阈值",
    "错误配方发布到产线",
    "在维护模式外覆盖标定",
    "角色正确但判断错误的工程师修改",
    "换班后继续使用共享账号",
]

# 每 1000 个操作员班次的示例事件率
baseline_flat = np.array([8.0, 5.0, 4.0, 3.0, 6.0])

# 仅加入 RBAC 后仍保留的比例
remaining_role_only = np.array([0.35, 0.30, 0.55, 0.95, 0.70])

# 加入针对性机制后,在 RBAC 结果上仍保留的比例
remaining_with_mechanism = np.array([0.20, 0.15, 0.10, 0.80, 0.15])

rate_role_only = baseline_flat * remaining_role_only
rate_full = baseline_flat * remaining_role_only * remaining_with_mechanism

total_flat = baseline_flat.sum()
total_role_only = rate_role_only.sum()
total_full = rate_full.sum()

print(f"扁平={total_flat:.2f}, 仅 RBAC={total_role_only:.2f}, 完整方案={total_full:.2f}")
程序得到的总事件率为:
扁平=26.00, 仅 RBAC=13.55, 完整方案=3.91
只使用 RBAC 时,总事件率从 26.00 降到 13.55,相当于相对扁平方案减少了:
在此基础上加入针对性机制,事件率再从 13.55 降到 3.91,相对扁平方案的额外降幅为:
完整方案的事件率是基线的:
第四类尤其值得检查。工程师拥有正确角色,因此 RBAC 只把事件率从 3.00 降到 \(3.00\times0.95=2.85\);加入审计后为 \(2.85\times0.80=2.28\)。审计主要负责发现和追溯,不能在错误判断已经通过授权检查后阻止它。这个算例说明权限分层能有效限制“谁可以做”,却不能单独判断“有权限的人这次做得对不对”。
统计比较成立的前提是三列使用同一个分母,即每 1,000 个操作员班次。实际项目如果改用每万次写入、每台设备每月或每批次统计,必须重新定义事件率,不能把不同分母的数字直接拼成趋势图。图 82-2 的数值用于说明机制作用范围,不是某条产线的风险预测。
图 82-2 中红、橙、绿三组柱分别表示扁平权限、仅 RBAC 和加入针对性机制后的示例事件率。前面三类事件随角色限制和前置机制明显下降,第四类则保留较高事件率,显示“授权正确但判断错误”的边界。图中的柱高不能单独推出真实事故概率,现场还需要使用统一分母和实际审计数据验证。
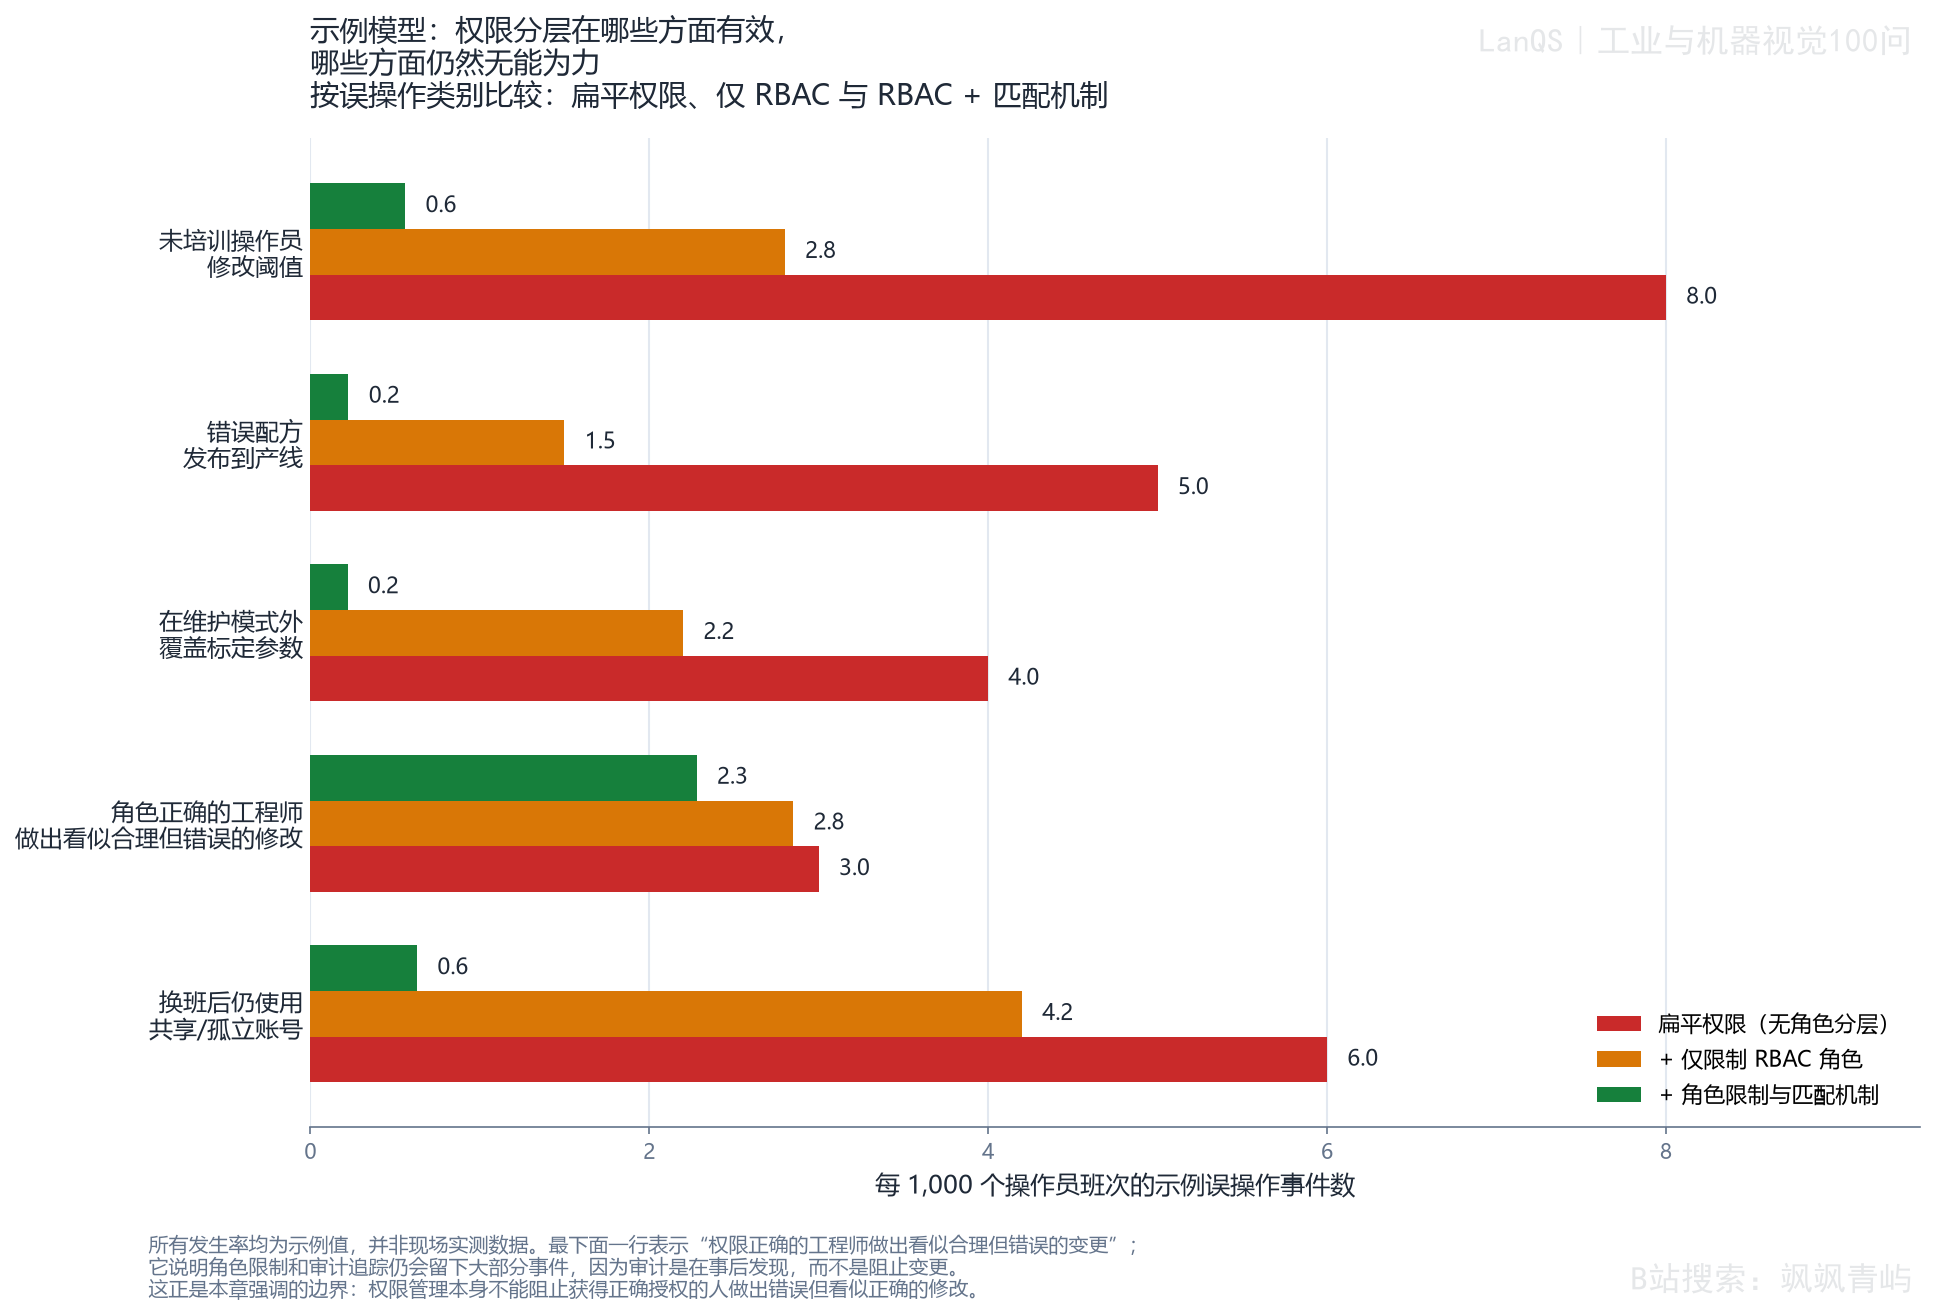
图 82-2 权限分层及针对性机制对不同误操作类别的示例影响
权限系统会增加登录、培训、审批和维护成本。层级太多或审批链太慢时,生产现场为了完成任务,可能共享工程师或管理员账户。共享账户让任务继续进行,却破坏了“一个会话对应一个可识别的人”这一审计前提。此时系统看似增加了权限控制,事故发生后却无法知道具体是谁做了修改。
权限设计还会影响生产可用性。报警复位和常规配方选择如果每次都要管理员介入,操作员会把保护流程视为停机障碍;所有动作都开放给操作员,生产操作变快了,阈值和标定误改的风险又会增加。低影响、可逆的动作可以采用较短的确认流程,不可逆、跨工位或影响安全边界的动作则需要复核、审批和回退。
RBAC 的另一条边界是它无法判断授权人员的动作是否正确。拥有合法标定权限的工程师仍可能发布一组错误标定值,拥有阈值编辑权限的工程师也可能根据少量样本作出错误判断。要覆盖这类问题,需要同行复核、发布前验证、分阶段上线和结果监测。把所有错误都交给权限层级处理,容易得到一个复杂却无法阻止判断错误的系统。
方案必须在真实流程中演练。演练应检查临时授权能否自动失效,网络断开时系统是否保持安全状态,管理员回退是否恢复到经过验证的版本,以及轮班后旧会话是否已经降权。层级数量本身不能说明方案有效,能否在生产节奏下保持身份清楚、动作可回退和记录完整,才是验收条件。
审计日志要完整回答“谁在什么时间、对哪个对象、执行了什么动作、结果是什么”。关键字段至少包括用户身份、设备或工位编号、时间戳、对象、前值、后值、结果状态和触发来源。触发来源应区分 HMI、远程工具和自动脚本。若系统连接 MES(Manufacturing Execution System,制造执行系统)、PLC 或配方服务器,还应记录关联工单或批次,以便把异常产品追溯到具体操作。
需要审计的事件包括登录和退出、配方切换、参数修改、模型替换、标定写入、报警复位和远程连接。日志应可检索并具有防篡改能力,不能由被审计的同一个账户直接覆盖。只记录 HMI 按钮被点击,不记录底层标签的实际前后值,也不能称为完整审计,因为按钮点击可能失败、被其他会话覆盖,或根本没有到达 PLC。
发现误操作后,审计记录应支持一条连续的调查路径。先固定异常首次出现的时间和对应批次或工单窗口,再按工位和时间范围提取该窗口内所有写入记录。随后把每条写入与当时有效的登录会话匹配,检查是否存在无会话写入或跨班次共享会话。再把写入时间与配方切换、阈值变化、标定改写和模型替换对齐,判断哪一个动作与异常开始时间相符。最后区分两类原因:角色本来就不应有该权限,还是角色正确但判断错误。前者需要修正分层或增加联锁,后者需要加强复核、验证和分阶段发布。
还要记录写入是否真正生效。用户点击保存、后端接受请求、PLC 接收标签、配置落盘和检测进程重启加载,是不同状态。日志应能区分失败尝试、已暂存未批准、已发布和已回退,否则调查人员看到一条“保存成功”记录,却不知道生产设备是否真的按照该值运行。
HMI 应持续显示当前账户、角色、运行模式、当前配方版本和设备状态。这样操作员在执行动作时能知道自己是谁、工位处于自动还是维护、设备将使用哪一个配方。危险动作要与查询、翻页和图像保存等日常动作分开,并在提示中写出具体对象、影响工位和版本差异。清晰的界面提示减少误解,但它不能替代后端授权。
视觉系统常把调试功能和生产功能放在同一个页面,现场人员因而容易在正常运行中触及阈值、标定或模型入口。生产运行页、参数调整页和维护诊断页应在结构上分开,让页面边界与角色边界对应。页面分开既减少误触,也让培训和换班交接更容易:操作员知道日常页面只允许哪些动作,工程师知道进入维护页后还要满足哪些条件。
界面权限必须与后台权限一致。隐藏“发布”按钮,却让旧客户端或直接 API 继续接受同一个写请求,只是改变了可见性,没有改变设备行为。高风险动作可以让 HMI 显示影响范围,后端执行角色和范围检查,PLC 保护关键标签,实体钥匙控制最高风险模式,日志记录最终写入。四者分别承担告知、拒绝、联锁和追溯责任。
确认完成后,界面应显示“待复核”“已发布”“加载失败”或“已回退”等状态,而不能只弹出一个没有上下文的“成功”。操作员需要知道变更是否已经到达 PLC 和检测进程,也需要知道失败时当前仍然使用哪一个旧版本。状态显示本身不是审计记录,但它能把技术状态转成现场人员可判断的信息。
组织控制与现场闭环
双重预防不是把同一条提醒显示两遍,而是让组织规则和技术系统相互补位。组织控制规定谁负责、什么情况需要升级、哪些变化需要审批、什么异常必须由第二人复核;技术控制把这些要求落实为角色、联锁、确认、范围限制、日志和报警。这样,换班、人员离职或交接不完整时,技术边界仍能保留,不能完全依赖每个人在压力下记住制度。
两类控制应在需求和接口设计阶段一起定义。制度若规定“工程师审核后才能发布阈值”,软件就需要审核状态和发布权限;制度若规定“维护模式才能标定”,后端和 PLC 就都应检查维护状态;制度若规定临时权限到时失效,系统就要保存开始、结束时间并自动降权。只有规则在接口和设备状态中留下对应字段,后续审计才有证据可查。
换班、人员离职、网络中断和应急维修都应成为演练场景。演练要验证新人员能否得到正确角色,旧会话是否失效,临时工程权限是否自动结束,维修后的参数是否需要重新复核,以及异常操作能否从日志中还原。技术控制发现的是动作和状态,组织控制决定如何响应和改进,两者共同形成从预防到追溯的闭环。
常见误区
- 只把 HMI 按钮置灰,后台仍接受越权写入。按钮状态不是授权检查。
- 角色拆得过细,现场最后共享管理员账户。共享账户会破坏身份追踪和最小权限。
- 把角色授权等同于操作正确性。RBAC 只能限制谁可以做,不能证明有权限的人判断正确。
- 只记录按钮名称,不记录 PLC 标签的前后值、来源和结果。事故调查无法确认实际写入了什么。
- 没有空闲超时,工程师会话跨班次保留。下一位人员可能继承不属于自己的高权限会话。
- 只保存审批文件,不在后端、PLC 或日志中执行对应规则。制度没有技术落点时,现场仍可绕过它。
- 只验证权限分层,不演练网络中断、临时授权失效和版本回退。纸面权限不能代替真实流程验收。
术语与符号表
| 术语 | 含义 |
|---|---|
| RBAC | Role-Based Access Control,基于角色的访问控制,把权限绑定到岗位角色,再分配给用户。 |
| 最小权限 | 账户只持有完成当前任务所需的权限。 |
| 职责分离 | 将编辑、复核、发布和回退等高影响动作拆分给不同角色或人员。 |
| 二次确认 | 高风险动作执行前,要求操作者再次确认具体对象和影响范围。 |
| 顺序联锁 | 未满足规定的前置状态时,系统禁止执行动作。 |
| 审计日志 | 保存身份、时间、对象、前后值、来源和结果的可追溯记录。 |
| 限时授权 | 只在限定时间窗口内有效的临时权限,到期后自动降权或失效。 |
| ACL | Access Control List,访问控制列表,规定角色对资源的操作范围。 |
| HMI | Human-Machine Interface,人机界面,供人员查看状态和操作设备的软件界面。 |
| PLC | Programmable Logic Controller,可编程逻辑控制器,用于协调设备和产线动作。 |
| MES | Manufacturing Execution System,制造执行系统,记录生产批次、工单和过程信息的系统。 |
延伸阅读
- ISA/IEC 62443 系列:工业自动化与控制系统安全,涉及账户、访问控制和审计要求。
- NIST SP 800-162,Guide to Attribute Based Access Control (ABAC) Definition and Considerations:用于理解在角色之外加入班次、工位和时间窗口等上下文属性。
- ISO 9001:2015 第 7.5 条和第 8.5.1 条:涉及文件化信息、生产控制和制造过程追溯。
- Sasangohar 等关于工业控制室人因和报警管理的研究:用于理解界面清晰度、培训与误操作之间的关系。
第83问 客户要求增加一种缺陷检测,软件架构如何支持快速扩展?
模块:软件工程、系统架构与项目交付
视觉项目交付后很少永久冻结。客户可能增加 SKU(Stock Keeping Unit,库存量单位),产品表面会出现新的纹理;工艺改变后,原来被忽略的外观可能变成必检缺陷;质量要求收紧后,过去允许的差异也可能进入判定范围。若新增一种缺陷就要同时改采集、主循环、界面、PLC 通信和日志,原本已经稳定的功能会被反复触碰,回归范围和现场风险会随着缺陷种类增加。本题讨论怎样把变化局部化,让新增缺陷主要表现为一个检测器、一组配方参数和一轮验证,同时说明这种架构在成像、节拍和兼容性方面的边界。
模块化架构与插件接口
客户提出新缺陷时,工程师面对的通常不是“再写一个算法”这么简单。新产品可能需要新的 ROI(Region of Interest,感兴趣区域),新的缺陷定义可能要求保存证据图,新的质量规则可能需要把结果映射到既有 PLC 消息。若这些变化都直接写进主循环,新增一种缺陷就会触碰已经工作的相机采集、界面逻辑、通信接口和图像归档。每次发布都要重新证明旧缺陷仍然正常,维护成本会随项目寿命快速上升。
快速扩展的目标是建立稳定的变化边界,而不是寻找一个能够检测所有外观的单一算法。采集、预处理、通信、结果展示和归档已经稳定时,新能力应尽量限制在检测模块和相应配置中。这样,工程师可以在不改动整条主流程的前提下加入一种规则、几何或深度学习检测器,再用共享回归样本验证它是否影响既有能力。可扩展性既是代码结构问题,也是接口、配置和测试组织问题。
也要先判断新增缺陷是否真的属于软件扩展。如果新缺陷需要新的光源角度、新相机视角或新的触发方案,软件无法从现有图像中获得缺失信息,问题已经回到成像和系统设计。插件架构可以减少软件接入工作,但不能补偿采集条件不足。
模块化架构按稳定职责切分系统。采集模块负责相机触发、取图和采集元数据;预处理模块负责统一尺寸、颜色、校正和 ROI;检测模块负责把图像转换为缺陷判断;结果合并模块负责汇总多个检测器的结果;通信和归档模块负责将结果送给 PLC、MES(Manufacturing Execution System,制造执行系统)、HMI 或图像存储。新增缺陷时,理想变化集中在检测模块,其他模块继续使用原来的输入和输出约定。
边界不能只靠文件夹名称表达,必须有明确的输入输出契约。预处理应交给检测器一个统一的图像对象和元数据,元数据可以包含配方、工位和时间戳;检测器应返回统一的缺陷结果结构,而不是每种算法各自定义一套字段。规则法、几何法和深度学习法的内部过程可以不同,结果仍应包含可解释的类型、位置、尺寸、分数、建议动作和证据图等信息。否则系统表面上被分成多个文件,调用关系仍然互相牵连,每加一个检测器都要改下游代码。
图 83-1 中,采集与预处理先形成统一输入,多个检测器通过一个接口并列接入,结果合并模块再把统一结果交给通信和归档。图下方的配置、契约版本和共享回归集,是模块化能够长期工作的条件;它们不会因为代码分成模块就自动存在。
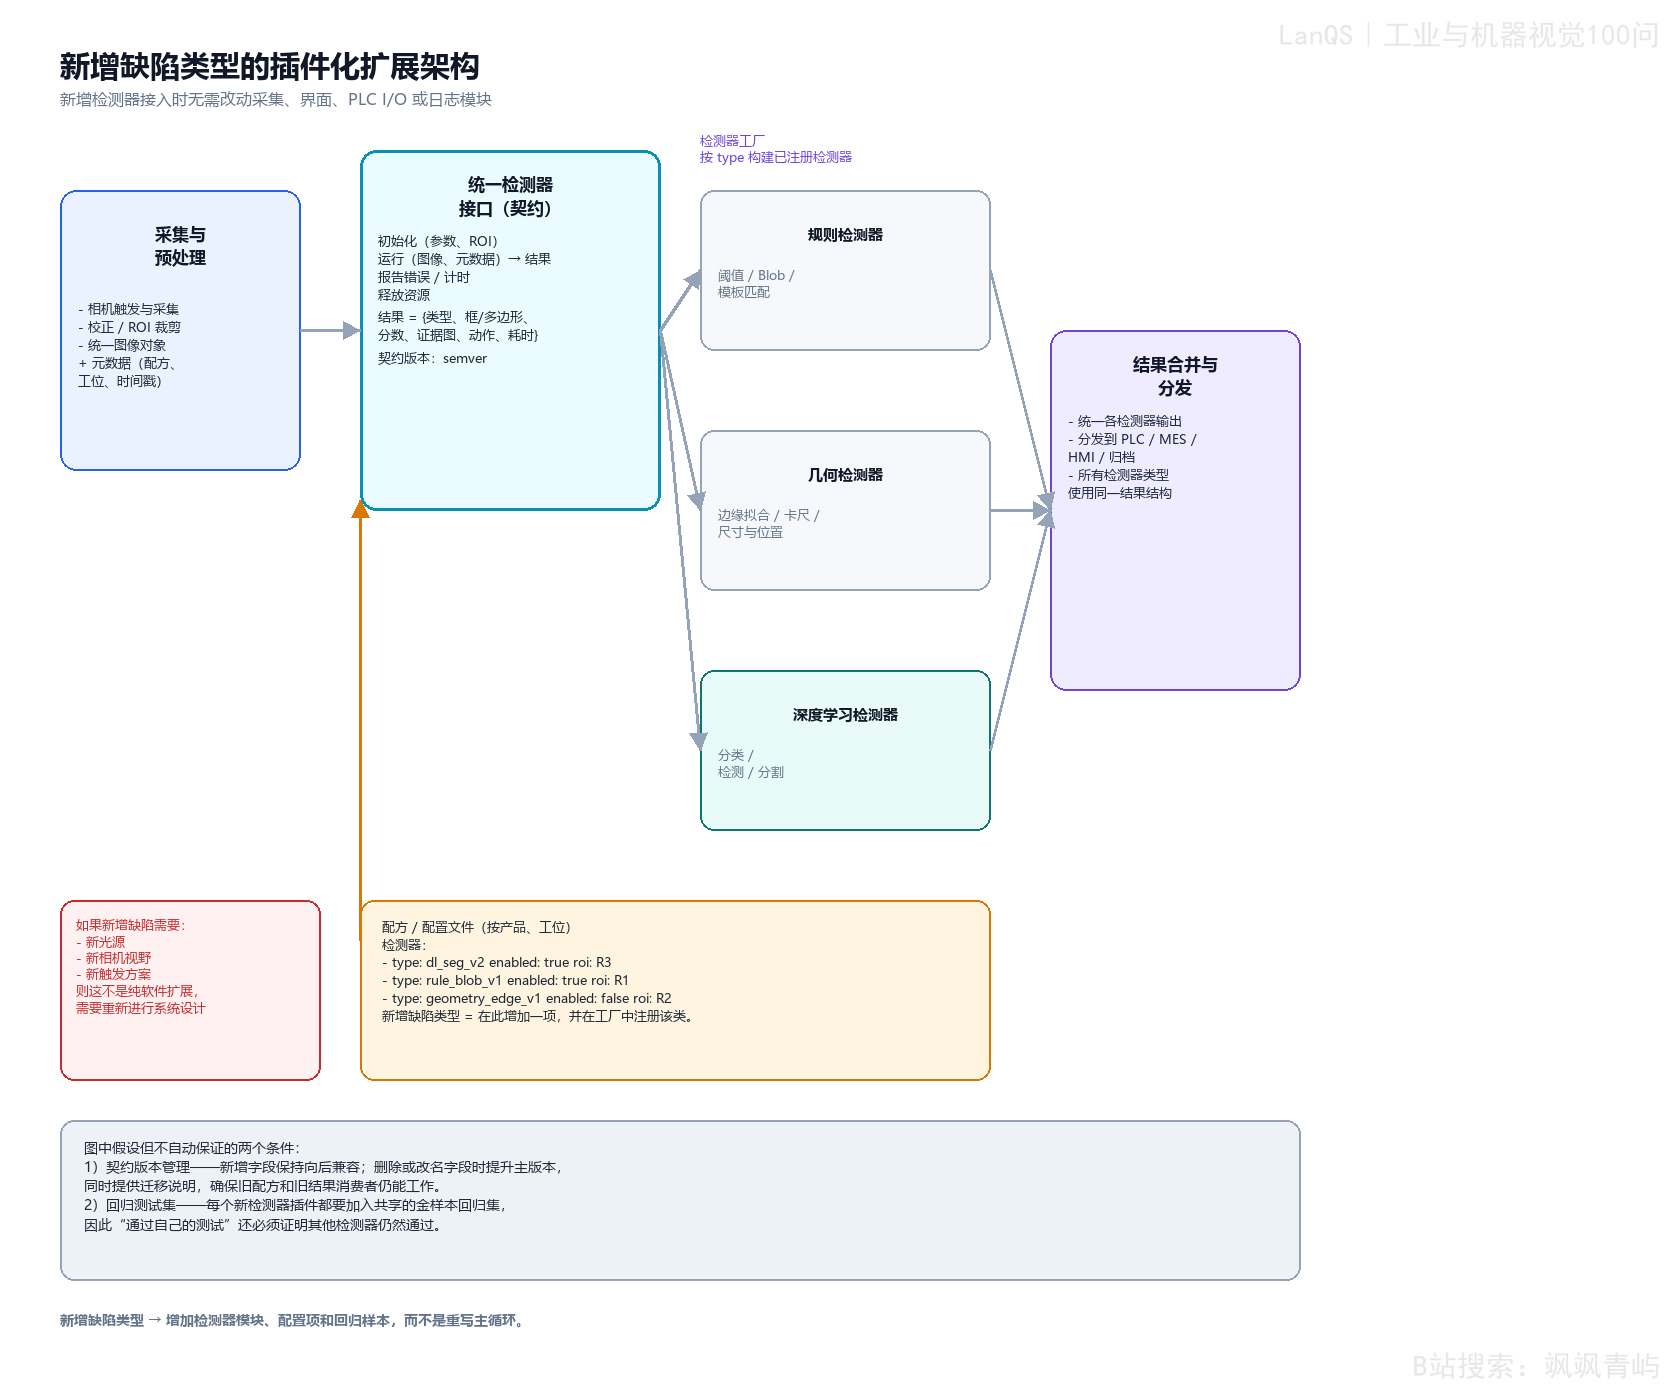
图 83-1 新增缺陷类型的插件化工业视觉架构
读图时先看左侧传递的是否是同一种图像对象和元数据,再看中间接口有没有规定初始化、运行、错误和计时,最后看不同检测器的输出是否全部进入同一个结果合并模块。下方配方示例说明新增缺陷可以增加一个检测器类型和配置条目。左下红色区域表示架构边界:如果客户要求新的光源、新相机视角或新的触发方案,现有图像条件已经变化,不能把它包装成纯软件插件问题。
插件化新增一种缺陷的工作量算例
插件架构节省的时间来自可复用的接线、有限的回归范围和较小的发布影响面,并不来自检测算法本身突然变简单。下面比较新增一个中等难度缺陷时,单体硬编码流程和插件化流程的示例工程师工时。数值是教学构造值,不是某个真实项目的测量结果;两种架构的新检测器开发都取 16 小时。
| 工作类别 | 单体流程(小时) | 插件化流程(小时) |
|---|---|---|
| 新检测器开发 | 16 | 16 |
| 接入主循环、界面和 PLC | 22 | 3 |
| 既有缺陷回归测试 | 30 | 10 |
| 分阶段部署与返工 | 18 | 5 |
| 合计 | 86 | 34 |
单体流程的工时为:
插件化流程的工时为:
示例节省率是:
这里的单位是工程师小时,计算只反映这四类工作量。两种架构在检测器开发上都用 16 小时,说明插件并不会自动降低算法开发难度;差异主要出现在主循环、界面和 PLC 接线,既有缺陷的回归范围,以及分阶段部署和返工。86 小时、34 小时和 60.5% 不能作为所有项目的承诺值。接口没有定义清楚、回归样本不足,或者新增缺陷需要硬件变化时,实际节省可能消失。
图 83-2 左侧按工作类别显示四组工时,右侧单独比较总量。读图时应先观察“新检测器开发”两根柱是否接近,再看其余三类工作的差异,这样才能理解插件化究竟减少了什么。
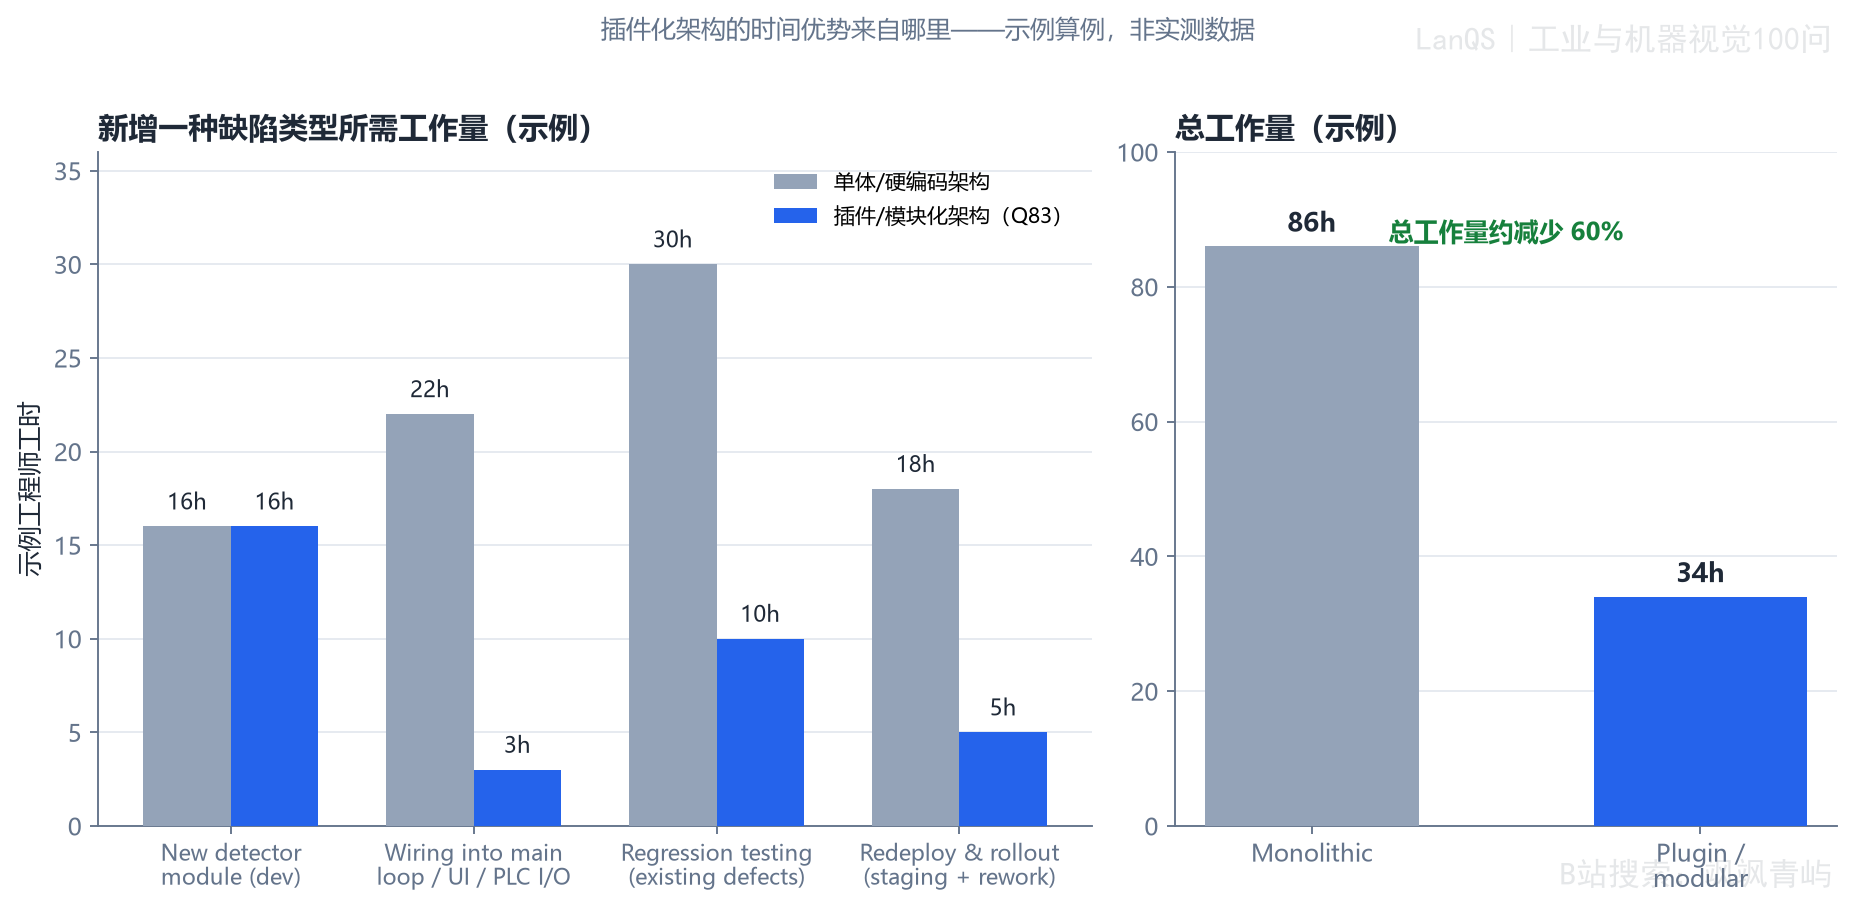
图 83-2 新增一种缺陷时单体与插件化架构的示例工作量
“插件化”不一定意味着设备不停机时也能零停机替换代码。对多数工业项目,配置决定系统启动时加载哪些检测器、执行顺序、适用产品和 ROI,就已经提供了可替换的检测能力。主程序只依赖统一接口,不直接依赖某一种缺陷算法;具体检测器可以是动态库、脚本包或独立服务节点。新增检测器时,注册类型、提供参数并将它加入经过验证的配方,主流程不应增加一串针对该算法的特殊分支。
插件边界需要声明初始化参数、输入图像要求、失败状态、耗时统计和资源释放方式。一个只返回“合格”或“不合格”的插件不够用于生产,因为上层还需要知道它识别了哪一种缺陷、位置在哪里、是否发生超时,以及是否应该触发什么动作。初始化失败、推理失败和正常的“不合格”也必须区分,否则通信和报警模块无法判断该把结果当作缺陷,还是当作系统故障处理。
插件可替换的前提是其输入契约稳定。若某个检测器私自改变颜色空间、图像尺寸或 ROI 解释方式,主程序即使没有变化,换插件也可能得到无法比较的结果。输入要求应写在契约和配置中,检测器在初始化时检查,不满足时明确失败,而不是悄悄使用默认值。
接口契约是可扩展架构的工程产物。至少需要规定五件事:算法收到什么输入,返回什么结果,怎样初始化,怎样暴露参数,怎样报告错误和耗时。输入通常包括图像、相机信息、当前产品配方和 ROI;统一输出可包含缺陷类型、位置、尺寸、置信分数、建议动作和证据图。某种算法不需要填满所有字段,但字段结构、数据类型、单位和空值含义必须稳定。
一个最小接口可以写成:
init(params, roi_spec)              初始化参数和 ROI
run(image, meta) -> Result          运行并返回统一结果
report_error() / timing()           报告错误和耗时
dispose()                           释放资源
接口还需要注册机制。检测器在注册表中以 type 标识,例如 dl_seg_v2 或 rule_blob_v1,配置只声明需要哪一种类型,主程序不硬编码具体类名。结果中的 type、位置、尺寸和分数也要约定单位及坐标系,例如坐标是原图坐标还是 ROI 局部坐标,尺寸使用像素还是物理单位。若这些含义不固定,结果合并和现场标定都会出现歧义。
接口有自己的版本,不能只给每个检测器编号。增加可选字段通常可以保持向后兼容;删除字段、改变字段含义或改变单位属于破坏性变化,应提升主版本,并附带迁移说明。接口版本变化时,旧配方、旧结果消费者和旧归档程序仍可能存在,兼容窗口需要在发布前明确。
配置层也属于接口契约。算法 A 使用 threshold_low,算法 B 使用 conf_score,算法 C 却用 limit1 表示近似概念,现场人员无法仅从名称判断区别。配置定义应统一参数类型、单位、默认值、有效范围和适用条件,让界面生成、启动校验和文档引用同一份定义。
流程接入、模型兼容与节拍
工厂模式集中处理“根据配置中的类型,创建哪一个检测器”。主流程只面对统一接口,具体对象由工厂构建并注入参数。新增阈值检测、模板匹配或 CNN(Convolutional Neural Network,卷积神经网络)检测器时,工程师注册一个类型并提供相应配置,主循环不需要加入一长串 if/else 条件。
可以用下面的伪代码表示调用关系:
detector = DetectorFactory.create(config.type, config.params)
detector.init(config.params, config.roi)
result = detector.run(image, meta)
ResultMerger.add(result)
detector.dispose()
工厂降低的是对象创建和主流程的耦合,不会自动解决算法输入、结果字段、耗时预算和回归测试。如果新增算法仍然要同时修改主界面、主线程、通信消息和日志结构,说明接口边界还不稳定。新增检测器之后,主流程应该只看到一个统一 Result,而不是知道这个结果来自阈值法、几何法还是深度学习法。
配置驱动的含义是把“哪些检测要运行、运行顺序是什么、适用于哪一种产品、参数从哪里来”写入配方,而不是为每个产品复制一份主程序。例如一种产品只需要尺寸和表面污点检查,另一种产品还需要字符识别和缺件检查,系统可以使用同一个主流程,替换经过验证的检测器组合。
配置驱动并不等于所有行为都可以由文本自由重写。ROI、阈值和启用开关通常属于配方级参数;安全联锁、通信握手和异常恢复属于系统规则,不应由普通配方任意修改。把两类内容放在同一个可自由编辑的权限层中,普通配方变更就可能获得超出产品选择范围的影响。
配置加载时要检查检测器类型是否存在、必填参数是否齐全、参数范围和单位是否正确、ROI 是否适用于当前图像,以及执行顺序是否满足依赖关系。配置只声明“启用深度学习检测器”并不表示模型已经加载成功,启动和运行阶段还要报告初始化、推理和资源错误。检测器配置和系统规则分离后,新增缺陷可以局部变更,安全边界仍由固定代码和受保护接口维护。
深度学习检测器不应成为漂浮在系统外的黑盒。接入时要复用既有的图像预处理、ROI 约定、推理调用和结果结构,并明确模型输入尺寸、颜色空间、归一化方式、后处理、模型版本、耗时和资源需求。模型文件放入项目目录只是复制文件的动作,不能说明它满足了输入、输出和节拍契约。
模型输出还要回到统一的缺陷对象。分类模型的类别和分数、检测模型的框、分割模型的掩膜,都需要转换到系统约定的坐标系和字段中。若某个模型使用 ROI 局部坐标,而结果合并模块按原图坐标处理,缺陷位置会在合并、显示或剔除阶段发生偏移。模型接入时应通过样本检查输入尺寸、类别顺序和后处理阈值,确保界面、日志、PLC 和归档得到同一种结果解释。
资源也是接口的一部分。如果一台 IPC(Industrial Personal Computer,工业计算机)只能稳定运行一个重模型,配方就不能无条件叠加多个模型。系统要估算 GPU、内存和显存占用,决定串行或并行调度,并明确模型加载失败、推理超时和资源不足时的降级动作。降级动作是报警、暂停、使用备用检测器还是返回不可判定状态,应由系统规则决定,不能由插件自行静默处理。
新增检测器即使准确,也可能让总处理时间超过产线允许的节拍。常见方法是先用成本较低的规则或 ROI 预筛选候选区域,再把少量候选交给耗时模型;互不依赖的检测可以并行或异步执行;结果合并阶段保持固定的超时和缺省状态。缓存只有在图像、配方和版本一致时才适用,不能为了速度复用另一种产品或另一版本的结果。
性能验证需要查看平均延迟、最坏路径、抖动、复杂工件、边界样本和持续高负载。P99(99 分位延迟)表示 99% 的观测样本延迟不超过该值,它能显示尾部延迟,不能代表绝对最大延迟,也不能替代队列积压和超时测试。一个插件应有耗时预算,系统还要记录总体节拍、队列深度、GPU 和内存占用,观察连续高负载下是否逐步积压。
验证时要区分单个检测器延迟和全链路节拍。检测器单次运行很快,不代表多个检测串行后仍满足周期;平均值满足要求,也不代表最复杂工件和最长路径满足要求。发布前应把新旧版本放在同一组正常、缺陷和边界样本上比较,加入持续运行和异常超时场景,确认超时不会把旧结果误当成当前工件结果。
长期演进与项目落地
接口、配置和结果消息都需要版本。可以采用语义化版本:增加可选字段通常属于兼容扩展,使用次版本或补丁版本;修复不改变接口含义的问题使用补丁版本;删除字段、改变字段含义或改变单位属于破坏性变化,应提升主版本并提供迁移说明。版本号描述的是契约变化,不只是某个插件文件的编译次数。
现场工位、上游系统和下游消费者不会总是同时升级。旧配方可能仍由旧工位使用,旧结果消息可能仍被归档或 MES 读取,因此新插件发布前要明确兼容窗口、旧字段保留时间和消息转换方式。若新检测器改变了结果结构,结果合并层可以提供适配器,或在发布中同时提供新旧格式,不能让下游通过猜字段含义继续工作。
共享金样本回归集是兼容验证的依据。它应包含旧检测器的预期结果、典型边界样本和已有通信输出。每次新增插件都要跑旧检测器、结果合并、通信和归档的回归,确认“新能力通过”没有掩盖“旧能力被破坏”。接口隔离减少代码耦合,不能自动保证行为和数据兼容。
成熟平台已经稳定了相机采集、通信握手、结果上报、缺陷图像归档和日志。客户提出新缺陷时,工程师主要增加检测器逻辑、配方参数和验证样本,再把候选版本送到测试工位、试点工位和生产工位分阶段验证。部署工作从重新开发整套系统,变成局部能力接入和有限范围回归。
架构投入的回报来自反复扩展。早期建立统一接口、配置校验、结果合并和测试框架需要时间,但后续每种缺陷都可以复用这些边界。工程师应记录新检测器的输入约束、参数含义、耗时预算、版本和适用条件,避免每次扩展都重新解释同一套基础问题。
这种架构也有成本边界。单工位、需求长期不变、缺陷类型只有两三种且团队很小的项目,简单的模块边界和注册表可能已经足够;完整动态插件平台会增加接口测试、版本兼容和运维负担。是否采用更复杂的插件机制,应根据预期扩展次数、工位数量、下游接口数量和兼容周期判断。新增缺陷需要新的光源、相机角度或触发方式时,优先重新评估成像系统,而不是继续堆叠软件插件。
常见误区
- 为只有两三种缺陷且长期不变的项目构建过于复杂的动态插件平台。接口版本、动态加载和运维成本可能超过复用收益。
- 有插件机制,却没有共享回归集和金样本。模块隔离减少了接线范围,不等于已经证明旧检测器行为不变。
- 不同插件使用不一致的字段名、单位、坐标系和错误状态。结果合并与现场维护会重新产生耦合。
- 把 ROI、阈值等可调参数与安全联锁、通信握手和异常恢复放进同一份可自由修改的配方。
- 只在平均负载下测试新增检测器。复杂工件、持续高负载、队列积压和超时才可能暴露节拍问题。
- 把模型文件复制进项目目录就当作完成接入。输入尺寸、类别顺序、前后处理、资源占用和模型版本也必须核对。
- 修改结果结构却不更新契约版本和迁移说明。旧配方和下游消费者可能继续读取已经改变含义的字段。
- 把需要新光源、新视角或新触发的成像问题当成纯软件扩展。插件无法恢复原图像中不存在的信息。
术语与符号表
| 术语 | 含义 |
|---|---|
| 模块化架构 | 按职责划分采集、预处理、检测、结果合并、通信和归档边界的设计。 |
| 插件化架构 | 主程序依赖稳定接口,具体检测器可以独立加载、配置和替换的设计。 |
| 接口契约 | 对输入、输出、生命周期、错误、计时、数据类型、坐标系和单位的共同约定。 |
| 工厂模式 | 根据配置中的类型创建具体检测器对象,并把参数注入对象的机制。 |
| 配置驱动流程 | 由配方声明检测步骤、执行顺序、适用条件和参数,而不是为每种产品复制主程序。 |
| 语义化版本 | 用主版本表示破坏性变化,用次版本和补丁版本表示兼容扩展与修复的版本规则。 |
| 回归集/金样本 | 带有预期结果的固定样本,用于验证新增变化没有破坏既有检测行为。 |
| P99 | 延迟的 99 分位值,表示 99% 的观测样本延迟不超过该值,用于观察尾部性能。 |
| 节拍预算 | 每个工件或周期允许检测流程占用的时间上限,需在最坏路径下验证。 |
| ROI | Region of Interest,感兴趣区域,表示参与图像处理或检测的区域。 |
| IPC | Industrial Personal Computer,工业计算机,指部署在现场执行视觉软件的计算机。 |
| PLC | Programmable Logic Controller,可编程逻辑控制器,用于接收检测结果并协调产线动作。 |
| MES | Manufacturing Execution System,制造执行系统,用于记录生产工单、批次和过程信息。 |
延伸阅读
- Gamma、Helm、Johnson、Vlissides:《Design Patterns: Elements of Reusable Object-Oriented Software》,介绍工厂模式和策略模式等架构模式。
- Fowler:《Patterns of Enterprise Application Architecture》,讨论通过稳定接口隔离变化的架构方法。
- Preston-Werner:《Semantic Versioning 2.0.0》,介绍接口和配置演进中的版本规则。
- Newman:《Building Microservices》,讨论服务边界、兼容和长期演进;其中的接口思想也适用于进程内检测插件。
第84问 工业视觉项目交付时应该准备哪些文档?
模块:软件工程、系统架构与项目交付
视觉系统通过验收后,项目团队可能离开现场,操作员会换班,维护人员可能更换相机或工业计算机,产线也可能增加产品型号。交付文档要让后来的人能够理解系统、安装设备、完成日常操作、排查故障、恢复软件,并按原定条件复核验收结果。它不是项目总结的附属物,而是系统运行技术契约的一部分。本题按设计与图纸、操作与维护、测试与验收、管理与追溯四类资料说明交付内容,并用排障时间算例说明缺失文档会怎样增加恢复代价。
交付文档的范围与设计资料
交付文档要同时支撑理解、操作、维护和追溯。它记录设备状态、设计依据、版本变化、操作步骤、恢复路径和性能边界,使客户在原开发人员不在场时仍能运行系统;也让后来人员知道设备为什么这样选、某个参数受什么约束、验收是在什么条件下完成的。换班、人员更替、产线扩展和售后支持中的沟通,也可以据此建立在同一套记录上,而不必依赖个人记忆。
判断文档是否合格,要看目标读者能否完成真实任务。操作员能否按步骤启动设备、处理报警和切换已批准配方;维护人员能否清洁镜头、检查触发、备份文件和重新标定;电气人员能否按图纸更换部件;客户质量人员能否按测试条件复核结果。文件数量、页数和目录是否齐全,都不能单独证明文档可用。文档必须服务具体动作,步骤、前置条件、异常分支和完成判据都要能被读者找到。
一套实用的交付资料可以分为四类。设计与图纸资料解释系统怎样构成,操作与维护资料解释系统怎样使用和恢复,测试与验收资料解释它在什么条件下通过,管理与追溯资料保存需求、变更、版本和责任历史。按读者和工程任务分类,比简单区分纸质文件和电子文件更容易检查是否缺项。
| 类别 | 典型内容 | 主要读者 |
|---|---|---|
| 设计与图纸 | 设计说明、接线图、电气原理图、机械安装图、接口清单 | 实施、维修、集成和后续开发人员 |
| 操作与维护 | 操作手册、保养计划、故障处理、备份恢复、标定流程 | 操作员、工艺和维护人员 |
| 测试与验收 | 测试计划、样本组成、结果记录、边界、问题关闭、签署记录 | 客户质量人员和项目负责人 |
| 管理与追溯 | 需求确认、会议纪要、变更单、版本清单、培训签到、备份清单、联系人 | 项目管理、售后和争议处理人员 |
图 84-1 把四类资料、目标读者和项目生命周期联系起来。读图时不要只数每列有多少文件,而要追问某个任务由哪份资料支撑,以及这份资料如何在系统变化后保持最新。
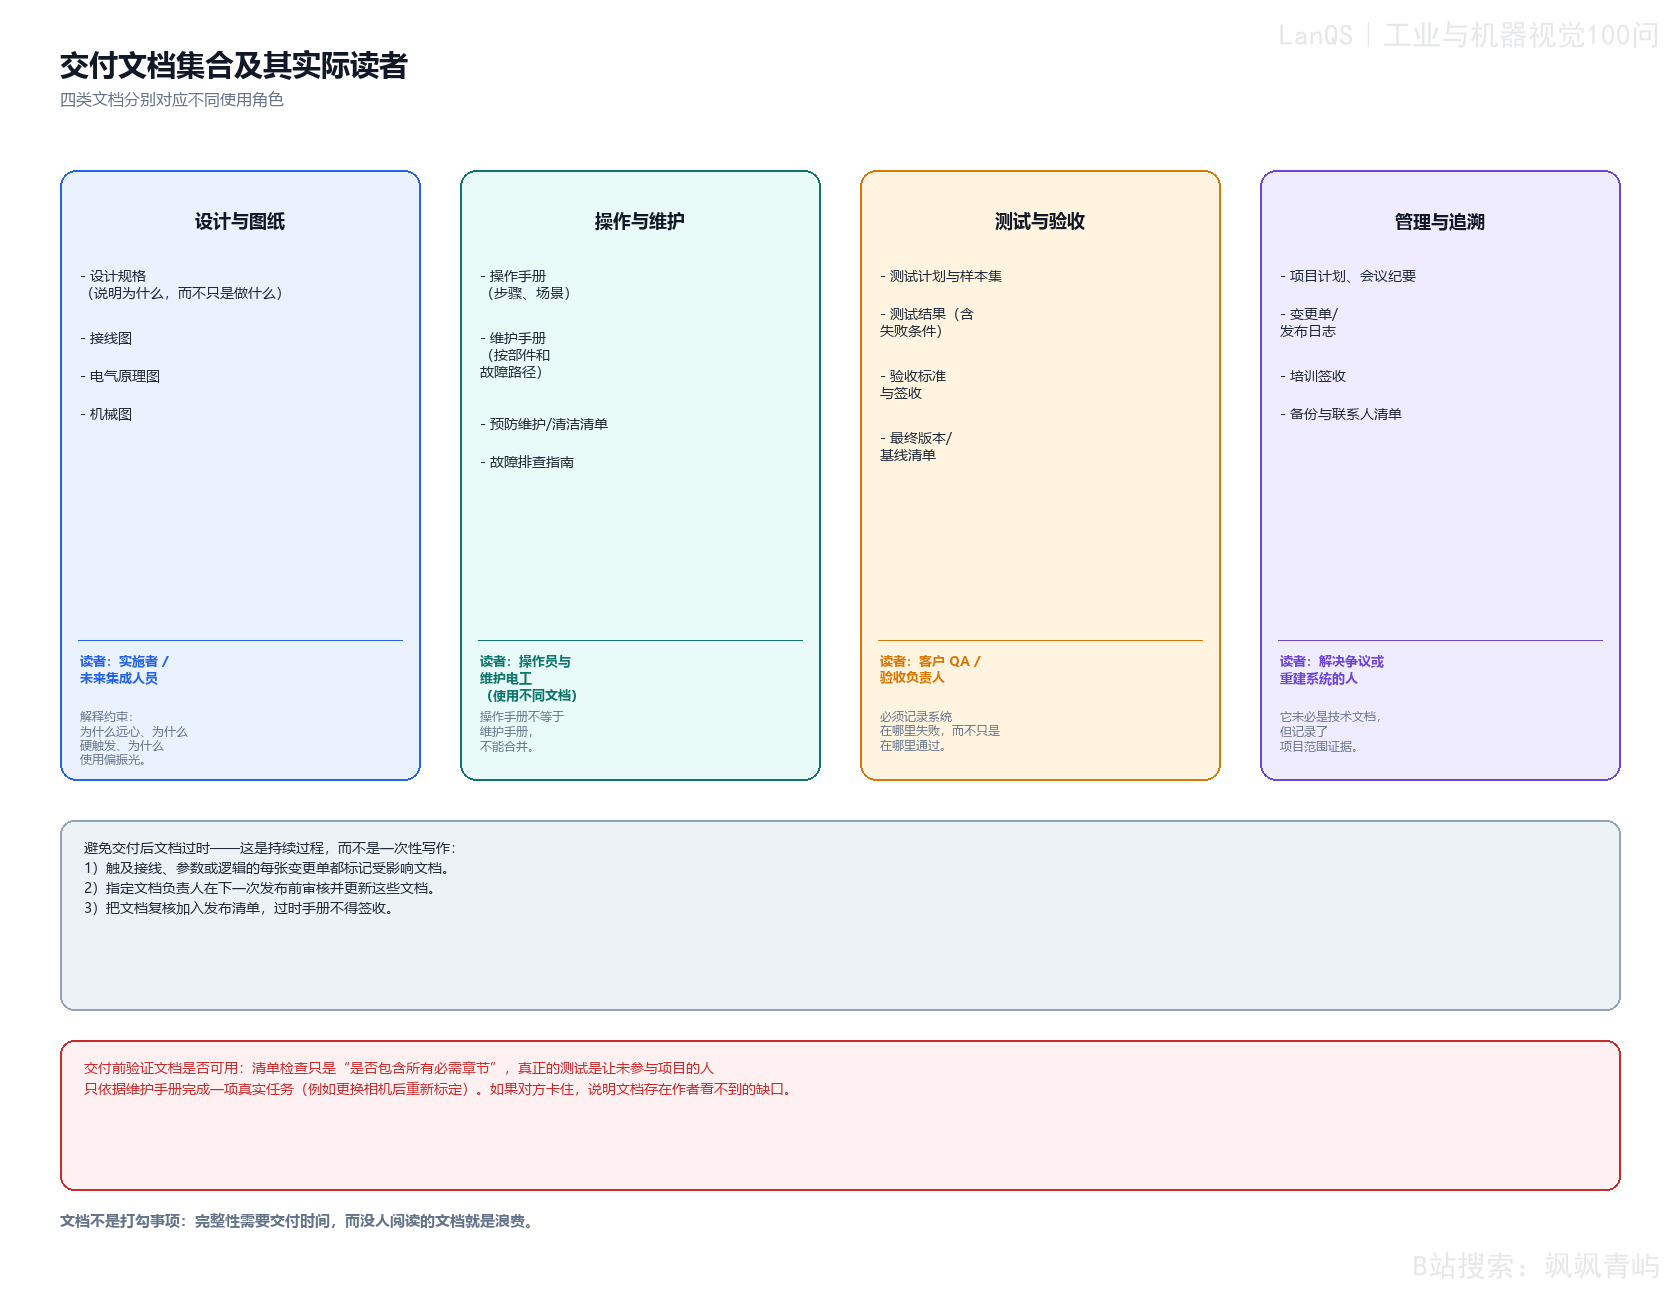
图 84-1 按类别、读者和生命周期组织交付文档
设计与图纸资料支持实施和集成,操作手册支持生产人员,维护手册支持维修和工程人员,测试与签署记录支持客户验收,管理与追溯资料支持项目管理和售后诊断。图下方的更新和可用性检查提醒读者,资料不能在交付当天写完就永久冻结。接线、参数或软件版本发生变化时,相关图纸和手册也要更新;交付前还要让目标读者实际执行任务,确认步骤确实可用。
管理资料通常从需求确认开始,延伸到项目计划、会议纪要、变更记录、发布记录、培训签到、备份清单和联系人信息。它们不直接参与图像判定,却决定后来人员如何解释项目范围、版本状态和责任边界。
客户提出新增检测项时,需求确认记录和变更单可以说明它是否属于原始范围,以及由此增加了哪些交付内容。工业计算机损坏或磁盘需要重建时,备份清单应指出要恢复哪些程序、模型、配方、标定文件和许可证。发生性能争议时,发布记录、测试记录和签署文件可以把问题对应到实际交付版本、样本范围和当时的验收条件。
这些资料最好有版本和负责人。变更单要能链接到受影响的设计、软件或手册,培训记录要能说明哪些岗位接受了哪些内容,联系人信息要覆盖项目、维护和售后职责。管理文档不是检测算法的一部分,却是技术结果能够在交付后被解释和承担的证据。
设计说明书应同时写清系统用了什么、为什么这样用。内容通常包括检测对象、缺陷定义、节拍要求、视场、光学和成像方案、软件架构、通信接口、异常处理逻辑、性能指标和适用边界。关键计算也应保留,例如视场与分辨率、触发时序、数据带宽和照明方案的约束。后来人员只有看到这些假设,才能判断一次改动是否仍在设计范围内。
设计说明书的价值在于解释选择理由,而不是堆叠器件清单。例如,若设计采用远心镜头,应说明它与尺寸测量或透视误差的关系;若某个信号必须使用硬触发,应说明触发时刻与工件运动、曝光和结果对应关系;若某类表面使用偏振光,应说明它要抑制哪一种反光。没有这些理由,后来人员可能保留了名称相同的部件,却改变了原本的成像约束。
文档还应写明哪些结论只在特定条件下成立。检测指标是在什么光照、工件姿态、速度、温度和样本范围下得到的,哪些边界样本需要人工复核,哪些变化必须重新验收,都应在设计或测试资料中交代。这样,设计说明书才能成为后续维护和扩展的依据,而不是交付时只读一次的项目介绍。
接线图回答设备如何连接、端子号怎样对应、信号向哪个方向流动、线缆通往哪里。电气原理图表达供电、保护、输入输出映射和控制关系。机械图表达安装位置、尺寸、公差、工作距离和可调范围。三者关注对象不同,不能用一张界面截图或几段文字互相替代。
视觉系统把相机、镜头、光源、执行器、编码器和 PLC 连接成一条链路。维护人员更换光源时需要知道电源和端子,电气人员排查触发异常时需要知道信号方向,工程师复核视场时需要知道安装高度和工作距离。图纸提供了这些任务所需的精确对应关系,也帮助售后人员在没有原实施人员陪同的情况下定位故障。
图纸必须与最终设备状态一致。现场如果改过端子、线缆、光源或安装支架,应更新图纸版本,并在发布或变更记录中说明改动。继续使用旧图纸的风险不只是资料不完整,它可能主动把维修人员引向错误端子、错误供电或错误安装位置。图纸还应与设备编号、版本日期和必要的修订说明关联,避免同一项目流传多份无法区分的副本。
操作、维护、测试与培训
操作手册面向生产人员,围绕日常场景编写:启动、停机、配方切换、结果查看、常规报警确认和数据导出。它应让操作员在压力下知道前置条件、操作动作、正常结果和异常时的升级路径。操作员需要的是清楚的步骤和判断,不需要完整的接线图或标定推导。
维护手册面向工程和维修人员,围绕部件和故障路径组织:镜头清洁、光源检查、触发验证、文件备份、系统恢复、重新标定和故障定位。维护人员需要端子号、部件关系、故障树、恢复顺序和完成判据。后续开发人员还需要设计说明、接口契约和变更历史,这些内容又不应塞进操作员的日常步骤中。
把不同读者合并成一份手册,往往会产生两个问题:操作步骤被接线、版本和诊断细节淹没,维护信息却仍然不够深。更合适的组织方式是按读者拆分,互相引用共同的设备编号、配方名称和版本标识。手册还要说明危险操作的前置状态、备份要求和回退方式,避免读者在错误模式下执行标定或参数写入。
测试文档把“看起来能工作”转换为“在规定条件下完成了验证”。它通常包括测试计划、样本组成、测试步骤、版本信息、原始结果、异常说明、复测结论和问题关闭状态。测试计划先规定测什么、怎么测、使用什么版本,结果记录再说明实际发生了什么,二者不能只留下一个“通过”。
如果验收关注漏检率、误报率、节拍稳定性、重复性或误触发率,文档要写明样本总数、缺陷类别、工况范围、统计分母和判定阈值。样本的批次、工件姿态、光照、速度和温度范围也要记录。否则同一个百分比可能来自不同样本规模和不同现场条件,后来人员无法判断它是否支持当前工况。
已知失败条件、边界样本和需要人工复核的异常样本同样属于交付内容。它们定义了系统能力的边界,告诉客户自动结果在什么条件下可以信任,什么时候需要停机、复核或重新采集。只保存通过样本,会把最重要的限制从交付资料中删除。
培训资料回答客户怎样使用系统,应包含角色定义、常用操作、报警处理、典型错误和注意事项。安装与部署资料回答设备怎样被重建或迁移,应包含软件安装顺序、驱动和 SDK(Software Development Kit,软件开发工具包)版本、网络设置、目录结构、许可证位置,以及模型、配方和标定文件的恢复步骤。
视觉系统发生磁盘损坏、IPC(Industrial Personal Computer,工业计算机)更换或许可证失效时,恢复工作依赖部署资料。没有安装顺序和文件清单,维护人员只能重新猜测依赖和路径,停机时间也会随之增加。部署文档应和备份包一起演练,在一台测试设备或备用设备上验证恢复后能否采图、加载模型、读取配方、完成标定并通过基本样本。
文档还应明确哪些内容可以由客户现场人员完成,哪些步骤需要项目工程师或授权维护人员参与。培训签到说明谁接受了哪些内容,部署记录说明使用了哪一版软件和驱动。这样,恢复过程才能按记录执行,而不是把整个项目重新开发一次。
文档完整性的影响算例
下面比较四种故障场景在资料完整和资料不完整时的示例排障时间。数字是教学假设,没有取自售后工单统计。四个场景分别对应前文的设计与接线资料、维护手册、测试与验收资料,以及安装和备份资料。
| 场景 | 有完整文档(小时) | 无完整文档(小时) | 时间倍率 |
|---|---|---|---|
| 更换相机或光源 | 1.5 | 6.0 | \(6.0\div1.5=4.0\) |
| 排查无效报警根因 | 2.0 | 9.0 | \(9.0\div2.0=4.5\) |
| 处理缺陷定义争议 | 1.0 | 5.5 | \(5.5\div1.0=5.5\) |
| 工业计算机故障后完整重建 | 4.0 | 22.0 | \(22.0\div4.0=5.5\) |
时间倍率定义为:
\(T_{\mathrm{without}}\) 是缺少完整文档时的排障时间,\(T_{\mathrm{with}}\) 是资料完整时的排障时间,二者单位都是小时。以工业计算机故障后的完整重建为例:
这个结果表示在本算例条件下,缺少安装顺序、许可证位置、备份内容和恢复步骤,排障时间是资料完整时的 5.5 倍。它用于说明知识缺口的相对代价,不是所有项目的服务工时预测。相机或光源更换的倍率较小,也不能说明相关图纸和标定资料可以省略;每种场景仍需要正确的具体资料。
图 84-2 的横向柱比较每个场景的两种时间,倍率用于观察相对放大程度。读图时特别关注完整重建和缺陷定义争议,因为这些工作需要从文档恢复设计假设、版本边界或验收定义,无法仅靠现场人员记忆补齐。
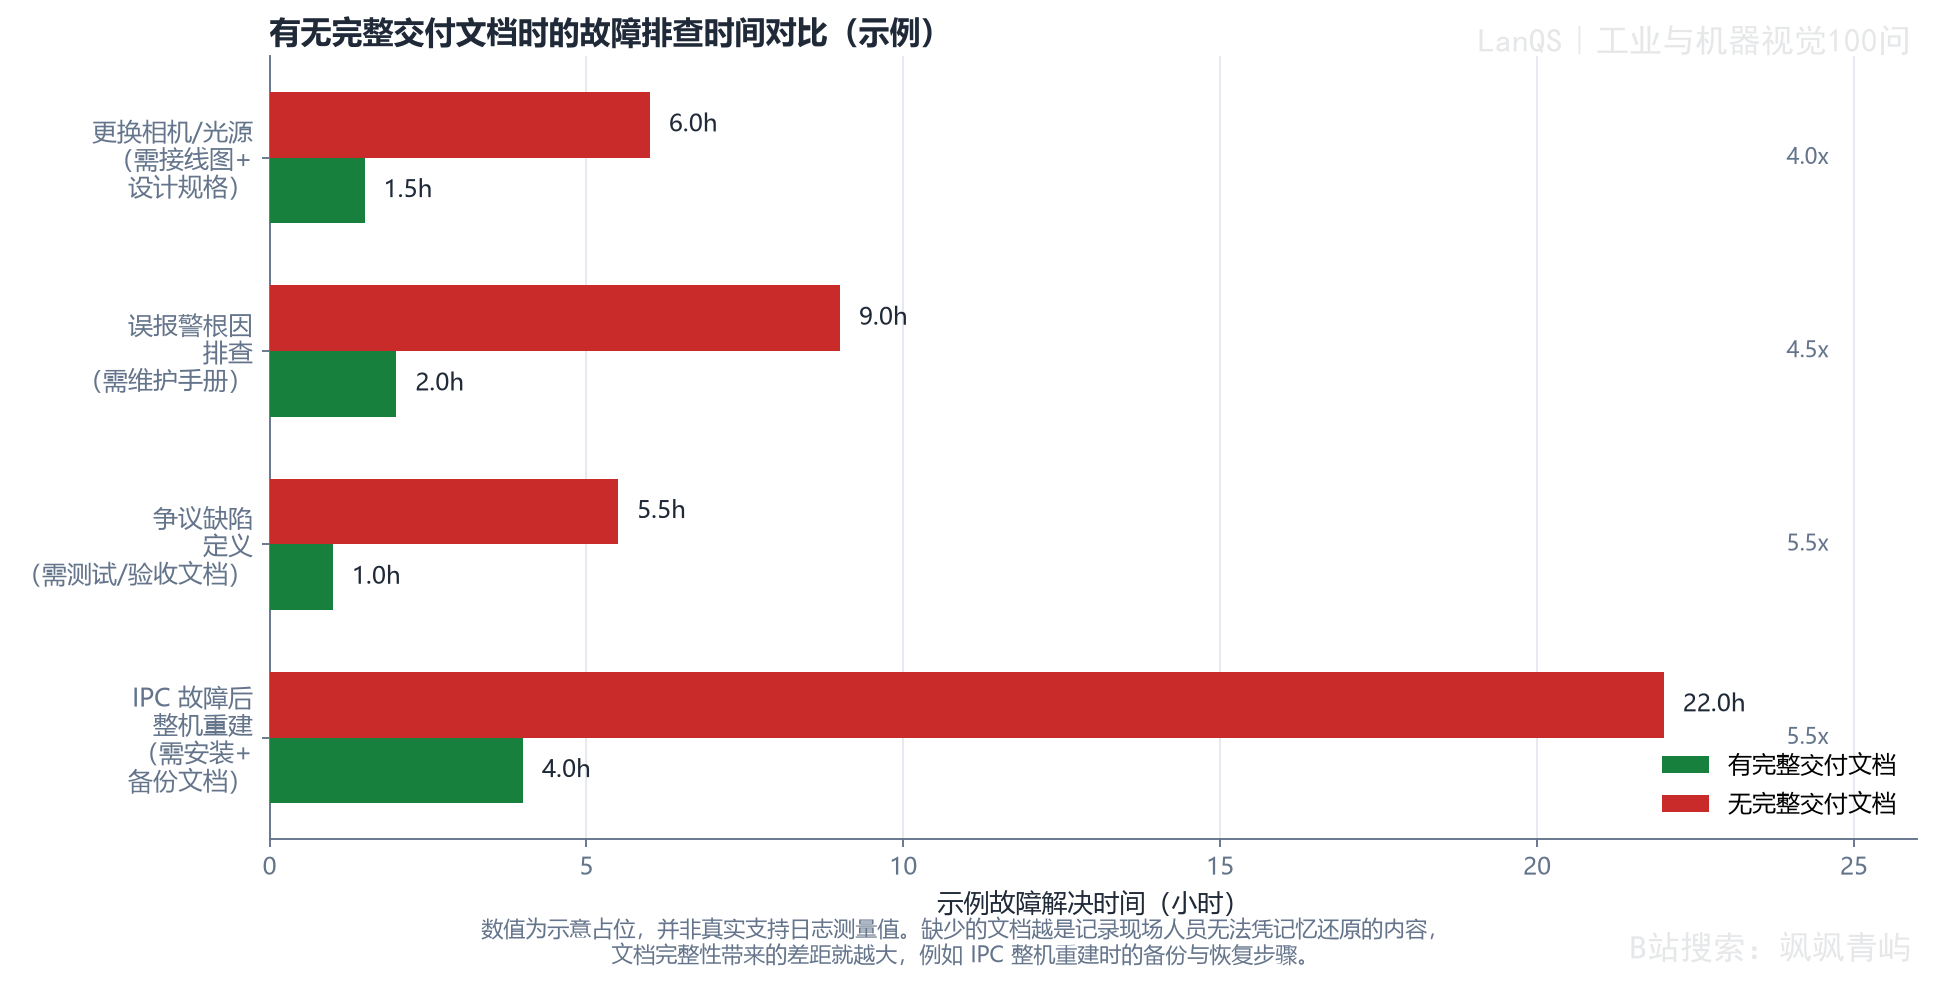
图 84-2 完整与不完整交付文档对不同排障场景的示例影响
验收与项目差异化
验收资料通常包括验收标准、验收测试计划和记录、问题关闭清单、最终版本清单以及双方签署文件。若项目采用分阶段验收,还应保留中间验收记录和阶段问题状态,避免所有历史问题直到最终签署前才集中出现。
最终版本清单要同时固定软件、模型、配置、标定文件和参数基线。它还应记录测试时使用的样本范围、工况、指标口径和未覆盖边界。这样,后续性能漂移才有可能区分为原始交付问题、现场变更或运行环境变化。签署文件应明确测试范围、未覆盖条件、遗留问题、维护责任和回退依据,不能只留下一个“验收通过”。
验收文档与实际交付包要相互对应。文件中的版本号、设备编号、图纸修订号和备份清单应能在客户拿到的目录中找到;如果签署的是一套版本,交付后又替换了模型或配置,必须留下新的变更记录和复验结论。验收边界只有与实际设备状态绑定,才具有追溯价值。
软件型项目更重视版本、接口、配置、部署和操作说明;设备型项目更重视接线、机械布局、保养、备件和安全注意事项;整线工程还需要设备间协调、节拍同步、控制策略和现场验收流程。资料深度应与任务复杂度、恢复要求和参与方数量相匹配。
三类项目都必须回答四个问题:系统怎样构建,怎样运行,怎样维护,怎样追溯。小项目容易依赖一个人的记忆,人员一旦更换,风险反而很快暴露;项目规模小不等于可以省略版本、图纸、边界和恢复步骤。对于简单项目,可以减少形式和重复内容,但不能删除完成真实任务所需的事实。
文档交付后还需要有负责人。软件、图纸、操作手册、维护手册和验收基线的更新触发条件应写入变更流程。下一次参数、接线或模型变化时,变更单同时标出需要更新的资料,才能防止文档悄悄落后于设备。
常见误区
- 把操作手册写成维护手册,或只堆叠界面截图,导致操作员找不到报警处理路径,维护人员又找不到部件和恢复信息。
- 只记录通过样本,不记录已知失败边界、异常样本和人工复核条件。
- 只检查文件是否存在,不让目标读者实际完成启动、报警处理、备份恢复或图纸核对任务。
- 接线、参数、模型或软件变化后,图纸、手册和验收版本基线仍保持旧版。
- 用一份文件服务所有读者,结果对操作员太复杂,对维护人员又不够深入。
- 只把验收签署理解为项目结束,不保存测试条件、未覆盖边界和最终版本清单。
- 交付后没有文档负责人,资料逐渐过时并主动误导后来人员。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| 设计说明书 | 解释系统设计约束、选择理由、关键计算和适用边界的文件。 |
| 接线图 | 规定设备连接、端子编号、信号方向和线缆去向的图纸。 |
| 电气原理图 | 表达供电、保护、输入输出映射和控制关系的图纸。 |
| 机械图 | 表达安装位置、尺寸、公差、工作距离和可调范围的图纸。 |
| 操作手册 | 面向生产人员、按日常场景说明运行和报警处理的文件。 |
| 维护手册 | 面向工程或维修人员、按部件和故障路径说明保养、恢复和诊断的文件。 |
| 验收基线 | 由验收标准、测试记录、签署结果以及软件、模型、配置和标定版本共同确定的交付边界。 |
| 变更控制 | 对系统变化进行提出、评审、批准、发布、记录,并同步更新相关资料的过程。 |
| \(M\) | 缺少完整文档时的排障时间与拥有完整文档时的排障时间之比。 |
| QA | Quality Assurance,质量保证或质量验收职能。 |
| I/O | Input/Output,输入/输出。 |
| SDK | Software Development Kit,软件开发工具包。 |
| IPC | Industrial Personal Computer,工业计算机。 |
| MES | Manufacturing Execution System,制造执行系统,用于记录工单、批次和生产过程信息。 |
延伸阅读
- IEEE Std 1063-2001(R2015):软件用户文档的结构参考。
- ISO/IEC/IEEE 15289:2019:系统与软件生命周期信息项的内容分类。
- Forsgren、Humble、Kim:《Accelerate》,讨论变更控制、交付过程和文档维护。
- IEC 62061、ISO 12100:机器安全、风险评估和安全相关技术文档背景。
第85问 如何估算工业视觉项目的总体成本?(硬件、软件、开发与维护)
模块:软件工程、系统架构与项目交付
项目预算经常从相机、镜头和工控机的采购价开始,但一套可以验收并长期运行的视觉系统还要经历样本采集、算法开发、接口接入、现场联调、培训、备件和后续维护。估算时先明确检测目标、节拍、环境、接口、验收口径和计划寿命,再把费用拆成硬件、软件、开发和维护四个维度。每一项都应有输入、工作包、交付物和复盘依据。本题先建立四类成本的边界,再给出硬件、开发和生命周期公式,以及一个简单单工位项目与复杂多工位项目的完整算例。
成本结构与估算维度
硬件决定成像能力和物理安装范围,软件决定运行平台、接口和授权模式,开发费用承担把概念变成可运行并通过验收的工程工作,维护费用则在交付后随着产线运行继续发生。只把相机、镜头和工业计算机相加,得到的是一部分采购成本,不是系统的总体成本。一个采购价看起来可接受的项目,可能因为样本不足、现场调试和多年支持没有计入而难以持续运行。
四类费用的责任人、计价方式和发生时间不同。硬件通常由物料清单和采购报价支撑,软件可能按节点、并发数、订阅期限或升级服务计价,开发需要按角色和工作量估算,维护则与备件、响应时间、模型漂移和运行年限有关。把它们混在一行总价中,既无法解释预算依据,也无法知道超支发生在哪个环节。
分类还要处理交叉边界。光源控制器可能随相机套装采购,但物料清单仍应单独列出;现场安装可能由开发团队完成,却包含机械改造、电气接线和防护,不能全部归入软件调试。目标节拍和运行班次会改变计算和维护压力,粉尘、油雾、振动和温度变化会改变防护与备件需求,验收标准则会改变样本数量和返工风险。
图 85-1 是查漏项的框架。先看顶部四个成本桶,再看每个桶下面对应的物料或工作包,最后问这些项目由谁交付、怎样验收、交付后怎样维护。图中的比例是示意比例,不能直接当作后文两个项目的固定比例。
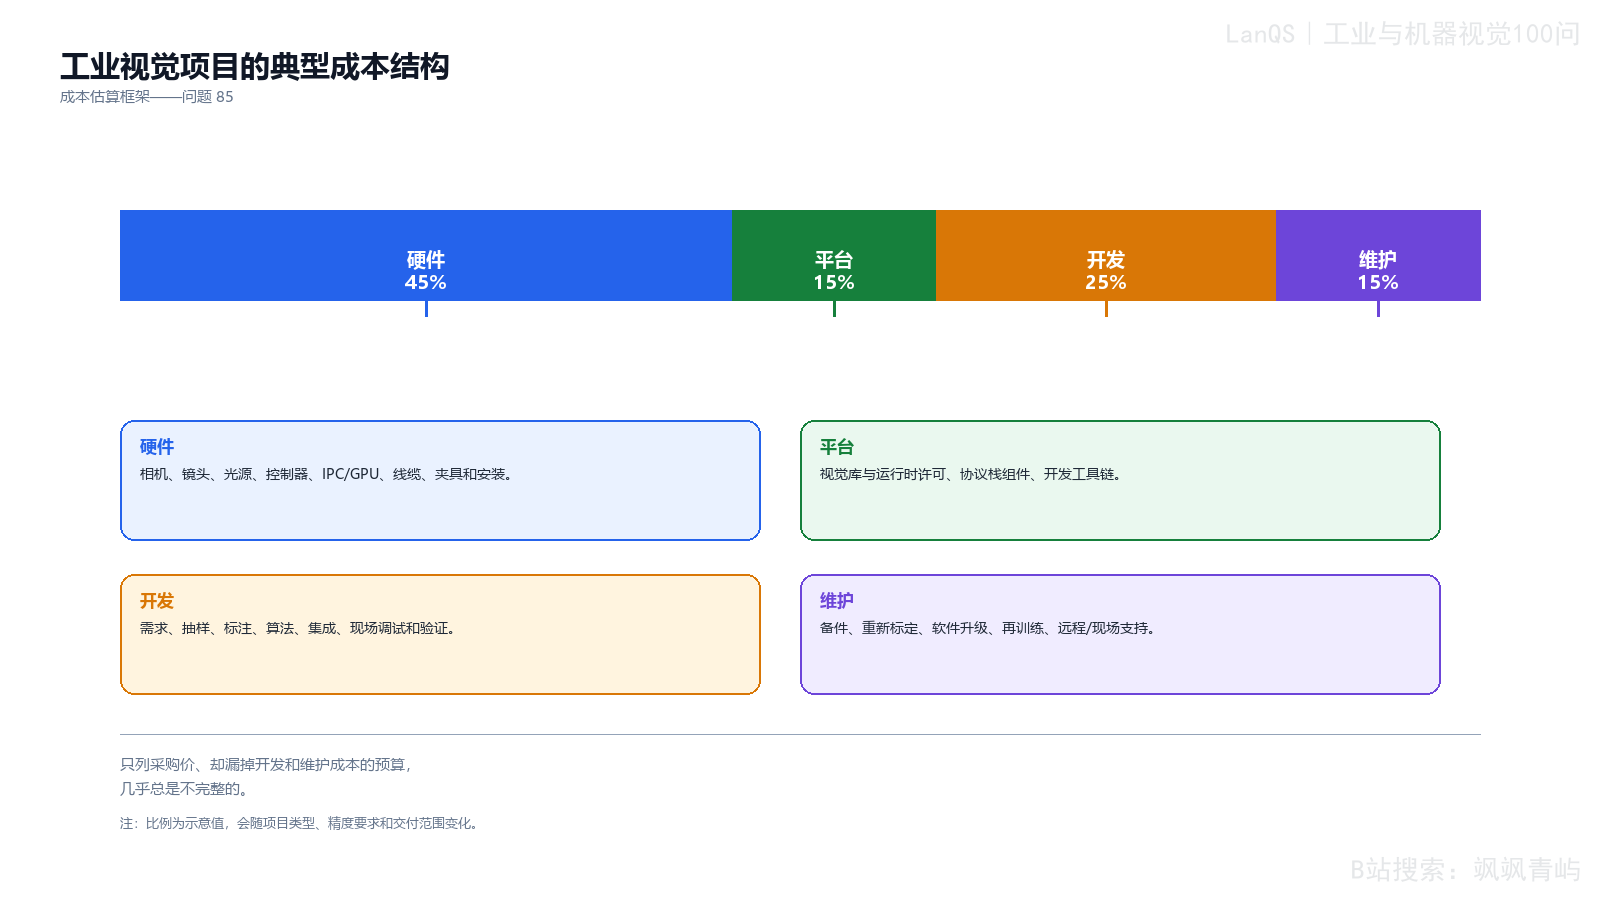
图 85-1 工业视觉项目的典型成本结构
图中的四类比例用于提醒预算人员:硬件、平台、开发和维护都可能产生费用。精密测量项目可能增加成像和机械成本,复杂缺陷项目可能增加开发和数据成本,连续运行项目可能增加备件与支持成本。图适合检查分类是否完整,不提供具体报价,也不能替代按需求和历史数据建立的估算表。
硬件估算应从完整成像链开始,而不是只数相机数量。相机、镜头、滤光片、光源、光源控制器、触发器和同步部件共同决定能否取得合格图像。多视角或多工位系统要按完整成像单元核算。高分辨率相机会增加带宽和存储压力,短曝光可能提高光源亮度和控制器要求,远心镜头的成本则可能换来更小的透视误差和更少的测量返工。这里的因果关系要写进设计假设,不能只在物料表中列出器件名称。
计算链包括工业计算机、GPU(Graphics Processing Unit,图形处理器)、内存、系统盘、数据盘、采集卡和显示设备。分辨率、帧率、模型推理时间、并发相机数、缓存长度和数据保留周期共同决定计算规格。通信链则要列出交换机、现场总线或工业以太网接口、PLC 接口、编码器、I/O(Input/Output,输入/输出)模块、隔离器和连接器。若只按“工控机一台”估算,带宽、缓存和接口的费用容易在现场集成阶段才暴露。
安装链包括支架、防护罩、拖链、配电、接地、散热、线缆、端子、运输和现场安装。粉尘、油雾、振动、温度变化和清洗要求会增加防护和维护成本。连续生产线还要结合关键部件交期、替换时间和停机代价决定是否准备备用相机、光源、线缆或计算设备。备件不是简单按主设备数量复制,应该说明它要降低哪一种停机风险。
为了把主系统、备件和安装费用分开,可以写成:
\(C_{\mathrm{hw,plan}}\) 是计划硬件成本,\(C_{\mathrm{hw,run}}\) 是主系统运行硬件,\(C_{\mathrm{spare}}\) 是备件,\(C_{\mathrm{install}}\) 是安装、配电、线缆和防护费用,单位均为货币。这个分解适用于预算结构检查,不能自动给出故障概率或最佳备件数量。备件数量还要结合部件交期、现场替换能力和允许停机时间确定。
开发、维护与项目差异
软件费用可以分为平台层和项目层。平台层包括视觉开发平台、运行时授权、操作系统、数据库、通信驱动、设备 SDK(Software Development Kit,软件开发工具包)和部署工具;项目层包括检测流程、标定、配方、图像记录、追溯、报警、权限、报表,以及与 PLC、MES(Manufacturing Execution System,制造执行系统)或机器人交互的功能。平台提供运行基础,项目功能决定客户实际能做什么,两者不能用一个“软件费”笼统替代。
平台授权可能按节点、并发数、订阅期限和升级服务计价。多工位部署要核对每个运行节点和服务器是否需要授权,还要检查授权是否绑定硬件、是否支持离线运行、升级服务包含什么。开发许可证、调试工具、测试数据存储和模型制品仓库可能不安装在每台设备上,却是持续交付所需的组成部分。
开源库可能没有采购授权费,但版本维护、漏洞修复、兼容性测试、培训和供应链审查仍然需要成本。这些费用应计入 TCO(Total Cost of Ownership,总拥有成本)。把开源理解成零成本,会把费用从采购表转移到开发和维护,却不会让工作消失。软件估算还要区分一次性开发、每节点运行和每年续费,避免不同周期的费用直接相加后无法解释。
开发成本的主要差异来自工程工作量和不确定性,不是代码行数。需求澄清要确定缺陷定义、节拍、视场、触发、上下料、接口、环境和验收口径;可行性验证要采集正常、缺陷、边界和干扰样本;数据工作要规定标注、复核、数据版本及难例管理。算法工作还要覆盖预处理、定位、分类、测量、判定和拒检策略。
这些工作完成后,仍需开发界面、配方、日志、权限、异常恢复和通信,完成现场联调、部署、测试和培训。算法工程师、HMI 工程师、电气工程师和测试工程师的费率可能不同,因此应按工作包和角色估算,而不能给整个项目套一个统一人月单价。标注可以按图像数或类别复杂度估算,接口接入可以按接口数量和现场联调次数估算,调试可以按工位估算。
风险储备要和证据对应。成熟算法、熟悉相机、客户接口稳定的项目,常见风险项可以预留约 10% 到 15%;样本不足、材料变化大、缺陷定义不稳定或首次使用新技术时,应对受影响的新颖工作单独预留 30% 以上。这个比例是估算规则的示例,不能不加分析地涂到所有工作包。若历史项目中反光表面导致现场调试比原估算多 40%,类似项目应增加调试储备,而不是无差别提高硬件、软件和维护预算。
开发成本可以写为:
\(h_i\) 是第 \(i\) 个工作包的预计工时,单位为人时;\(r_i\) 是该工作包的小时费率,单位为货币/人时;\(m\) 是工作包数量;\(p_{\mathrm{risk}}\) 是根据风险证据设置的储备,单位为货币。若使用人月,必须预先规定一个人月对应的有效工作小时,并把不同角色的费率分开。这个公式能约束估算结构,不能自动发现漏项、重复计价或错误的工时假设。
一个可复核的成本算例
下面比较两个示例项目:一个简单单工位项目,一个复杂多工位项目。所有金额以千货币单位计,是用于说明结构的构造值,不是实际采购报价。简单项目使用规则算法,复杂项目包含 6 个工位、多缺陷类别和深度学习数据集。算例要检查两件事:先按四类成本求出上线前总额,再按年度维护计算生命周期成本。
| 成本类别 | 简单项目 | 简单项目占比 | 复杂项目 | 复杂项目占比 |
|---|---|---|---|---|
| 硬件 \(C_{\mathrm{hw}}\) | 75 | 51.4% | 315 | 35.7% |
| 软件 \(C_{\mathrm{sw}}\) | 10 | 6.8% | 73 | 8.3% |
| 开发 \(C_{\mathrm{dev}}\) | 51 | 34.9% | 415 | 47.0% |
| 第 1 年维护准备 \(C_{\mathrm{maint,0}}\) | 10 | 6.8% | 80 | 9.1% |
| 总额 \(C_{\mathrm{total}}\) | 146 | 100% | 883 | 100% |
两类项目的细项如下:
| 成本链 | 简单项目明细 | 金额 | 复杂项目明细 | 金额 |
|---|---|---|---|---|
| 硬件 | 成像链(相机、镜头、光源、触发) | 45 | 成像链(6 工位、中档相机) | 165 |
| 硬件 | 计算链(无需 GPU 的工控机) | 18 | 计算链(共享工控机、GPU 和交换机) | 95 |
| 硬件 | 安装链(夹具、线缆、防护) | 12 | 安装链(6 套夹具、线缆和机柜) | 55 |
| 软件 | 视觉库/运行时授权 | 8 | 视觉库/运行时授权(6 节点和服务器) | 40 |
| 软件 | 工具链 | 2 | 数据库、协议栈和运维平台组件 | 25 |
| 软件 | 无 | 0 | 工具链 | 8 |
| 开发 | 需求与样本采集 | 10 | 需求与多缺陷样本采集 | 40 |
| 开发 | 规则算法开发 | 20 | 深度学习缺陷集标注(12 类以上) | 60 |
| 开发 | 集成与在线调试 | 15 | 规则与深度学习多缺陷算法开发 | 165 |
| 开发 | 验证与验收支持 | 6 | 跨工位集成与调试 | 110 |
| 开发 | 无 | 0 | 验证与验收支持 | 40 |
| 维护(第 1 年) | 备件(光源、镜头、线缆) | 4 | 备件(6 工位) | 20 |
| 维护(第 1 年) | 远程/现场支持 | 6 | 远程诊断平台与现场支持 | 38 |
| 维护(第 1 年) | 无 | 0 | 样本漂移后的模型重训 | 22 |
硬件小计分别为 \(45+18+12=75\) 和 \(165+95+55=315\);软件小计分别为 \(8+2=10\) 和 \(40+25+8=73\);开发小计分别为 \(10+20+15+6=51\) 和 \(40+60+165+110+40=415\);第 1 年维护准备分别为 \(4+6=10\) 和 \(20+38+22=80\)。上线前总额按式(85-1)的四类成本口径计算:
简单项目代入为:
硬件占比为 \(75/146\approx51.4\%\),开发占比为 \(51/146\approx34.9\%\)。复杂项目代入为 \(315+73+415+80=883\),硬件占比约为 \(315/883\approx35.7\%\),开发占比约为 \(415/883\approx47.0\%\)。这组数字说明从单工位规则检测转向多工位、多缺陷和深度学习后,开发工作可能成为主要成本;它不能证明所有类似项目都具有这些比例。
完整算例按字典保存每个成本类别及明细,先求类别小计,再计算总额和百分比,并检查简单项目的硬件占比高于复杂项目、复杂项目的开发占比高于简单项目。等价的核心逻辑如下:
def subtotal(scenario):
    return {category: sum(items.values())
            for category, items in scenario.items()}

def summarize(profile):
    sub = subtotal(profile)
    total = sum(sub.values())
    share = {category: 100 * value / total
             for category, value in sub.items()}
    return {"subtotal": sub, "total": total, "share": share}

simple_results = summarize(simple_station)
complex_results = summarize(complex_multistation)
simple_sub = simple_results["subtotal"]
complex_sub = complex_results["subtotal"]
print(simple_results)
print(complex_results)

assert simple_results["share"]["Hardware"] > complex_results["share"]["Hardware"]
assert complex_results["share"]["Development"] > simple_results["share"]["Development"]
生命周期部分先取四类中的前三类作为上线前投入,再按年度维护序列累加。算例使用的维护序列是简单项目 [10, 11, 12],复杂项目 [80, 78, 92],相应的计算可以写成:
simple_init = simple_sub["Hardware"] + simple_sub["Software"] + simple_sub["Development"]
complex_init = complex_sub["Hardware"] + complex_sub["Software"] + complex_sub["Development"]

simple_maint_by_year = [10, 11, 12]
complex_maint_by_year = [80, 78, 92]
simple_life = simple_init + sum(simple_maint_by_year)
complex_life = complex_init + sum(complex_maint_by_year)

print(simple_init, simple_life)    # 136, 169
print(complex_init, complex_life)  # 803, 1053
生命周期计算要避免把第 1 年维护准备重复相加。令不含年度维护的上线前投入为 \(C_{\mathrm{init}}=C_{\mathrm{hw}}+C_{\mathrm{sw}}+C_{\mathrm{dev}}\),第 \(y\) 年维护成本为 \(C_{\mathrm{maint}}(y)\),不考虑折现时:
\(C_{\mathrm{life}}\) 是计划运行周期内的生命周期成本,\(C_{\mathrm{init}}\) 是上线前硬件、软件和开发投入,\(C_{\mathrm{maint}}(y)\) 是第 \(y\) 年维护成本,\(N\) 是运行年数,单位均为千货币单位。简单项目的 \(C_{\mathrm{init}}=75+10+51=136\),三年维护为 10、11、12:
复杂项目的 \(C_{\mathrm{init}}=315+73+415=803\),三年维护为 80、78、92:
这里的维护序列同样是示例数。式(85-1)用于上线前总额的报价口径,式(85-2)用于按年度维护观察生命周期负担;前者包含第 1 年维护准备,后者把各年度维护单独列出,台账中不能把同一笔费用同时放进两种口径。生命周期公式也没有计入停机损失、产能机会成本和资金时间价值,投资决策需要另外说明这些假设。
图 85-2 左侧比较两个项目的初始成本结构,右侧显示从上线前投入到第 3 年的累计成本。读图时先核对 146 和 883 的四类小计,再检查 136、803 与 169、1053 的年度累加关系。图中百分比和金额是算例输入,不是固定报价。
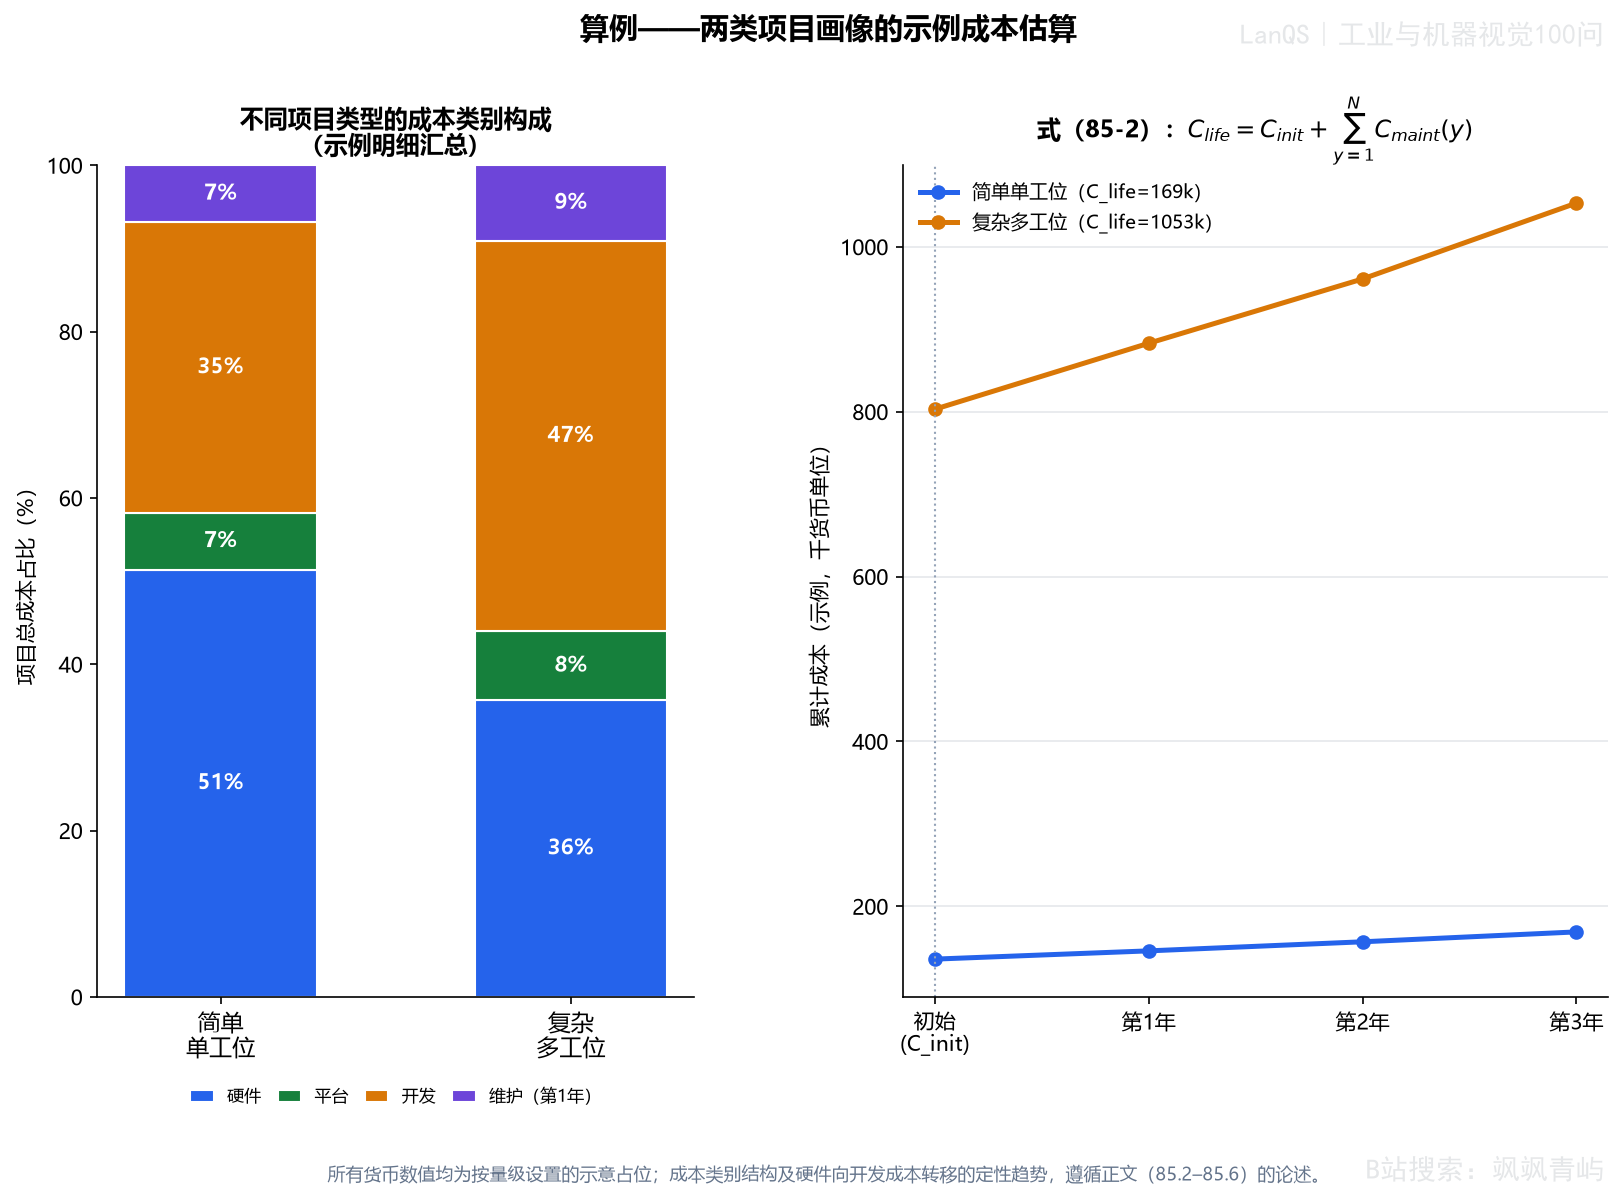
图 85-2 简单项目与复杂项目的初始投入和维护成本比较
图中金额单位是千货币单位,左侧百分比由四类成本除以项目总额得到,右侧累计曲线使用式(85-2)逐年加上维护费用。简单项目的硬件占比更高,复杂项目的开发占比更高;这个方向与项目结构有关,不能据此预测实际故障率、服务合同金额或停机损失。
维护费用不只在设备坏掉后才发生。光源老化、镜头和保护窗清洁、触发与标定复核、软件升级、报表字段变更、样本分布变化后的模型重训、远程诊断和现场差旅,都会在运行周期内产生工作。每项单独看可能不大,累积到两三年后却可能超过一次性的部分采购价。
维护成本还受到项目设计质量影响。文档完整、参数结构清楚、日志和远程诊断能力较好的系统,问题更容易定位;每次异常都必须派工程师到现场的系统,会持续增加差旅和响应成本。维护估算应把例行维护、维修与备件、模型或规则维护、服务与培训拆开:
式中各项分别表示第 \(y\) 年的例行维护、维修与备件、模型或规则维护、服务与培训,单位为货币。这个分解便于将偏差归因到具体工作包,但四项并非完全独立。例如更换光学部件可能同时触发重新标定和模型复核,报价时需要规定哪些工作包含在部件服务中。
低估维护和支持费用可以使初始报价看起来更低,但服务响应、升级、备件和模型维护工作并不会因此消失,后续可能转化为合同争议或供应商的无准备支持。反过来,把大额且没有依据的储备均匀加到所有条目,也会掩盖实际不确定性。储备应对应样本质量、现场光照、边界缺陷、接口协议和历史偏差等具体来源。
硬件采购通常最容易得到可靠报价,开发和现场调试却更容易超支,因为样本质量、边界缺陷、光照、机械条件和接口协议可能到调试阶段才暴露。维护响应时间、备件范围、模型更新责任和升级次数,应在交付前写入合同或服务说明,不能只在预算表中留一个无定义的维护百分比。
模型化估算与成本控制
高精度测量项目的硬件占比往往较高,因为远心镜头、稳定光源、精密机械和标定要求会推高成像链投入。复杂缺陷识别项目更容易把预算推向样本、标注、算法和验证。多工位联网项目则会增加通信、部署和运维平台的工作量。这里的“占比”是相对于当前项目总额的结构判断,不是可跨项目复制的费率。
更可靠的做法是先找项目瓶颈。成像难点突出时,硬件和在线调试可能是成本中心;缺陷定义复杂且变化大时,数据和开发决定工期;需要跨工厂复制并长期运行时,标准化设计、部署平台、诊断、备件和维护服务的权重会增加。采购价最低的方案未必降低总体成本,因为它可能把风险推给现场调试和后续维护。
有依据的估算不要求第一版就精确到最后一位,而要求结构完整、假设透明,并能随着信息增加更新。需求指标至少应记录精度、节拍、环境复杂度、产品种类、验收标准和交付范围;在此基础上建立部件选择矩阵、工作量矩阵和风险储备矩阵。每个条目要写明单位、数量或工时、费率、来源和交付责任。
风险储备应单列,不能悄悄平均到所有条目。样本质量、现场条件和边界缺陷定义通常是视觉项目的不确定性来源;如果完全不留储备,在线调试开始后预算很容易失真。储备也不能脱离证据随意设定,应该引用相似历史项目的偏差、当前项目的新技术和未验证接口。
项目执行期间,要沿用同一套类别结构记录实际发生值。工时按阶段和角色登记,采购单按硬件子链归类,支持工单按原因标记。项目结束时逐项比较估算、批准预算、变更金额和实际值。总额没有超支,也可能隐藏开发阶段超支 50% 而硬件降价抵消;按类别和工作包复盘,下一次估算才能定位偏差来源。
偏差原因要具体记录,例如交期导致替代采购、现场光照或机械结构变化、样本重采集、接口协议变化、验收反复、模型重训或服务响应超出合同。需求变化应单独建立变更单,说明增加的金额、工期和验收影响,不能用新预算覆盖原始基线。这样才能区分“原估算不准”和“客户后来增加了范围”。
成本控制的依据是把投入与风险对应起来,而不是简单压低每一项价格。可行性样本通过后再冻结主要硬件规格,可以减少反复采购;为相机、镜头、光源、计算设备和接口建立替代清单,可以提前说明替代后哪些指标必须重新验证。平台通用能力应沉淀日志、配方、权限、诊断和部署机制,项目定制能力则按检测需求独立估算。
数据采集、标注、复核、难例闭环和验收测试要作为独立工作包列入计划。项目可以设置阶段门:可行性通过后扩大采购,接口联调通过后批量部署,验收数据满足统计口径后关闭项目。停机代价高的部件配置合理备件和快速更换结构,低关键度部件不必为了整齐而过度冗余。
日志、版本、配置和图像留存会增加初始开发工作,却能降低故障定位和模型维护成本。控制成本时要把采购、开发、部署和维护放在同一条生命周期链上,检查短期节省是否把风险转移到更昂贵的现场服务、返工或停机。成熟的成本控制最终表现为边界清楚、风险可见、数据可复盘的系统。
常见误区
- 只把相机、镜头和工控机相加,遗漏软件、安装、接口、数据、验收和维护。
- 把算法开发当成固定单价,忽略样本质量、缺陷复杂度、节拍和现场差异。
- 把风险储备均匀加到每个条目,不说明新颖元素和历史偏差依据。
- 把第 1 年维护准备同时放入项目总额和生命周期上线前投入,造成重复计算。
- 忽略触发、握手、剔除、追溯、异常恢复和验收测试等集成工作。
- 只看初始投入,不比较备件、升级、模型维护、服务响应和停机代价。
- 用变更后的预算覆盖基线,无法区分估算偏差与需求变化。
- 把开源软件当成没有开发和维护成本,或者把硬件替代当成无需重新验证。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| TCO | Total Cost of Ownership,总拥有成本,覆盖采购、部署、运行和维护。 |
| \(C_{\mathrm{hw,plan}}\) | 计划硬件成本,包含运行硬件、备件和安装费用。 |
| \(C_{\mathrm{hw}}\) | 成像、计算、通信、安装和防护等硬件成本。 |
| \(C_{\mathrm{sw}}\) | 平台授权、运行环境、驱动、数据库和项目软件功能成本。 |
| \(C_{\mathrm{dev}}\) | 需求、数据、算法、集成、调试、部署和验收的开发成本。 |
| \(C_{\mathrm{maint,0}}\) | 项目总额中预先计入的第 1 年维护准备。 |
| \(C_{\mathrm{total}}\) | 按式(85-1)计算、包含第 1 年维护准备的项目总额。 |
| \(C_{\mathrm{init}}\) | 生命周期计算中不含年度维护项的上线前硬件、软件和开发投入。 |
| \(C_{\mathrm{maint}}(y)\) | 第 \(y\) 年维护成本。 |
| \(C_{\mathrm{life}}\) | 计划运行周期内初始投入与各年度维护费用之和。 |
| \(p_{\mathrm{risk}}\) | 根据已识别不确定性设置的风险储备。 |
| 人时/人月 | 工作量单位;使用人月时必须规定有效工作小时和角色费率。 |
| 冗余 | 为降低单点故障或缩短恢复时间配置的备用部件或通道。 |
| GPU | Graphics Processing Unit,图形处理器。 |
| PLC | Programmable Logic Controller,可编程逻辑控制器。 |
| MES | Manufacturing Execution System,制造执行系统。 |
| SDK | Software Development Kit,软件开发工具包。 |
| IPC | Industrial Personal Computer,工业计算机。 |
延伸阅读
- Boehm, B. W.,《Software Engineering Economics》,Prentice-Hall,1981。讨论软件工程成本估算和开发工作量的不确定性。
- McConnell, S.,《Software Estimation: Demystifying the Black Art》,Microsoft Press,2006。介绍历史项目比较、工作量估算和风险储备。
- Project Management Institute,《A Guide to the Project Management Body of Knowledge(PMBOK Guide)》。涉及成本管理、风险管理和项目复盘。
- ISO 21500 或 ISO 21502,《Project, programme and portfolio management》。提供项目成本计划与控制的通用背景。
第86问 算法处理一帧需要 100 ms,但产线要求每 80 ms 得到一个结果,怎么办?
产线给出的“每 80 ms 一个结果”看起来像一个简单的速度比较题,实际涉及两种不同的时间约束。一种约束要求同一件工件的图像在 80 ms 内完成采集、分析并驱动后续动作,另一种约束只要求系统持续提供结果,结果可以在流水线中错开到达。两种约束对应不同的优化手段。本问从阶段计时开始,依次讨论算法、硬件、流水线、异步处理和需求定义,最后给出一套可验收的系统方案。
关键判断是:100 ms 通常描述单帧从输入到输出的端到端延迟,80 ms 描述业务节拍或结果到达间隔。只有在下游动作必须等待同一帧的结果时,二者才是直接的同一指标。若产线只关心稳态吞吐,流水线可以改善结果到达间隔,却不会缩短某一帧实际经历的时间。
延迟拆解与优化边界
一帧图像从触发到结果输出,通常要经过曝光与采集、数据传输、预处理、特征计算或模型推理、后处理、通信输出,有时还包括原图保存。工程人员若只看到模型接口返回了一个 100 ms,就不知道这 100 ms 中有多少真正用于计算。图像上传、内存拷贝、磁盘写入或 PLC(Programmable Logic Controller,可编程逻辑控制器)握手等待,都可能占据大部分时间。
因此,先给每个阶段加上开始和结束的时间戳,再决定是否需要更换网络。对第 \(i\) 个阶段,记其耗时为 \(t_i\),所有时间统一用毫秒(ms)表示。在严格串行的执行方式中,单帧端到端延迟为
这里的 \(T_{\mathrm{serial}}\) 是从该帧进入采集链到最终结果完成的时间,适合回答“这一帧什么时候能用”。它不等于连续帧的稳态吞吐周期。若采集、传输和推理存在并行,单帧延迟仍应沿这帧的实际路径计算,不能把所有线程的总时间简单相加。
测量工具也会影响结论。软件计时应使用单调时钟,例如 Python 的 time.perf_counter(),避免系统校时导致墙上时钟向前或向后跳变。每帧都应记录阶段入口、出口、帧号和工件号,至少计算平均值、P95、P99 和最大观测值。P95 表示 95% 的观测不超过该延迟,P99 表示 99% 的观测不超过该延迟;它们反映长尾,而平均值只反映总体中心位置。
GPU 计时还要处理异步提交。CPU 调用推理接口时,可能只是把任务放入 GPU 队列,函数已经返回,内核仍在执行。若直接用 CPU 计时器包住调用,就会低估计算时间。应使用 CUDA 事件在设备侧计时,或在读取结束时间前显式同步;PyTorch 的 torch.profiler、Nsight Systems 和 Intel VTune 等工具也能帮助定位阶段重叠、等待和资源争用。
采样不能只取几次手工测量。应在数千帧真实负载上记录数据,并覆盖热机、换班、不同产品批次、网络和磁盘处于正常压力的状态。性能日志还应和检测质量日志用同一帧号或工件号关联。系统没有报错、相机仍在出图,只能说明链路在线;队列积压、丢帧、曝光状态漂移或质量降级仍可能让检测结果不再符合验收条件。
阶段埋点还要区分“等待”与“工作”。例如,推理线程等待输入队列、等待 GPU 空闲、等待锁或等待 PLC 应答时,处理器可能并没有执行有效算法。把等待时间和计算时间合并成一个 stage time,会使优化方向失真。每条记录至少应包含 frame_id、stage_name、start、end、device 和 status,并能用同一帧号重建它经过的路径。若某阶段存在重试、超时或降级,还应记录原始耗时和最终动作,避免把异常样本从统计中悄悄排除。
从这些记录可以画出一帧的时间线,并检查关键路径。关键路径是决定该帧结果最早何时可用的依赖链;图片存盘可能与结果通信并行,因而不一定属于关键路径,但若它占满磁盘带宽,又会反过来阻塞采集线程。类似地,模型平均推理时间下降,如果 CPU 到 GPU 的复制队列变长,端到端结果仍不会提前。只有先画清依赖关系,式(86-1)的各项才有明确工程含义。
当瓶颈确实位于算法计算时,可以从三个方向减少耗时。第一,减少无效像素,例如根据工件位置裁剪 ROI。ROI(Region of Interest,感兴趣区域)是限定处理范围的图像子区域,缩小它既减少像素运算,也减少背景导致的误检。第二,用结构更简单的算法替代复杂模型。在规则稳定的场景中,阈值、形态学和几何约束可能足以筛掉明显正常样本。第三,在检测质量可接受的范围内更换轻量骨干、减少特征层、量化或降低输入尺寸。
每种改动都可能改变可检出的最小缺陷。假设一条缺陷在原图中宽约 \(4\) px,把图像缩小到原来的四分之一后,缺陷在几何上只剩约 \(1\) px。实际重采样还会受到插值、对比度和噪声影响,边缘可能不再形成稳定的像素差。这个例子只说明采样风险,不能仅凭宽度换算证明缺陷一定检出或一定漏检。验证前应记录最小缺陷尺寸、最低对比度、缺陷位置和允许漏检率,再在独立困难样本集上比较召回率、误报率、定位误差和延迟分布。
剪枝和量化也需要同样的验证。量化用较低数值精度表示权重或中间特征,通常可以减小模型和显存压力,但低对比缺陷、细边缘和小目标对数值误差更敏感。输入分辨率、模型精度、批处理数量、后处理阈值都应作为测试条件记录。只报告 FPS(frames per second,每秒帧数)会掩盖单件等待时间、P99 长尾和质量损失。
优化实验最好保持相同的样本顺序、触发频率、产品组合和温度条件,一次只改变一个主要因素。先测试 ROI 裁剪,再测试模型量化或轻量骨干,最后测试线程并行,可以较清楚地知道收益来自哪里。每次变更都保存模型或规则版本、平均延迟、P95/P99、召回率和误报率,量产回归时才有明确的回退对象。
ROI 裁剪也有一个容易被忽略的代价:定位本身要耗时,定位误差还可能把缺陷裁到边界之外。若工件位置由编码器或治具保证,可以使用固定 ROI;若位置有漂移,就要把定位误差、边界扩张量和裁剪后的背景比例一起测量。扩张太小会漏掉边缘缺陷,扩张太大又会把不需要处理的像素带回模型。ROI 的收益应按“定位加裁剪后的总耗时”计算;模型输入像素减少量本身不足以说明总收益。
灰度化和早期筛选也会改变信息通道。颜色是缺陷判据时,转灰度会抹掉通道差异;快速规则把样本判为明显正常时,规则错误会阻断后续模型。适合降级的阶段必须先用困难样本做漏检测试,并保留一条能够复查原图的路径。对每项加速措施,验收记录应同时回答三个问题:它减少了哪个阶段的耗时,改善了平均值还是尾延迟,是否改变了缺陷和正常样本的混淆边界。
如果使用批处理,吞吐和单件延迟之间还会出现新的取舍。批量越大,设备越容易保持并行,但第一件图像可能要等待同批图像凑齐;批处理还会改变内存峰值和异常传播方式。单件剔除和安全控制一般需要小批量甚至单帧路径,离线批量基准不能直接代替在线验收。
GPU(Graphics Processing Unit,图形处理器)适合卷积、矩阵运算和大量像素的并行处理。FPGA(Field-Programmable Gate Array,现场可编程门阵列)适合固定数据流、低延迟和严格确定性的管线。SIMD(Single Instruction, Multiple Data,单指令多数据)指令和多核 CPU 适合数据量中等、控制逻辑较多或希望降低软件维护复杂度的项目。选择硬件时,算法结构只是一个因素,还要考虑设备成本、功耗、散热、驱动稳定性、开发周期和团队维护能力。
芯片规格表中的峰值算力不能直接换算成视觉系统的端到端延迟。CPU 到 GPU 的数据传输、显存不足造成的换入换出、线程同步、驱动调用和后处理都可能成为新瓶颈。批量推理可以提高平均吞吐,却可能让某件工件等到同批其他图像完成后才得到结果。GPU 上的平均计算时间很短,也不表示采集、通信和保存路径满足 80 ms。
硬件比较应固定输入尺寸、精度模式、批处理方式、驱动、运行时和软件版本。验收至少包括冷机和热机状态、持续运行、温度变化、显存占用、CPU/GPU 利用率、功耗、异常恢复以及驱动升级后的回归测试。最终要比较的是整条链路的平均值、P95/P99、丢帧率和检测质量,而非单个芯片的理论 TOPS。
GPU 方案还要明确数据是否需要在 CPU 和 GPU 之间往返。采集卡把图像写入主机内存后再复制到显存,会形成额外传输;如果预处理、推理和后处理都能在同一设备上连续完成,复制次数可能减少。相反,把一部分算子留在 CPU、另一部分放到 GPU,可能因为同步和内存拷贝抵消计算收益。基准测试应记录每次拷贝、同步和等待,并把计时范围覆盖完整链路。
FPGA 的确定性来自固定数据流和预先编译的逻辑,但改动算法和验证时序通常需要更长开发周期。它适合输入格式、算子和延迟边界相对稳定的设备;若项目频繁更换模型或产品,重新综合、部署和维护的成本要纳入比较。SIMD 和多核 CPU 则可能更容易与已有采集、通信和日志组件整合,减少异构设备之间的交接。硬件选型应把“能否保持稳定的 P99”与“团队能否长期维护”放在同一张评估表中。
持续运行测试要观察热机后是否出现降频,以及其他任务是否抢占资源。单次峰值速度只回答设备在某一瞬间的能力,无法回答连续生产数小时后的服务能力。设备重启、GPU 复位、相机断连和内存不足也应设置故障注入或等效测试,确认系统能报警、丢弃受影响任务并回到可识别状态,避免错误结果被当成正常输出。
流水线、异步与吞吐
流水线并行的做法,是让不同帧同时处于不同阶段。假设采集、预处理、特征计算或推理、判定输出分别需要 \(20\)、\(30\)、\(40\) 和 \(10\) ms。严格串行时,单帧总延迟是
当四个阶段能够在不同帧之间重叠,系统进入稳态后,新的结果到达间隔由最慢阶段近似决定:
若用 \(R_{\mathrm{ideal}}\) 表示理想吞吐率,单位为 results/s 或 frames/s,则
式(86-2)的前提是各阶段可以并发,阶段之间有足够缓冲,锁竞争较小,数据交接不会新增长等待,而且输入速率没有超过最慢阶段的服务能力。若多个阶段必须共用一块加速器,或某个阶段存在很长的耗时尾部,实际周期就会高于 \(40\) ms。更大的缓冲可以吸收短时抖动,却可能增加排队等待并掩盖过载。
流水线还经历启动填充、稳态和停止排空三个阶段。启动时,第一帧必须依次走过采集、预处理、推理和判定,第一条结果仍接近 100 ms;只有各阶段被不同帧填满后,结果间隔才接近 40 ms。停止时,已经进入系统的帧还要排空,最后一帧的完成时间也可能接近串行总延迟。若设备只运行很短的批次,不能用稳态周期替代首帧和尾帧延迟。
阶段重叠需要真正独立的资源。把四个线程写出来,并不等于四个阶段能同时执行:Python 代码可能受 GIL(Global Interpreter Lock,全局解释器锁)影响,多个阶段也可能争用同一张 GPU、同一块内存或同一个互斥锁。若采集线程阻塞在满队列上,采集时间就会被排队时间污染;若输出线程阻塞在网络应答上,推理线程也可能被间接拖慢。架构验证应检查线程、设备和缓冲的资源映射。
理想吞吐率还要求上游能按 40 ms 或更快的间隔稳定交帧。若采集本身只能每 60 ms 产生一帧,推理阶段的 40 ms 只是理论能力,系统结果仍受采集限制。若上游以 30 ms 交帧而推理平均要 40 ms,队列会持续增长,短时间内看似正常,长期则必然出现等待或丢帧。
图 86-1 上方是同一帧依次经过四个阶段的路径,下方是不同帧在四个阶段中重叠运行的示意。读图时要沿着同一帧追踪端到端等待,再横向观察某一时刻不同帧所占用的阶段。前者给出单帧延迟,后者给出稳态吞吐,两条路径描述的量不同。
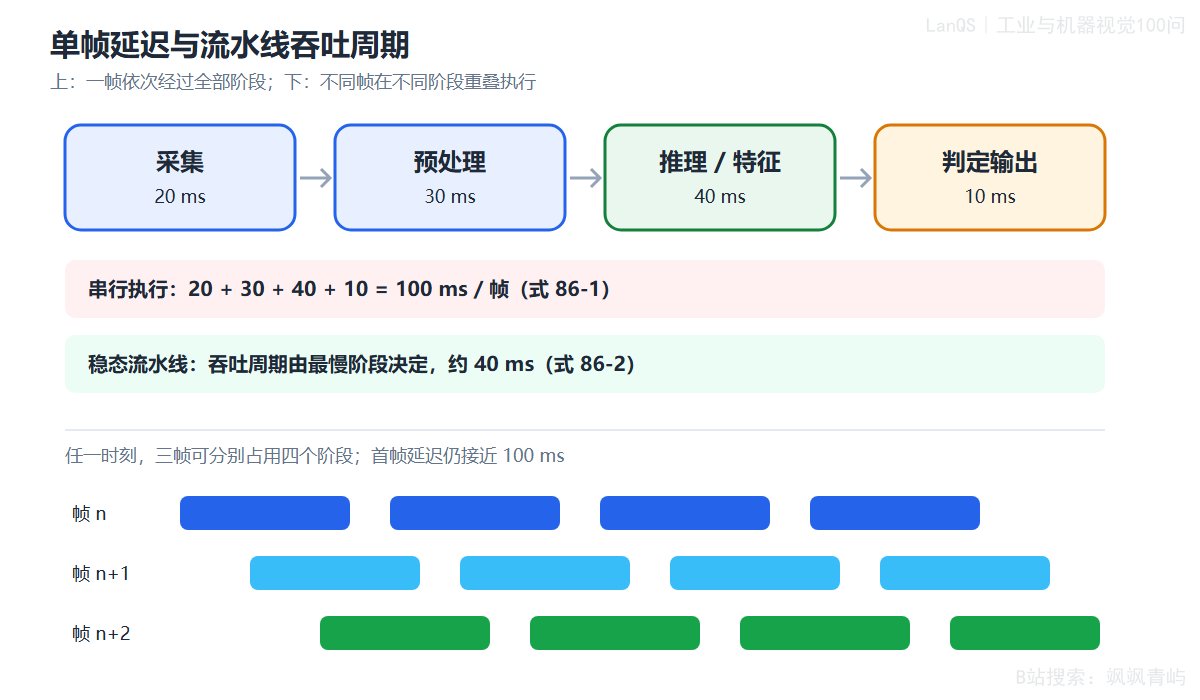
图86-1 单帧延迟与流水线吞吐周期的区别
流水线不改变某一帧走过的阶段数量。它适合“持续跟上工件流动”的业务约束,不适合“这一帧必须在动作发生前完成”的同帧闭环。安全互锁、立即剔除或使用当前测量值修正机器人位置的场景,都要把动作时限和通信延迟包含在单帧预算中。
阶段模型与队列边界算例
先把上述阶段时间代入式(86-1)和式(86-2):
因此,串行方案超过 \(80\) ms 结果周期要求,理想流水线的 \(40\) ms 结果间隔低于该要求,理论上留有 \(40\) ms 的节拍余量。这个计算支持“阶段可以重叠时,系统具备足够理论产能”的判断;它不能证明缓冲、锁、通信和长尾已经满足现场要求。
算例代码把推理阶段抽象成一个 FIFO(First In First Out,先进先出)单服务器。上游以固定的 \(40\) ms 间隔交帧,推理服务时间以 \(40\) ms 为均值,按给定标准差加入每帧抖动。代码使用 max(1.0, service_time) 把过小的服务时间截到 \(1.0\) ms,避免随机样本产生非物理的负值;队列深度为 \(q\),新帧到达时若等待帧数达到 \(q\),就记录一次丢帧。模拟共处理 \(400\) 帧,每组场景使用随机种子 \(42\)。结果间隔由相邻完成时间相减得到,同时报告平均值和 P95。
用于复核的伪代码如下:
for (jitter_sd, queue_depth) in scenarios:
    server_free_at = 0
    for i in range(400):
        arrival = i * 40 ms
        waiting = number of frames already waiting
        if waiting >= queue_depth:
            dropped += 1
            continue
        start = max(arrival, server_free_at)
        service = max(1.0 ms, normal(mean=40 ms, sd=jitter_sd))
        finish = start + service
        server_free_at = finish
        record(finish)
    gaps = adjacent differences between recorded finish times
    average = mean(gaps)
    p95 = 95th percentile(gaps)
代码输出的五组场景如下。这里的“抖动标准差”是模拟参数,不是设备实测值。
| 抖动标准差 \(\sigma\) | 队列深度 \(q\) | 平均结果间隔 | P95 结果间隔 | 丢帧 |
|---|---|---|---|---|
| 0 ms | 8 | 40.0 ms | 40.0 ms | 0/400 |
| 4 ms | 8 | 40.4 ms | 47.3 ms | 0/400 |
| 4 ms | 2 | 40.4 ms | 47.3 ms | 3/400 |
| 12 ms | 8 | 41.2 ms | 61.9 ms | 5/400 |
| 12 ms | 2 | 41.7 ms | 63.4 ms | 16/400 |
最差场景的平均结果间隔仍只有 \(41.7\) ms,低于 \(80\) ms;但 P95 已经达到 \(63.4\) ms,并且 400 帧中丢失 16 帧。平均值低于产线要求,不能掩盖长尾或丢帧。这个模拟说明式(86-2)在有抖动和有限队列时只是理想上限,不能当作实际吞吐保证。抖动、队列深度和结果完整性应同时进入验收。
图 86-2 用深蓝柱表示平均结果间隔,用浅蓝柱表示 P95 结果间隔,绿色线表示理想的 \(40\) ms,红色线表示 \(80\) ms 产线要求。观察时先看 P95 是否接近上限,再看各组下方的丢帧数。队列变浅和抖动增大带来的主要风险,不一定首先表现为平均值超限,也可能先表现为长尾和丢帧。
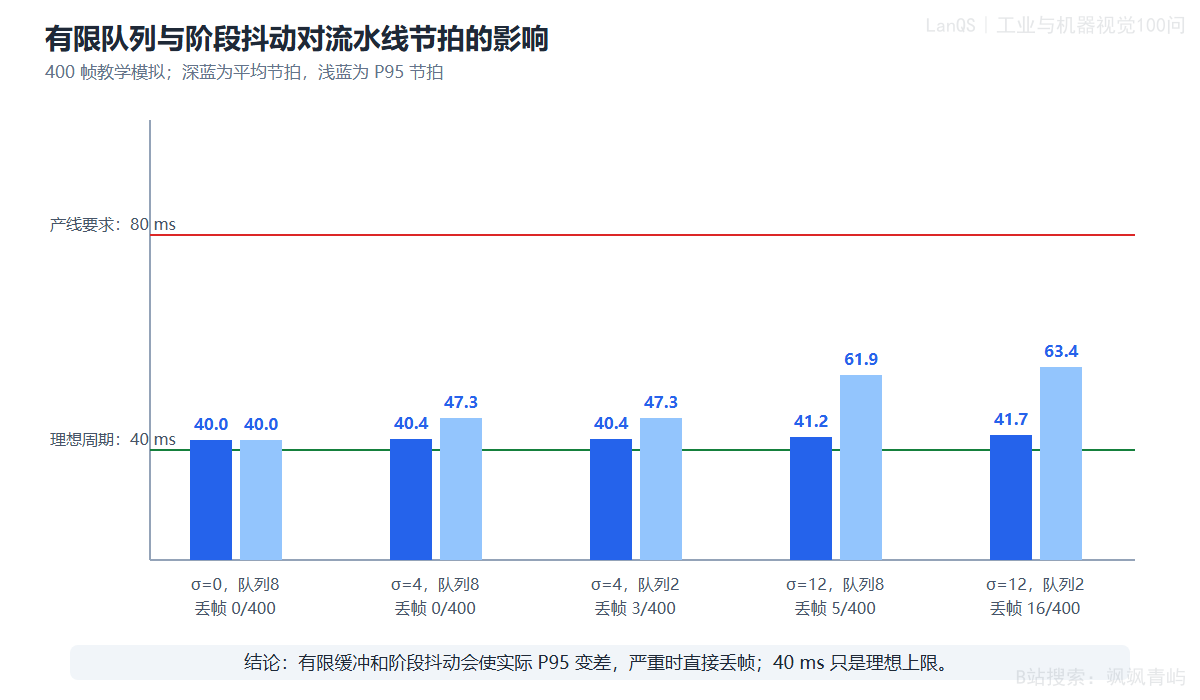
图86-2 有限队列和阶段抖动下的实际节拍与理想预测
队列设计还要明确三件事:队列满时是丢弃新帧、阻塞采集还是转入降级路径;丢帧后如何追踪产品和报警;队列长度增加后可接受的最大等待时间是多少。深队列适合吸收短时抖动,过深则会延迟暴露持续过载;浅队列响应快,却更容易在服务时间连续偏大时丢帧。
队列中的任务还存在年龄问题。一个结果即使最终算对了,如果它对应的工件已经越过剔除位置,结果也可能失去控制价值。因此,验收不能只统计“完成了多少帧”,还要统计从采集到动作的年龄、超时结果比例和结果与工件的关联正确率。对允许迟到的记录型任务,可以保留迟到结果;对控制型任务,超时应进入明确的安全状态,不能把旧结果当作当前状态。
模拟中的丢帧判断是教学化的单服务器模型,真实系统还可能有多路相机、多个消费者和不同优先级。它适合帮助读者理解抖动和队列深度怎样破坏式(86-2)的近似,不足以预测某台设备的实际丢帧率。实际测试应在目标硬件上采集真实 stage time,使用真实触发频率,并记录每一帧从采集到完成或丢弃的完整状态。
异步处理适合把不影响主闭环的工作移到后台。例如,主通道用快速规则给出初判,后台线程再对疑似样本运行高精度分析并保存图像。关键在于结果必须能回到正确的工件上。帧号、工件号、触发序号或编码器位置应随任务传递,后台结果还要有超时和迟到处理规则。
如果生产流程允许先放行再复核,异步精检可以减少主路径等待;如果剔除器必须根据当前帧在固定位置动作,迟到结果只能用于记录或人工复核,不能假定它仍能驱动同一件工件。异步线程也可能与主线程争用 CPU、内存或 GPU,因此优化后要重新测量完整链路。
缓存适合相邻帧变化小、姿态稳定、背景相同且结果可以逐件关联的场景。系统可以计算当前帧与参考帧或上一帧的相似度,在满足预先验证的条件时复用部分中间结果。相似度高只说明图像外观接近,不能证明缺陷位置、产品编号和当前帧完全相同。工件运动快、缺陷位置随机、产品换型频繁或每件都必须独立追溯时,应保留独立计算。
缓存策略应记录命中率、误用率、节省的计算时间和被复核的样本。每次换型、相机参数变化或环境明显变化后,都要重新验证相似度阈值;缓存命中不能绕过质量监控。
异步和缓存都要求结果拥有清楚的有效期。异步任务进入后台时,应保存采集时间、帧号、工件号、相机参数和队列位置;结果完成后检查该工件是否仍在允许的动作窗口内。若任务超时,系统应区分“未完成”“完成但过期”和“完成且可用”,三者的报警与追溯含义不同。高精度后台结果也不能覆盖已经执行的错误动作,除非现场流程明确允许延后修正。
缓存还可能把系统的变化隐藏起来。连续帧相似时,算法可能连续复用旧结果,导致新出现的缺陷没有经过完整计算。可将缓存命中样本按固定比例抽样回算,比较复用结果和独立结果;当两者差异超过阈值,立即降低命中率或停用缓存。换型、焦点调整、曝光或增益修改、光源维护之后,应使旧缓存失效。
“每 80 ms 得到一个结果”可能是视觉站的处理窗口,也可能只是工件以 80 ms 间隔到达的运输节奏。还需要确认每一件是否都必须完成完整分析,是否允许快速筛查后把疑似件送到复检位,是否必须在当前帧上驱动剔除器,是否必须保存全部原图。
有缓冲位、并行工位或复检工位时,视觉的内部处理周期可以与工件运动周期错开,但工件、结果和动作必须可追溯关联。若结果直接决定同一工件的即时动作,就要把采集、传输、计算、输出和异常处理分配到同一帧的时间预算中。图片存储可以只保留 NG(Not Good,不合格)或低置信度样本,但这一选择必须满足审计和问题复盘要求。
面对 100 ms 与 80 ms 的冲突,可以按以下顺序形成决策。先确认是否是同帧闭环;是,则流水线只改善吞吐,优先检查阶段计时、算法和硬件,必要时重新讨论动作窗口。若是持续吞吐要求,再确认阶段之间是否能安全重叠、缓冲是否足够、P95/P99 是否有余量。流水线难以实施时,再以最小缺陷尺寸和最低对比度为约束评估轻量模型、ROI、硬件加速或量化。若这些措施都会损害验收质量,才需要和产线一起讨论节拍定义、缓冲位置或复检流程。
需求澄清还要把“结果产生时间”和“动作执行时间”分开。即使视觉结果在 80 ms 内生成,网络发送、PLC 扫描、输出模块响应和剔除器机械动作仍需时间;若动作位置距离相机较远,系统还要根据输送速度和编码器位置计算允许的结果年龄。反过来,如果产线可以在视觉站后设置缓冲,视觉系统可以先完成判定再在工件到达动作位前输出。两种布置不能用同一个 80 ms 数字直接替代。
对于每件产品都必须追溯的项目,丢帧和迟到结果应有明确的业务状态,例如待复核、禁止放行或缺测。若业务只要求对疑似件做高精度复检,则可以把快速筛查结果和复检结果分成两级,并在数据库中保留两者。重新定义节拍不是放宽质量要求,而是把实际工艺中的缓冲、复检和动作位置写进需求,使技术团队知道到底要满足哪条时间边界。
验收、监控与降级
长期性能监控至少应记录采集时间、传输时间、预处理时间、推理时间、后处理时间、通信等待、队列深度、丢帧率、CPU/GPU 利用率、内存占用、温度和模型或规则版本。监控指标应按产品批次和工位分组,分别观察平均值、P95、P99 和峰值。这样才能区分算法变慢、温度降频、网络阻塞、磁盘写入和 PLC 等待。
在轻度过载时,可以执行预先验证过的降级策略,例如关闭辅助可视化、降低非关键图片保存频率、切换轻量模型,或只对疑似区域运行精检。每个策略都要写明触发条件、检测质量上限、最大持续时间、恢复条件和回退动作。降低保存频率不能影响必须保留的 NG 证据,切换轻量模型也不能绕过缺陷样本复验。
现场不能在生产压力下临时修改这些参数。降级后应继续记录召回率、误报率、结果延迟、丢帧率和追溯完整性;任何一项超出上限,都应转入人工复核或停线处理。动态调整的意义是让系统在已知边界内平稳运行,不能把质量责任隐藏在“自动优化”之后。
性能监控最好同时设置预警线和禁止自动放行的控制线。比如队列深度连续上升说明负载可能超过服务能力,P99 接近动作窗口说明偶发长尾已没有余量,丢帧率大于零则要检查是否每个受影响工件都能被定位。具体阈值必须由验收要求给出;监控本身不应因为平均值正常就忽略尾延迟。
动态调整还要防止频繁切换。若系统在轻量模型和完整模型之间来回切换,结果可能难以复盘,模型热切换也可能造成短暂阻塞。可以设置滞回区间、最小保持时间和人工确认条件,并为每次切换记录原因、起止时间、模型版本和受影响工件。降级状态在生产界面上应清楚可见,不能只藏在日志里。
一套综合方案可以在采集阶段按工件位置裁剪 ROI,在独立线程中重叠预处理和推理,在 GPU 上运行适合并行的模型,把结果通信和缺陷图保存放到不同的下游任务,再把明显正常样本留在快速通道,把 NG 或低置信度样本交给精检通道。每个阶段都应有输入、输出、超时、错误码和帧号,防止并行后出现结果错配。
验收应同时覆盖单帧延迟、稳态结果间隔、P95/P99、丢帧率、召回率、误报率、产品与结果关联正确率,以及异常恢复时间。对流水线系统,还要分别测量启动填充时间、稳态和停止排空时间;连续吞吐达标不代表第一帧或最后一帧的等待也达标。
一份可复核的验收记录应把测试条件写完整:相机分辨率和触发频率、产品速度、样本构成、模型或规则版本、CPU/GPU 型号、驱动与运行时、是否保存原图、网络和 PLC 状态、测试时长以及热机温度。结果表中同时列出合格样本、缺陷样本、低置信度样本、丢帧样本和超时样本,避免只报告平均速度。若使用模拟抖动或构造缺陷,必须与真实产线验证结果分栏。
系统上线后还要保留回退路径。轻量模型、完整模型、缓存策略和降级配置都应有可识别版本;发生漏检、丢帧或延迟异常时,可以快速切回已验证版本并保留异常图像。性能优化的验收不应止于“达到 80 ms”,还要证明在温度变化、通信异常、磁盘满、相机重连和模型切换后,系统会进入预期状态并留下可追溯记录。
性能优化最终是系统工程问题。阶段结构决定哪里能重叠,资源分配决定是否出现新瓶颈,业务约束决定应该优化单帧延迟还是结果吞吐,检测边界决定哪些加速手段可以使用。只有把这些量放在同一份测试记录中,100 ms 到 80 ms 的差距才会转化为可执行的工程决策。
常见误区
- 没有阶段埋点就把超时全部归咎于模型。图像上传、磁盘写入和 PLC 握手都可能是瓶颈。
- 用流水线解决同帧安全、剔除或机器人闭环。流水线提高结果供给速度,却不缩短当前帧的端到端路径。
- 降低分辨率或模型规模前没有复核最小缺陷尺寸、对比度和困难样本召回率。
- 用 \(\max_i(t_i)\) 的理想值代替带队列、抖动和通信的实际验收。
- 只报告平均延迟或 FPS,不报告 P95/P99、丢帧和热机状态。
- 用相似度缓存替代逐件追溯,导致结果被错误复用。
- 现场临时启用降级策略,却没有验证检测质量和恢复条件。
术语与符号表
| 术语或符号 | 含义 | 单位 |
|---|---|---|
| 单帧延迟 | 一帧从采集到结果完成的端到端耗时 | ms |
| 吞吐周期 \(T_{\mathrm{cycle}}\) | 稳态相邻结果到达的时间间隔 | ms/result |
| 吞吐率 \(R\) | 单位时间内完成的结果数量 | results/s 或 frames/s |
| \(t_i\) | 第 \(i\) 个处理阶段的耗时 | ms |
| 流水线并行 | 让不同帧同时占用不同阶段的架构 | 无量纲概念 |
| FIFO | First In First Out,先进先出队列规则 | 无 |
| 抖动 | 单帧阶段耗时相对名义值的变化 | ms |
| P95/P99 | 延迟样本中 95%/99% 不超过的分位值 | ms |
| 丢帧 | 未完成处理或因队列满而被丢弃的图像帧 | frame |
| ROI | Region of Interest,感兴趣区域 | 像素区域 |
| FPS | Frames Per Second,每秒帧数 | frame/s |
| \(T_{\mathrm{serial}}\) | 串行执行时单帧总延迟 | ms |
| \(q\) | 队列可容纳的等待任务数量 | frame |
延伸阅读
- Lee, E. A.,《The Problem with Threads》,用于理解并发、缓冲和流水线的时序问题。
- NVIDIA,《CUDA C++ Programming Guide》,用于复核 CUDA 事件、流和设备侧计时。
- Little, J. D. C.,《A Proof for the Queuing Formula: L = λW》,用于理解到达率、等待时间和队列长度的关系。
- Hopp, W. J. 与 Spearman, M. L.,《Factory Physics》,用于理解产线节拍、缓冲和工位平衡。
第87问 相机或镜头的性能会随时间退化,系统怎样检测并提前预警?
视觉系统的成像状态会随着运行时间变化。镜头表面逐渐积灰,保护玻璃沾上油膜,光源的亮度和色温发生漂移,传感器在高温下的噪声升高,支架受到振动后产生微小位移,这些变化通常不会立刻让程序报错。相机仍然触发、图像仍然保存,检测程序也仍然输出结果,但缺陷边界、局部对比度和纹理稳定性可能已经偏离了调试时的状态。
本问讨论怎样把成像质量变成可追踪的设备状态。内容包括退化原因、镜头污染的图像证据、光源衰减的直接和间接测量、基线与参考样本、预警系统的闭环、趋势模拟、机器学习辅助诊断和维护验证。一个可用的预警系统必须同时回答“图像发生了什么变化”“变化可能由什么引起”“什么时候安排什么动作”。
退化证据与质量监控
图像质量由缺陷与背景的亮度差、边缘清晰度、视场均匀性、噪声水平和缺陷可分离程度决定。它包括缺陷与背景的亮度差、边缘清晰度、视场均匀性、噪声水平和缺陷可分离程度。只要这些量仍然勉强落在算法可接受范围内,设备就会继续产生表面上正常的判定;随着余量逐渐消失,误报和漏检才会在统计上明显增加。
镜头或保护玻璃上的灰尘、油膜和凝露会改变光线的透过与散射。散射光进入传感器后,局部对比度下降,亮部周围可能出现光晕,细小边缘会变软。LED 光源的工作时间、温度和驱动状态会改变发光强度和色温,导致整幅图或某些通道的亮度分布移动。传感器温度升高时,读出噪声和热像素可能增加;长期运行还可能出现越来越多的固定异常像素。安装结构松动则会改变焦点、视场姿态和照明入射角,反光形状或阴影位置随之变化。
这些原因在单张图上可能难以察觉,却会留下不同的时间和空间特征。光源衰减常表现为参考区域整体变暗,污染更容易形成固定位置的局部斑块或光晕,失焦会让整个视场的边缘响应下降,振动则可能产生与运动方向相关的拖影。把图像质量作为趋势来观察,能够在检测能力明显下降前发现余量正在被消耗。
排查时应区分三层状态:触发和传输是否正常,成像指标是否稳定,缺陷检测结果是否仍满足验收。第一层只能证明设备在线,第二层才反映成像条件,第三层还需要真实带标签样本验证。维护计划若只在程序完全无图或相机断线时触发,就会错过大量渐进退化。
退化还可能表现为检测结果分布的缓慢改变。光源变暗时,原本接近阈值的缺陷灰度会向正常背景靠近;局部散射增加时,细小边缘的梯度下降,分割区域面积可能变小;噪声上升时,正常区域的灰度波动变大,固定阈值会产生更多孤立误检。安装偏移则可能使缺陷在 ROI 中的位置改变,导致算法不再使用原来的几何关系。把图像质量指标和检测输出同时记录,可以看出质量余量消失与误报、漏检之间的时间关系。
维护人员还要检查退化是否具有累积性。灰尘、油膜和光源老化通常会在多次复拍中沿同一方向变化,短时温度或样本定位误差则可能上下波动。连续趋势、空间差分和维护历史结合后,才能区分“部件真的在变差”和“这次测量碰巧不同”。
镜头污染最直接的光学后果是散射增强、局部对比度下降和模糊增加。少量灰尘可能先表现为背景雾化和边缘锐度降低;较重的残留会在相机坐标的固定位置形成暗斑,或者在高光附近形成不均匀亮斑。若污染位于保护玻璃或镜头前组,异常位置通常随镜头固定,而不会跟着工件上的纹理移动。
工程人员可以将当前参考图与调试时的已知良好图像对齐,查看变化是否固定在相机坐标中,再计算参考区域的局部对比度、高频能量或边缘斜率。局部对比度描述目标区域与邻近背景的亮度差异,适合判断微小缺陷还能否从背景中分离;拉普拉斯方差或高频能量可以反映边缘和纹理变化,但噪声也会抬高高频响应,不能单独拿来诊断污染。
污染、失焦和振动都可能让锐度指标下降。若全视场边缘都变软,重新对焦或检查工作距离后指标恢复,失焦更可疑;若异常集中在固定位置,清洁前后图像差异明显,污染的可能性更大;若边缘出现方向一致的拖影,并且随设备运动或支架受力改变,应检查振动和安装刚度。重复采集、改变工件位置并观察异常是否随工件移动,是区分这几类原因的有效办法。
现场不要只保留一个“清晰度分数”。应同时保存参考图、当前图、差分图和参考区域位置,并记录曝光、增益、工作距离、触发时序、镜头焦点和环境温度。这样维护人员可以判断清洁、调焦、紧固支架或检查光源驱动,而不必从一个聚合分数猜原因。
比较图像前必须解决配准问题。样本没有固定治具时,工件的平移或轻微旋转会让差分图出现大面积假变化;可以使用定位标记、几何配准或固定参考区域,把位置误差与光学变化分开。对于周期性纹理,比较时还要避免把正常纹理相位差当成局部污染。参考图的空间坐标、裁剪窗口和配准参数都应版本化保存。
若污染只影响部分视场,整幅图平均亮度可能几乎不变,局部统计量更敏感。可以把视场划分为若干稳定区域,分别记录均值、百分位、边缘响应和噪声,再观察异常是否只集中在一个区域。分区监控增加了诊断能力,同时也增加了参考样本定位和阈值管理工作,区域数量应由缺陷位置和光学结构决定。
光源状态可以直接测,也可以通过最终成像结果间接推断。照度计测量工件位置的照度,光功率计测量光学输出,光源内置传感器则提供驱动或输出反馈。这些测量适合观察光源本体。它们无法覆盖镜头污染、保护玻璃散射、相机增益或工件反射率改变之后的影响,所以不能代替整条成像链的验证。
间接方法是在固定条件下对同一个黄金样本或参考卡重复成像。黄金样本是已知状态稳定、可被重复定位的物理样本;参考卡则可以提供较稳定的亮度或纹理区域。采集时应保持曝光、增益、工作距离、触发条件和照明设置不变。将当前等效亮度 \(\Phi(t)\) 与初始亮度 \(\Phi(0)\) 相比,可以定义光源衰减因子:
这里的 \(\Phi(0)\) 是调试或基线时的光通量,单位可以是流明;也可以用固定参考区域的平均灰度或其他经过验证的等效亮度替代。\(\Phi(t)\) 是时间 \(t\) 的当前值,单位与 \(\Phi(0)\) 相同,因此 LDF(Light Decay Factor,光衰减因子)是无量纲量。LDF 越接近 \(1\),当前输出越接近基线;LDF 下降表示相对初始状态变暗。
例如,若固定参考区域的基线平均灰度为 \(200\),当前为 \(188\),把灰度作为等效亮度,则
表示当前参考亮度约为基线的 \(94\%\),相对下降 \(6\%\)。这个计算支持“当前成像亮度相对基线发生了变化”的判断,不能单独证明原因一定是光源老化。曝光设置、相机增益、参考样本反射率、镜头污染和环境光都可能使 \(\Phi(t)\) 下降。
把公式落到现场,需要建立固定周期的黄金样本复拍协议。每班、每周或更短的周期应根据已知退化速度和停线代价选择;变化快的工位需要更密集采样。每次复拍都记录时间戳、操作者、设备编号、工位、样本编号和环境条件,并计算与生产图像相同的参考亮度、清晰度和局部对比度指标。黄金样本要防尘、防油和防误换,并定期与备用样本交叉核对,否则样本自身的磨损会被误当作设备退化。
基线应来自完成校准、安装稳定、处于已知良好状态的设备。基线若是在设备已经“勉强可用”时采集,后面的预警都会围绕错误的起点建立。复拍协议还要记录相机参数和定位方式,保证时间序列中的变化主要来自设备,避免每次样本摆放差异混入结果。
基线不应只有单个均值。对同一健康状态重复采集,可以估计正常波动范围,记录均值、标准差、分位数和不同温度或班次下的变化。预警边界应位于正常波动之外,同时给维护留下足够时间;如果正常噪声本身已接近允许的质量余量,应先改善夹具、遮光和采集重复性,再讨论报警阈值。
直接测量与参考样本成像最好相互校验。照度计发现光源输出下降而参考图没有变化,可能是测量位置不同或相机曝光补偿掩盖了变化;参考图下降而光源输出正常,则应检查镜头、保护玻璃、相机增益和样本表面。两种信号指向不同阶段时,系统获得的诊断信息比单独看任一量更完整。
亮度是必要指标,却不足以描述成像质量。质量指标应从缺陷的成像机制出发:缺陷靠灰度差被发现,就监控亮度和局部对比度;缺陷靠边缘或细线被发现,就监控边缘斜率、拉普拉斯响应或 MTF;缺陷容易被噪声淹没,就监控噪声和信噪比;不同区域必须均匀时,再监控视场均匀性。
MTF(Modulation Transfer Function,调制传递函数)描述不同空间频率的对比度经过光学和传感器后保留多少,适合用标准靶、稳定边缘或条纹检查清晰度。SNR(Signal-to-Noise Ratio,信噪比)表示有效信号相对于噪声波动的大小,在相同缺陷信号下,SNR 下降意味着缺陷更容易被随机噪声掩盖。颜色一致性则适合彩色检测或依赖色温的任务,单色灰度缺陷不一定需要彩色指标。
| 指标 | 观察对象 | 可能发现的变化 | 使用边界 |
|---|---|---|---|
| 参考区域亮度 | 平均灰度或百分位灰度 | 光源衰减、曝光或增益变化 | 受反射率和环境光影响 |
| 亮度均匀性 | 不同位置的亮度差异 | 光源角度、渐晕、局部污染 | 参考区域和定位必须固定 |
| 边缘斜率、拉普拉斯响应 | 边缘和高频纹理 | 失焦、污染、运动模糊 | 噪声会抬高高频指标 |
| MTF | 空间频率上的对比度传递 | 光学清晰度下降 | 需要稳定靶标或边缘 |
| 噪声和 SNR | 有效信号与随机波动 | 温升、传感器和供电异常 | 曝光、增益和区域须固定 |
| 颜色一致性 | 通道比例、色温 | 光源色温漂移、通道异常 | 只对颜色敏感任务必要 |
| 缺陷可分离度 | 缺陷与背景的统计距离 | 检测余量被压缩 | 需要真实带标签样本 |
基线要保存原始图像、参数和采集条件,而不只是保存每项指标的平均数。对同一指标应保留当前值、基线值、偏差、连续越线次数和趋势斜率。缺陷可分离度应在已知缺陷和正常样本上周期性复测,因为一张黄金样本只能说明成像参考稳定,不能证明真实缺陷仍然可检出。
预警闭环与预测性维护
退化监控系统可以分成六个互相衔接的模块。基线采集记录健康状态;在线监控按固定周期获取参考图;指标计算把图像变成亮度、清晰度、噪声和均匀性数据;趋势分析区分慢性下降、突然跳变和短时波动;阈值判断把状态分为正常、预警和停止或强制复验;维护反馈记录清洁、换光源、调焦、紧固或重新标定后的恢复结果。
图 87-1 展示从基线到维护反馈的闭环。读图时先沿上方流程看一项指标如何被采集、计算、分析并转成动作,再看下方趋势曲线如何依次穿过预警线和停止线。维护动作之后,系统应重新采集参考样本并验证基线是否恢复;流程若在报警处结束,就只能知道“发生了变化”,无法知道哪种维护是否有效。
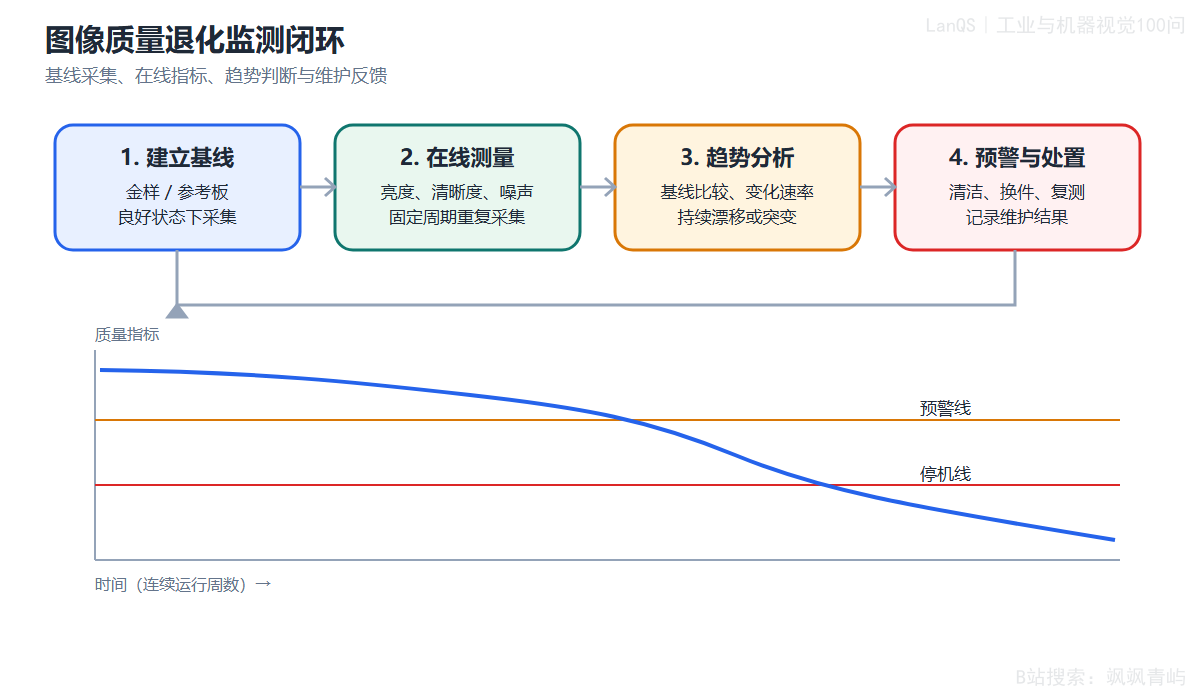
图87-1 从参考采集到维护反馈的图像质量退化监控闭环
阈值是双向设计。阈值过紧会把复拍噪声、样本摆放差异或环境变化当成故障,频繁报警会使操作者逐渐忽略通知;阈值过松又会等到检测能力已经下降才发出警报。预警阈值应结合正常状态波动、缺陷漏检代价和维护提前期设置,停止阈值应结合缺陷验收和安全要求设置。
环境条件会伪造退化信号。机柜温度变化会影响传感器噪声,外部光线漏入会改变亮度,黄金样本位置略有偏移也会改变局部指标。每次复拍都应记录机柜温度、班次、时间、样本定位和换型信息;对单次越线先复采,要求连续多次同向变化或多个指标共同变化后再升级维护。
预警和停止的判定还应包含滞回。指标在阈值附近来回波动时,若每次采样都改变状态,现场会收到连续的报警和清除通知。可以规定连续若干次越线才进入预警,恢复到更宽松的恢复边界并持续若干次后才清除;具体次数和边界应由正常噪声与维护响应时间测试得到。这里的滞回只稳定状态机,不会修复图像质量。
黄金样本趋势预警算例
下面用代码中的构造数据说明预警阈值、停止阈值和采样周期的关系。脚本设置 WEEKS=28,质量指标在第 0 周以归一化值 \(1.0\) 为基线。每周退化率为
并在真实退化值上叠加标准差 \(\sigma=0.008\) 的高斯测量噪声。这里的指标是归一化清晰度代理量,数值越低表示图像状态越差。它来自模拟,不能理解为某台相机的实测寿命。预警阈值是 \(0.85\),表示相对基线下降到约 \(85\%\);停止阈值是 \(0.70\),表示下降到约 \(70\%\)。
代码先按周生成真实退化值,再用 random.seed(11) 生成观测值。阈值事件取观测序列第一次越线的周次,平滑后的理论曲线只用于解释趋势。结果中,第 15 周观测值首次低于 \(0.85\),第 24 周首次低于 \(0.70\),因此名义提前量为
这个 \(9\) 周表示在本次退化速率、噪声和每周复拍条件下,预警到停止之间可以安排维护的时间窗口。它不能证明设备在这九周内都能安全生产,因为停止阈值没有替代带标签缺陷样本的检验,真实退化也可能突然加速。
代码还分别以每 \(1\) 周、每 \(2\) 周和每 \(4\) 周抽取观测点。每周采样得到预警第 15 周、停止第 24 周,提前量为 \(9\) 周;每两周采样时,预警被观察到第 18 周、停止第 24 周,提前量为 \(6\) 周;每四周采样时,预警在第 16 周被观察到、停止在第 24 周被观察到,提前量为 \(8\) 周。采样点变粗后,真实越线可能发生在两次复拍之间,预警检测会延迟或提前量估计会改变。
要读懂这段模拟,还要区分 true_value 和 observed_value。true_value 按前一周值乘以 \((1-\mathrm{decay\_rate})\) 递推,描述不含测量噪声的底层退化;observed_value 在该值上叠加标准差为 \(0.008\) 的高斯噪声,代表每次复拍的曝光和定位微小差异。阈值判断使用 observed_value,所以第 15 周的越线可能与测量噪声共同有关。真实系统应使用实测重复性估计噪声,而不能直接把 \(0.008\) 复制到其他工位。
采样周期的选择还要考虑操作窗口。每周采样可能需要停机或取出参考样本,每四周采样则减少人工成本,却可能把退化事件留到更晚才被看见。若系统能自动在生产间隙拍摄参考区域,采样周期可以更密;若只能在换班时人工复拍,就应把一次复拍的失败重试和漏采记录纳入提前量计算。
下面的伪代码保留了算例逻辑:
BASELINE = 1.0
WARN_THRESHOLD = 0.85
STOP_THRESHOLD = 0.70
for week in range(28):
    decay_rate = 0.004 + 0.0009 * week
    true_value = previous_value * (1 - decay_rate)
    observed_value = true_value + gaussian_noise(std=0.008)
    record(week, true_value, observed_value)
warn_week = first sampled week with observed_value < 0.85
stop_week = first sampled week with observed_value < 0.70
lead_time = stop_week - warn_week
图 87-2 把观测曲线、底层平滑退化曲线、两个阈值和两次越线周次放在一起。阅读时先找到观测曲线第一次穿过预警线的位置,再找到第一次穿过停止线的位置,最后读取两者的横坐标差。观测噪声可能让单个点暂时越线,所以生产规则应配合连续越线、滑动统计或复采确认。
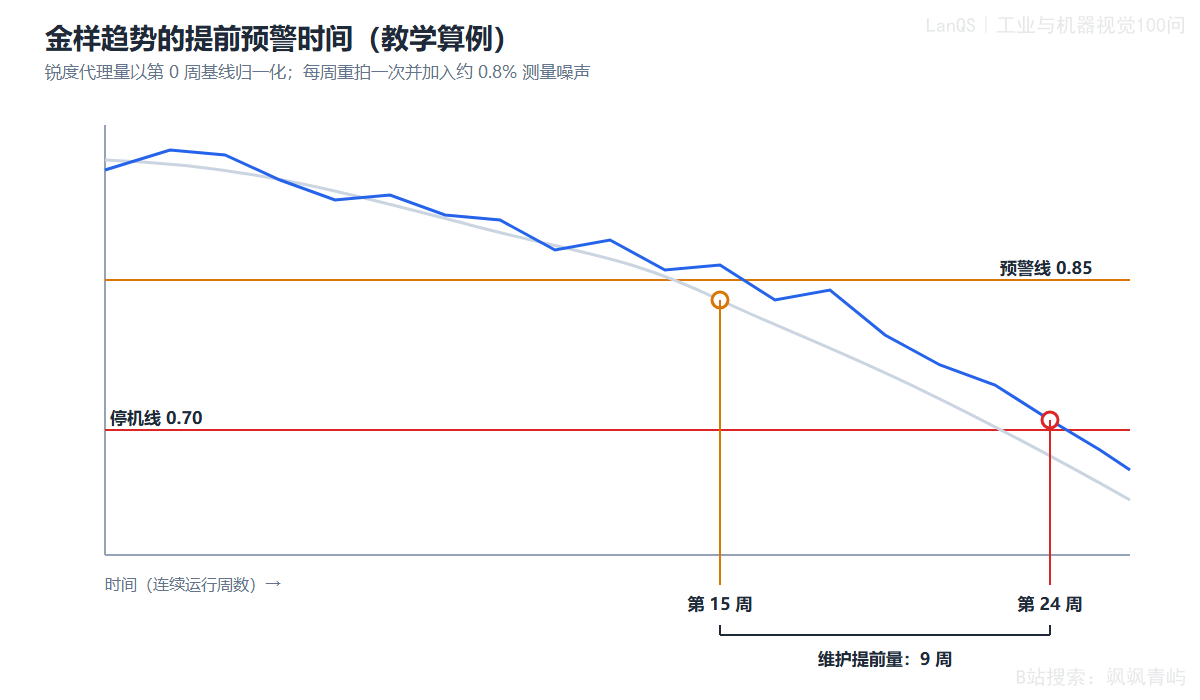
图87-2 质量退化趋势、预警阈值与停止阈值
当亮度、清晰度、噪声和均匀性之间存在复杂关联时,机器学习可以学习正常状态的多指标分布,并给出异常分数。无监督异常检测主要用正常样本建立“正常范围”,适合缺少污染、老化和失焦标签的工位;监督学习需要已经确认的故障类别和足够历史数据,可以进一步区分镜头污染、光源衰减、传感器噪声或安装偏移。
模型输出用于筛查,不能直接给出物理原因。若输入指标与真实故障没有关系,复杂模型也只能更快地放大错误。系统应保存异常图像、输入指标、采集条件、模型版本和人工确认原因,把清洁、换件、调焦和环境干扰的结果写回维护记录。采集条件或产品换型后,正常分布可能发生变化,模型需要重新验证。
第一阶段部署时,亮度、边缘和噪声规则通常更容易解释。规则基线确认问题存在后,机器学习可用于多指标排序和故障分类;这样维护人员仍能回到原始图像和物理检查,不会只面对一个无法解释的异常分数。
无监督模型也要定义训练窗口和更新条件。把已经退化的图像自动当作正常样本继续更新,会逐渐抬高模型对坏状态的容忍度;把换型后的正常图像直接与旧产品混合,也会把产品差异记成设备异常。更新前应由人工确认样本状态,并保留旧模型、训练数据和阈值,确保异常增多时可以回退。
监督模型应区分故障类别,不能把所有状态都标成“故障”。污染、光源输出下降、传感器噪声、失焦、振动和环境光各有不同的处理动作;标签若混在一起,分类准确率即使不低,也不能指导维护。故障标签的可靠性来自清洁、换件、调焦或环境复测之后的因果证据。模型对图像的解释只能提供线索。
当前指标是否越过阈值,只回答设备此刻是否需要处理。预测性维护还要看下降速度、波动形状和维护后的恢复。相同的质量分数,如果一个工位连续三周下降,另一个工位只因一次环境变化短暂下降,维护优先级应不同。时间序列至少要保存当前值、相对基线的偏差、窗口斜率、连续越线次数和最近一次维护时间。
收到漂移报警后,可以按空间模式、噪声底、物理清洁或换件测试和环境记录逐步缩小范围。先查看参考图的异常位置:固定的暗斑、斑块或光晕更支持污染,全视场均匀变暗更支持光源输出变化。再检查平坦区域噪声;噪声升高而平均亮度基本稳定时,应检查传感器温度、供电和读出状态。若清洁镜头后指标迅速接近基线,污染得到支持;清洁无效时再测光源输出,并检查曝光和增益。最后对照环境记录,确认异常是否与温度、班次或外部光线事件同步。
诊断顺序的重点是保留每一步的排除结果。若改变黄金样本位置后异常仍固定在相机坐标,污染或传感器表面问题的可能性上升;若异常跟随样本位置移动,先检查样本和定位;若直接光学测量与参考图像都下降,光源和驱动应优先检查;若参考图下降但光源测量稳定,镜头、相机参数和样本反射更值得关注。工程记录应写明“检查了什么、观察到什么、采取了什么动作”,不能只保存最后的故障类别。
预测性维护还可以使用斜率估计,但斜率必须带上采样间隔和置信范围。两次观测之间的下降量很大,可能是一次样本放置偏差;连续多次同向下降才有更强的维护意义。对于突然跳变,应先检查触发、参数和环境;对于缓慢下降,才适合根据历史斜率估计何时接近停止阈值。估计的时间用于安排检修,不应替代停止状态的安全规则。
维护动作完成后,必须重新拍摄黄金样本,比较维护前后指标,并用带标签的真实缺陷复验。报警消失只表示某个指标回到阈值内,不能单独证明检测能力已经恢复。维护工单应保存设备编号、工位、异常图像、指标快照、时间、处理动作和复验结果,便于计算哪一种指标提前多久暴露了哪一种退化。
每个工位应定义固定的黄金样本或参考目标、定位方式、采集参数、复拍周期和允许变化范围。黄金样本要像量具一样被管理,防止表面磨损、沾污、老化或误换。对于不能长期保存的工件,应使用稳定参考区域、标准靶或经过验证的替代件,并定期与真实缺陷样本交叉确认。
指标数据应关联班次、产品型号、设备编号、环境条件和维护工单。不同产品的正常反射分布不能直接混成一条基线;换型时应明确哪些指标可跨型号比较,哪些只能在型号内比较。复拍周期要由退化速度、人工检查能力和停线风险共同决定,不能只依据软件定时器。
闭环验收可以检查三件事:重复复拍能否稳定发现同一趋势,维护后指标是否按预期恢复,恢复后的缺陷样本是否重新满足检出要求。三项证据都成立,监控指标才从图表变成了可执行的设备维护依据。
工位交接时还应让操作员能看到参考图、当前指标、阈值状态和上次维护记录。预警信息要指出需要复拍、清洁、测光还是安排复验,停止信息要阻止按原条件自动放行。监控界面可以简化显示,但后台应保留原始数值和图像,方便工程人员在误报或漏检后复盘。
部署一段时间后,应统计预警提前量、误报次数、维护后恢复比例和由质量退化导致的缺陷漏检。若预警频繁却很少发现真实退化,说明阈值、样本协议或环境补偿需要调整;若真实缺陷已经下降而监控没有提前反应,说明当前指标没有覆盖主要失效机制。这个复盘结果应回到指标选择和采样周期;单独修改报警颜色不能解决指标失效。
常见误区
- 相机仍能触发和保存图像,就认为成像质量没有变化。
- 只监控光源输出,不检查镜头、相机增益、焦点和安装状态。
- 用一次锐度分数直接断定镜头污染,忽略失焦、振动和噪声的相似表现。
- 用未校准或已退化的设备建立基线,导致后续阈值围绕错误起点工作。
- 只设正常和故障两个状态,没有为计划维护留下预警窗口。
- 单次越线就立即停线,或把环境变化和样本摆放误差当成硬件退化。
- 复拍周期变粗,却没有估算预警提前量会减少多少。
- 把机器学习异常分数直接当作污染、老化或失焦的物理诊断。
- 清洁后报警消失就结束验收,没有用参考图和缺陷样本复核恢复效果。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| 图像质量 | 与检测任务有关的亮度、对比度、清晰度、噪声和缺陷可分离程度 |
| 基线 | 设备在已知良好、参数固定状态下记录的参考图像和指标 |
| 黄金样本 | 用于重复成像和质量趋势比较的稳定参考样本 |
| LDF | Light Decay Factor,光衰减因子,表示当前光通量或等效参考亮度与初始值的比值 |
| \(\Phi(0)\)、\(\Phi(t)\) | 基线时刻和时间 \(t\) 的光通量或等效参考亮度 |
| MTF | Modulation Transfer Function,调制传递函数,描述不同空间频率的对比度传递 |
| SNR | Signal-to-Noise Ratio,信噪比,描述有效信号相对于噪声的大小 |
| 预警阈值 | 用于安排复采、检查和计划维护的质量边界 |
| 停止阈值 | 触发停机、强制复验或禁止按原条件放行的质量边界 |
| 提前量 | 预警阈值首次越线到停止阈值首次越线之间的时间 |
延伸阅读
可继续学习 ISO 12233 中关于分辨率和空间频率响应的测量方法,EMVA 1288 中关于图像传感器和相机噪声表征的方法,统计过程控制中的控制图与趋势分析,以及预测性维护中的时间序列和维护工单闭环。阅读这些内容时,应把指标定义与固定参考样本、采集条件、真实缺陷验证和维护后的复验联系起来。
第88问 什么是数据增强?除普通旋转和缩放外,工业视觉还有哪些针对性方法?
产线上的缺陷样本通常比正常样本少得多,而且相机、输送机构和光源把工件的姿态与成像条件限制在一个相对窄的范围内。训练数据不足时,模型可能只记住少数缺陷的背景、反光位置或边缘融合痕迹;换一个批次、班次或表面状态,性能就会下降。数据增强可以在原始图像上施加受控变化,让模型在训练阶段遇到一部分部署时可能出现的变化。本题讨论的范围包括少数类扩展、光照和表面变化、缺陷形态与纹理、域适应、物理仿真,以及如何验证增强确实增加了有效覆盖。
核心判断: 数据增强的价值在于让训练分布覆盖产线中真实存在、且标签仍然成立的变化。样本数量增加只是结果之一。增强轴、强度和组合范围都要由缺陷机制与成像链决定;无论离线指标多好,未被真实数据锚定的增强都可能在部署时制造误判。
增强目标与工业约束
数据增强(data augmentation)是在不改变任务标签的前提下,对原始样本施加受控变换。旋转、缩放、平移、裁剪、亮度变化、加噪和模糊都可以属于增强,但“受控”决定了它是否有工程意义。若变换使正常件看起来像缺陷,或使缺陷的轮廓、位置和类别不再成立,得到的图像就不能作为原标签样本使用。
增强主要解决两个问题。第一,真实缺陷难以大量采集,适度的缺陷区域变形和背景变化可以扩大少数类覆盖。第二,生产中的光照、表面反射、轻微姿态变化和采集噪声会在训练时被提前呈现,模型因此不容易把某一个班次或批次的偶然外观当成缺陷本身。增强改变的是训练分布,不能凭空提供完全没有采集依据的新失效模式。
几何增强还要与任务标注同步。对目标检测,边界框要随图像一起变换;对分割,掩膜轮廓必须经过同样的几何变换;对关键点任务,关键点坐标也要同步更新。若只变换图像而保留旧标注,训练样本会出现标签错位,模型学到的边缘和位置关系会被破坏。
增强还需要区分图像变化和标签变化。分类图像只要类别仍成立,标签可以保持不变;检测、分割和关键点任务的空间标注则必须与图像使用相同的变换矩阵。裁剪可能把缺陷截断,旋转可能让边界框需要重新计算,遮挡还可能把一个完整目标变成部分可见目标。若变换后缺陷已经不满足原来的质量判定,应删除样本或重新标注,不能因为生成过程自动完成就默认标签有效。
增强数据应保存来源图像、增强轴、参数和审核状态。数据来源记录有两个用途:当模型开始依赖合成边缘时,可以定位是哪条增强轴造成了问题;真实数据增加后,也可以删除已经被真实样本覆盖的变体,而不必重新猜测训练集构成。
训练分布是所有增强决策的参照。真实样本可以看作从产线分布中采到的有限观察,增强只是在这些观察周围扩展一个近邻分布。扩展后的样本仍应满足原任务的标签定义,并且变化幅度要落在现场可能出现的范围内。若增强把目标变成了新的缺陷类型,或把原本合格的边界样本推过质量界限,训练集的标签就已经失真。
训练、验证和测试的划分要防止来源相关的泄漏。对于一张真实缺陷图生成的所有变体,应先确定它属于哪一个数据分区,再在训练分区内部生成变体。按文件名随机拆分会把相同缺陷的不同变体分到两侧,模型只需记住缺陷纹理即可取得高分。按工件、批次或时间先拆分,才更接近部署时遇到新工件的情况。
自然场景中的图像可能来自任意视角和背景,工业图像通常来自固定镜头、固定输送方向和相对稳定的工装。产品若总是以同一姿态进入视场,随机旋转 \(180^\circ\) 虽然增加了文件数,却没有增加真实覆盖;更严重时,它会让模型把现场不可能出现的方向当成正常变化。工业增强要先回答“现场什么会变、这种变化怎样改变图像”,再选择变换。
固定光学系统会给增强设置硬边界。相机视角、镜头畸变、工件输送方向和工装共同决定可见外观;随机旋转、任意透视或大幅缩放,只有在现场确实存在对应姿态和距离变化时才有依据。若工件由治具定位,透视变化通常应很小;若输送位置允许偏差,可以按实际定位误差做平移和裁剪。增强范围超过机械和光学容差后,模型会接触到训练中存在、产线中却不可能出现的样本。
每条增强轴都应该能够对应一个现场量。亮度变化可以由参考区域直方图或光源监控锚定,遮挡可以由夹具和工件相对位置决定,模糊可以由输送速度、曝光时间和焦点误差约束。没有现场量或真实图像支持的参数,应保留为实验假设,不能直接写入量产配置。
图 88-1 把增强的来源分成四类:工件与工装造成的几何变化,光照和表面性质造成的变化,缺陷形成机制造成的形态变化,以及传感器和采集链带来的变化。读图时可以从上方四个来源向下追问:这个增强对应哪个现场变量?它是否与当前镜头、光源和输送方向相容?最终目标是覆盖真实变化,样本数量增加只是随之产生的结果。
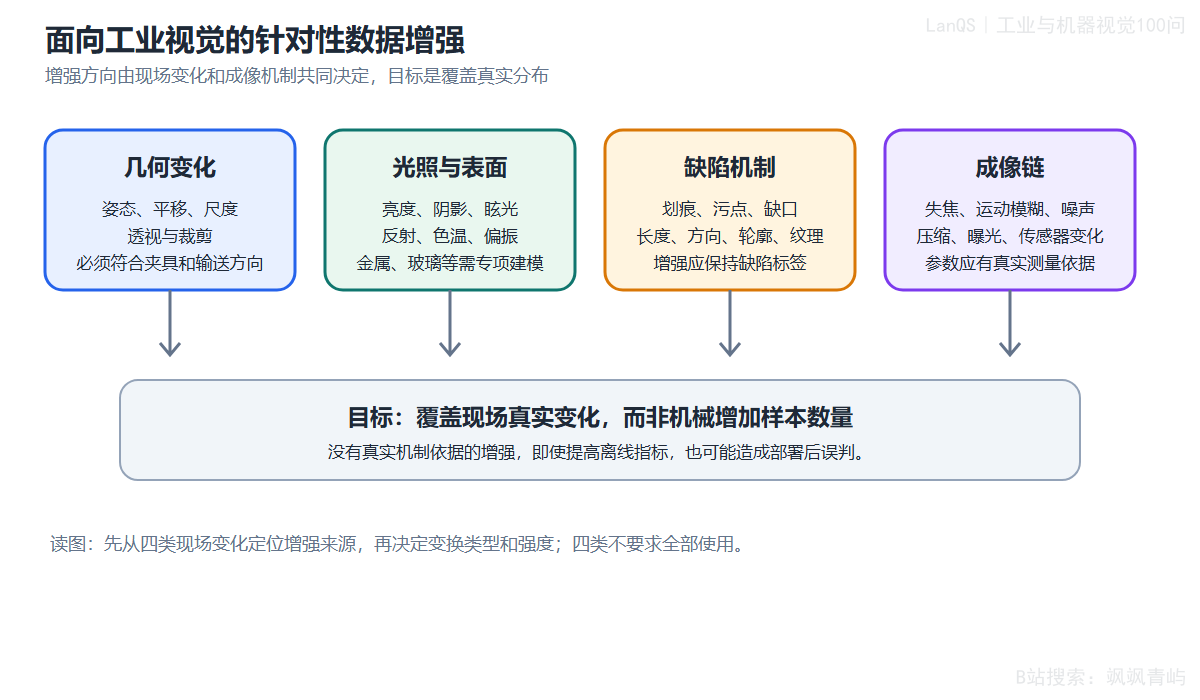
图88-1 工业视觉数据增强的四类针对性来源
物理、形态与跨域增强
类别不平衡是工业检测的常态:正常图像可以在几小时内采集数千张,某类严重缺陷却可能几天都遇不到。最直接的做法是对少数类过采样,并对缺陷区域做局部裁剪、平移、尺度或形态变换。增强应覆盖缺陷实际可能出现的尺寸、位置和形状,重复复制同一个缺陷不能形成这种覆盖。
Cut-Paste 是一种常见的定向方法:先按真实轮廓提取缺陷区域,再把它融合到不同的正常背景中。背景、位置和局部表面可以变化,缺陷本身的边界和类别仍需保持合理。对划痕,可改变长度、方向或局部弯曲;对污渍,可改变面积、边缘软化和强度;对崩边或缺口,则应让缺陷轮廓与工件边界、受力方向和可见区域相容。对于“看起来像缺陷、但按质量规则仍算合格”的边界样本,可增加小幅变化,让模型同时学习判定边界和明显缺陷。
增强后必须重新检查标注、缺陷与背景的接缝,以及训练、验证、测试之间是否发生泄漏。若同一个原始缺陷的近似副本被分到训练集和验证集,验证结果会虚高,因为模型可能记住了缺陷纹理和背景,而没有学会泛化。应按工件、批次或采集时段划分数据,再在训练集内部做增强。
少数类增强的目标是覆盖真实变化范围。即使训练批次中正常与缺陷数量相同,也不代表缺陷子类型、尺寸和表面状态已经均衡;数量平衡和信息覆盖是两个不同问题。
过采样主要改变少数类在训练批次中的出现频率,Cut-Paste 和局部变形才可能增加缺陷的位置、大小或背景变化。两者的作用应分开评估。复制同一张缺陷图会让模型反复看到相同纹理,可能改善训练损失,却不会使模型认识新的缺陷形态;把真实缺陷贴到不同的正常背景上,只有在接缝自然、背景来源可靠时才有机会增加有效覆盖。
边界样本需要单独管理。接近质量上限的轻微划痕、污点或缺口,既不能随意增强成明显缺陷,也不能把仍应判为合格的样本标成不合格。应保留原始判定规则,并对增强后样本重新检查类别、缺陷位置、面积和严重程度。训练、验证、测试还要按真实工件、批次或采集时间先划分,再只在训练侧生成变体。
产线变化常来自光源老化、白班与夜班环境、批次表面粗糙度、局部反射、遮挡阴影和污染。可以针对这些因素改变亮度、对比度、色温、局部高光、阴影、噪声、曝光或轻微模糊。金属、玻璃和涂层工件还需要考虑眩光位置、条带反射和偏振条件变化;简单的全局亮度缩放无法代表这些局部结构。
增强强度的上限取决于缺陷信号。若任务依赖浅色划痕与基底纹理之间很小的灰度差,过强的模糊、亮度或对比度变化会把划痕本身抹掉;若任务依赖几何断口,适度的亮度变化可能影响较小。实际设计前应判断缺陷信息主要由几何、亮度还是纹理承载,再根据现场测量的直方图、眩光面积、噪声水平和曝光范围设置参数上限。
增强是否“像现场”,不能只凭个人观感判断。可以从实际班次、批次和清洁周期中抽取真实图像,与增强图像并排检查;再比较产线已经跟踪的量化指标,例如亮度直方图形状、镜面高光面积和噪声水平,确认两种分布确实有重叠。只凭猜测设定的模糊半径或眩光强度,应在下一次相关批次采样时回到真实数据中验证。
全局亮度变化和局部高光变化应分开建模。全局变化改变整幅图像的亮度或对比度;局部高光则需要改变反射区域的位置、面积、形状和饱和程度。对金属、玻璃和涂层表面,眩光可能遮住缺陷,也可能制造与缺陷相似的亮斑,均匀增加亮度无法复现这种空间关系。色温变化还会改变彩色通道比例,灰度模型应确认这种变化经过相机 ISP(Image Signal Processor,图像信号处理器)后是否仍然与实际图像相符。
现实性验证可以按固定顺序执行:先由熟悉工艺的人判断增强图像是否可能来自产线,再比较亮度直方图、高光面积和噪声水平等量化分布,最后在未增强的跨批次图像上验证模型。肉眼自然但分布不重叠的样本可能误导模型;分布接近但缺陷边缘被抹掉的样本同样不能使用。
缺陷具有空间结构,不能把它当作没有结构的亮点。划痕通常具有方向、长度、宽度和边缘过渡;污渍更接近具有面积和软边界的区域;崩边、缺口或气泡则受到工件轮廓、材料和受力方式约束。增强因此应作用于缺陷及其邻域,而不是只对整张图像做统一变换。
对纹理敏感的任务,可以加入局部对比度变化、频域扰动或噪声纹理叠加,模拟不同批次材料表面。但合成纹理若带有固定的融合边缘、重复背景或不自然的频谱,模型可能把这些伪特征当成缺陷证据。应把合成结果和真实缺陷按位置、边缘软硬、面积、方向及局部纹理进行比较,并用未增强的真实验证集检查模型关注区域是否仍落在缺陷上。
缺陷形态与背景之间存在物理关系。划痕的宽度、长度和方向应与材料表面和加工方向相容;污渍的边缘软化程度应与液体扩散或擦拭痕迹相容;崩边与缺口应落在工件轮廓附近。局部变形若只修改缺陷像素而不改变邻域阴影或反射,边界可能留下合成痕迹。轮廓感知融合需要检查透明度、边缘过渡、背景纹理连续性和缺陷周围的亮度关系。
频域增强改变纹理中不同空间频率的能量分布,可以模拟材料批次差异,却也容易产生相机和表面不会出现的周期纹理。对高频敏感的模型,应比较真实与增强图像的边缘宽度、局部对比度和噪声频谱,避免模型用合成频率代替缺陷本身。
域差异(domain shift)是训练环境与部署环境在设备、光照、背景、表面或工艺上的分布差异。例如实验室图像可能比产线图像干净,工厂 A 与工厂 B 的光源色温不同,白班和夜班的环境光不同。可以通过背景色、噪声模式、压缩质量、轻微失焦和曝光分布的随机化,让训练数据覆盖若干相邻域。
这种做法接近域随机化(domain randomization):它扩大已有样本周围的条件范围,帮助模型减少对单一采集条件的依赖。它不能代替真实的跨工厂、跨批次和跨班次采样。完全没有被采集过的新表面处理、新缺陷类型或新机械故障,无法靠对旧图像做任意扰动获得可靠代表。验证集和测试集应尽量保留未经增强的真实产线图像,特别是那些与训练条件不同的批次。
域适应增强中的“邻近域”必须有实际边界。实验室与产线若只是曝光、压缩和噪声略有不同,可以在这些轴上做随机化;如果两地使用不同镜头、光源几何或材料表面,变化可能已经超过原样本的可推断范围。风格迁移有时会改变背景,却同时改变缺陷边缘和纹理,使用前仍要检查标签与缺陷可见性。
跨域验证应按域保留完整的真实数据。可以把某一批次、某一班次或某一工厂的图像作为独立验证域,禁止其原图及衍生图进入训练。这样得到的结果才能说明模型在不同真实域之间泛化,并排除模型只是记住增强器样式的可能。
当缺陷形成过程和成像结构都比较清楚时,可以把增强做得更接近物理过程。例如,改变照明入射角,移动金属表面的镜面反射区域,加入失焦模糊、运动模糊、景深不足和传感器噪声变化。相比完全随机的图像扰动,这类方法更容易保持镜头、光源、工件表面与图像结构之间的联系。
物理仿真是模型,现场测量用于约束它。仿真的反光方向、模糊尺度、噪声水平和缺陷几何都应由相机、镜头、光源、输送速度和工件材料约束。若参数没有真实量测锚点,就需要在后续相关批次中验证;通过视觉检查但在亮度直方图或高光面积分布上明显偏离真实数据的样本,仍然可能误导模型。
物理仿真应沿成像链检查。先确定缺陷几何如何改变表面法向、纹理或遮挡,再确定光源入射和镜头接收如何把变化映射到图像,最后加入曝光、运动和传感器噪声。参数改变后要检查它影响了哪项可测指标,以及是否同时破坏了其他不应变化的属性。例如增加运动模糊可以降低边缘响应,但不能让静止缺陷的位置随机漂移。
仿真的优点是控制变量,局限是物理模型不完整时会产生有规律的错误。生成样本应与真实图像混合使用,比例由独立验证结果决定;仿真无法覆盖的变化,仍需回到产线采样。
有效覆盖与增强强度算例
下面的算例全部是构造性教学数据,用来说明两个容易混淆的概念。假设小型缺陷集有 \(40\) 张真实图像,包含 \(3\) 个缺陷子类型。对每张图像设置三条定向增强轴:模拟眩光产生 \(3\) 个合理变体,模拟遮挡产生 \(2\) 个变体,模拟表面变化产生 \(3\) 个变体。若暂时假设三条轴完全独立,原图也作为一个有效样本,则组合倍率为
但不同增强轴共享同一张原始图像的几何和缺陷信息,组合数量会重复计算信息。示例用 \(0.35\) 的有效新增比例表示冗余折减,得到有效覆盖倍率:
因此,\(40\) 张真实图像对应的等效覆盖量约为
这里的“等效覆盖量”是对非重复且具有合理变化的估计单位。它不表示数据库中有 \(698\) 张互相独立的真实样本。朴素复制同一批图像时,覆盖倍率仍是 \(1.0\),它只会改变损失函数中这些图像的权重,不会增加现场变化范围。\(0.35\) 也不是通用常数;它需要根据变体之间的相似性、真实覆盖和验证结果重新估计。
增强强度同样存在上限。源代码用一组合成模型表示收益递减和不真实惩罚:强度从 \(0\) 增大时,覆盖收益先上升;超过约 \(1.6\) 的现实性阈值后,惩罚随强度增加,使低对比缺陷信号被逐步削弱。保存的模拟结果在强度 \(0.0,0.3,0.6,1.0,1.4,1.8,2.2,2.6\) 下的召回率分别约为 \(70.7\%,76.7\%,79.3\%,82.0\%,82.1\%,83.6\%,81.9\%,79.9\%\),峰值出现在强度 \(1.8\)。这些数值来自模拟,不能据此把 \(1.8\) 当作通用配置;它们只展示增强可能经历“改善、平台、下降”的形状。
算例代码的两部分含义不同。第一部分把三条增强轴的原图和变体组合相乘,得到完全独立时的组合上限;第二部分用 \(0.35\) 表示组合之间只有一部分带来新的有效变化。代码没有从图像内容自动估计冗余,也没有把真实样本相似度纳入统计,所以 \(17.45\) 是教学估计。第二部分先计算随强度增加而递减的覆盖收益,再在强度超过 \(1.6\) 后加入不真实惩罚,最后叠加随机噪声;保存结果文件供图 88-2 绘制。
右侧曲线的峰值表示这组构造函数的平衡点,并不代表训练过程的通用最优点。实际强度应通过真实验证集、边界缺陷和跨批次数据选择。
图 88-2 左侧比较真实图像、重复复制和折减后的定向增强;右侧沿增强强度读取召回率曲线。读图时先区分“样本数量”与“有效覆盖”,再观察曲线峰值之后的下降段。左侧的 \(698\) 是教学算例的等效量,右侧的峰值是构造的模拟结果,两者都需要真实验证集和现场试运行来确认。
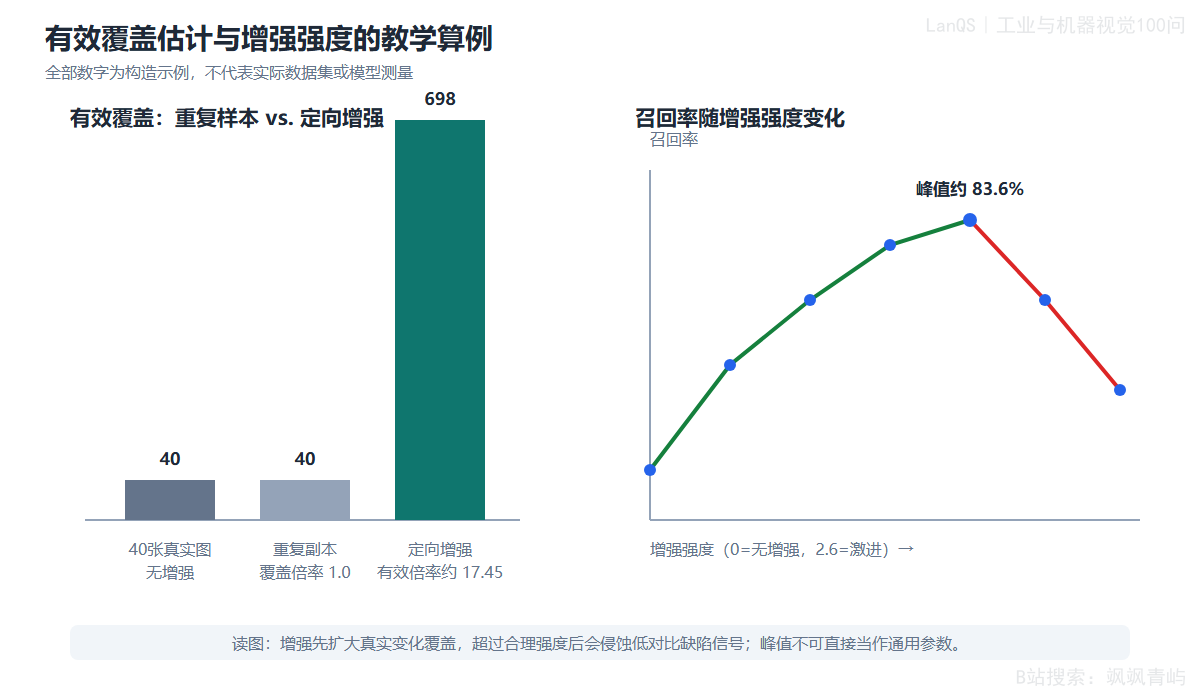
图88-2 有效覆盖倍率与增强强度的教学算例
过度增强有两种不同后果。增强过强会侵蚀低对比缺陷、轮廓或纹理;增强范围没有覆盖某个从未采集过的失效模式,则无论生成多少旧样本变体,都无法替代真实采样。设计时应同时给增强强度和增强范围设置上限。
验证增强是否有效
增强效果不能由训练集准确率单独证明。应固定模型结构、训练轮数、优化器和验证集,只改变增强策略,比较独立验证集、跨批次样本和在线试运行中的召回率、误报率、漏检率、边界样本表现及处理节拍。若训练指标上升而真实验证指标波动变大,增强可能过强,也可能模拟了错误的变化。
还要检查模型关注区域。增强后如果模型开始依赖背景纹理、图像边框或与缺陷无关的高光,短期分数即使上升,也不能作为放行依据。目标是提高对真实变化的泛化,而不是让训练曲线更好看。
要判断四类增强来源中哪一类真正贡献了性能,可以先得到无增强基线和完整增强集两个端点,再做留一轴消融:每次去掉一个增强轴,重新训练并比较验证召回率、误报率和边界样本。若去掉某轴几乎不改变结果,说明它的增益可能很小;若它还显著增加训练时间或数据处理成本,就应重新评估是否保留。Cut-Paste 的轮廓感知融合通常比简单亮度变换更耗时,成本也应纳入比较。
增强价值会随真实数据增长而变化。真实产线已经覆盖某种变化后,原来有用的增强轴可能变得冗余;因此应在数据集、工艺或相机条件变化时重新进行消融,并把增强前后样本按工件、批次和时间隔离,防止相似副本进入验证集和测试集。
消融还要统计工程成本。除了召回率和误报率,还应记录每条增强轴生成的样本量、CPU/GPU 时间、磁盘占用和训练墙钟时间。轮廓感知 Cut-Paste 可能比亮度变换更耗时;如果去掉某轴后验证性能几乎不变,却能缩短数据处理和训练时间,就应重新评估它的保留理由。真实数据增加后应重做消融,因为增强价值取决于数据集中仍缺少什么。
对照实验应固定模型结构、训练轮数、优化器、验证集和评价脚本。若随机种子、初始化或训练预算同时改变,性能差异可能来自训练波动,而非增强本身。在线试运行还要记录处理节拍,确认离线收益没有换来部署侧的不可接受成本。
常见误区
- 在固定姿态的工位随机旋转 \(180^\circ\),把现场不可能出现的方向引入训练分布。
- 对低对比缺陷施加过强亮度、对比度或模糊变化,直接削弱要学习的缺陷信号。
- 只复制同一批图像就宣称覆盖量增加。复制会改变损失权重,覆盖倍率仍为 \(1.0\)。
- 只凭肉眼判断增强真实。视觉上自然的图像仍可能在直方图、高光面积或噪声分布上偏离产线。
- 期待增强生成从未采集过的缺陷类型或新工艺失效模式。
- 几何变换后不更新检测框、掩膜或关键点,造成标签错位。
- 不做留一轴消融,持续增加增强类型,却不检查增益和训练成本。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| 数据增强(data augmentation) | 在标签仍有效的前提下,对原始样本施加受控变换 |
| 针对性增强 | 围绕特定缺陷机制、光学条件或现场变化设计的增强 |
| Cut-Paste | 按真实轮廓提取缺陷并融合到其他正常背景中的增强方法 |
| 域差异(domain shift) | 训练环境与部署环境在设备、光照、背景或工艺上的分布差异 |
| 域随机化(domain randomization) | 在若干相邻采集条件之间扩展训练分布的方法 |
| 消融实验 | 逐项移除一个因素并比较性能,以判断该因素的独立贡献 |
| \(M_{\mathrm{raw}}\) | 假设增强轴完全独立时的原始组合倍率,本算例为 \(48\) |
| \(M_{\mathrm{eff}}\) | 考虑增强轴重叠后的有效覆盖倍率,本算例为 \(17.45\) |
| \(N_{\mathrm{eff}}\) | 以非重复真实变化计的等效覆盖量,本算例约为 \(698\) |
| 召回率 | 所有真实缺陷中被正确检出的比例 |
| 增强强度 | 控制变换幅度或范围的参数;本算例为构造的无量纲坐标 |
延伸阅读
可以继续学习图像数据增强的系统综述、基于真实轮廓的 Cut-Paste 方法、从仿真到真实迁移的域随机化,以及通过消融或自动搜索选择增强策略的研究。阅读这些材料时,应把算法操作与现场成像条件、缺陷形成机制和未增强真实验证集放在一起考察。
第89问 缺陷样本极少、类别严重不平衡时,如何进行分类?
在质量检测线上,正常图像会随着生产持续累积,已确认的缺陷图却可能长期只有个位数。若把所有图像混在一起训练和评价,模型很容易学会“几乎都判为正常”,总体准确率仍然很高,真正需要拦截的缺陷却被漏掉。本题讨论类别严重不平衡(class imbalance)下的分类设计,范围包括数据采样、损失函数、推理阈值、评价指标和现场复核流程。这里的系统约束很明确:缺陷样本稀少,漏检成本通常高于一次误报复核,生产节拍又限制了人工复核量。
核心判断:类别不平衡首先改变了决策目标的权重,随后才表现为样本数量不足。缺陷越少,越要把真实样本的独立性、缺陷代价、复核容量和现场验证放在同一个闭环里设计。
数据、采样与模型路径
设正常类有 \(N_0\) 张图,缺陷类只有 \(N_1\) 张图,且 \(N_0 \gg N_1\)。如果训练损失对每张样本一视同仁,正常样本产生的梯度更新会远多于缺陷样本。模型只要把大部分图像判为正常,就能迅速降低总体损失。极端情况下,它可以一次也不报缺陷,却取得很高的准确率。这个结果说明模型适应了数据的数量结构,不说明它理解了缺陷。
类别不平衡也不等于“数据总量少”。一万张正常图像并不能替代不同缺陷机制、严重程度、材料批次和成像条件的真实样本。若漏掉一件缺陷的代价远高于增加几次人工复核,训练目标和评价指标就必须体现这种不对称。报告一个 99.5% 的准确率,同时不报告漏检数,无法回答系统是否适合放行。
处理问题前先盘点两个量:真实缺陷图数量,以及正常类与缺陷类的比例。缺陷数为零时,监督分类没有真实正类可学,应先采用只用正常图像建模的异常检测。缺陷为个位数到约 20 张时,复制和插值的主要作用可能只是重复已有实例;达到几十张且能覆盖若干机制后,基于真实缺陷区域的增强和监督微调才有较可靠的起点。低百张或更多时,类别权重、损失函数和模型结构调整才有足够真实信号可以利用。这些数量是工程起步区间,不是脱离任务的硬阈值,缺陷多样性和留出集独立性同样重要。
正常与缺陷约为 \(20:1\) 时,类别权重或阈值调整可能已经能改变结果;达到 \(500:1\) 或更极端时,通常需要数据、损失、判定和复核流程一起承担压力。图 89-1 先把这四层关系放在同一张图中,读者可以先看数据比例,再看各层如何补偿这种比例造成的偏置。
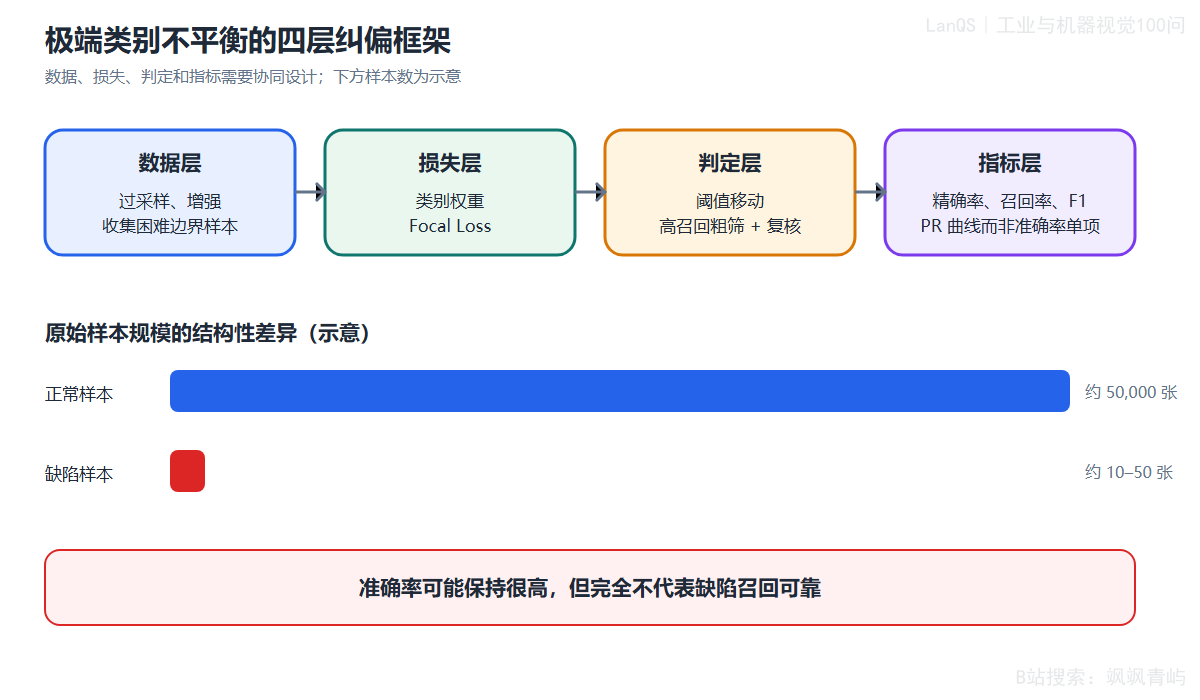
图89-1 极端类别不平衡的四层处理框架
过采样(oversampling)增加少数类在训练过程中的出现频率,可以复制缺陷图,也可以围绕真实缺陷做增强。欠采样(undersampling)则减少多数类样本。复制很多份同一缺陷图不会增加缺陷机制的多样性,还可能让模型记住具体背景和纹理;欠采样过强则会丢掉正常类中的工况变化和判定边界。两种方法改变的是训练数据的呈现比例,不能凭空产生新的真实证据。
数据层的重点应放在覆盖缺陷变化上。增强可以围绕尺寸、严重程度、位置、材料批次和光照条件设计,同时保留能够代表正常边界的正常样本。检测和分割任务还要同步更新边界框或掩膜,不能只改变图像而保留旧标注。现场主动采集的边界样本通常比同一张缺陷图的几十个副本更有价值,例如轻微缺陷、临界规格、不同批次表面和容易与正常纹理混淆的样本。
数据划分必须在增强和过采样之前完成。应先按真实工件、缺陷实例、生产批次或采集日期分出训练集、验证集和测试集,再只在训练集内部生成变体。如果同一缺陷的副本同时进入训练和验证,模型可能记住了该缺陷的背景,验证结果就不能代表遇到新工件时的泛化能力。留出集应保持真实且未经增强,生产数据到达后还要按批次和时间继续检查。
可以用下面的区间做第一次路线判断:
| 真实缺陷图数量 | 适合先验证的路线 | 主要风险 |
|---|---|---|
| 0 | 只用正常图像的无监督异常检测 | 异常分数不能自动说明物理原因 |
| 个位数至约 20 | 少样本相似性方法,配合谨慎的真实区域增强 | 复制或插值放大了同一实例 |
| 几十张至约 50 | 受约束的几何、纹理、Cut-Paste 增强和监督微调 | 增强分布可能偏离真实缺陷 |
| 低百张及以上 | 类别权重、损失函数、阈值和模型结构联合调节 | 指标提升仍可能只来自数据泄漏 |
这个区间还要结合不平衡比例理解。比例为 \(20:1\) 时,保留大部分正常边界并使用类别权重可能足够;比例为 \(500:1\) 时,单独欠采样或单独调阈值都很容易留下新的问题,数据采集和复核流程必须参与设计。
SMOTE(Synthetic Minority Oversampling Technique,合成少数类过采样技术)在少数类样本的特征空间中进行插值,以生成新的少数类点。它在表格数据的连续特征上较常见。直接在图像像素上插值往往会产生不自然的边缘、纹理和光照过渡,因此视觉任务通常更关注中间特征或结构化特征。Borderline-SMOTE 把样本集中在决策边界附近,ADASYN 则倾向于补充较难分类区域。
视觉缺陷具有空间和物理结构。裂纹的方向和连通性、划痕的纹理、缺口与工件边缘的关系,并不会因为两个特征向量相邻就自动成立。特征空间中的插值还可能跨过两个缺陷机制,或者把正常与缺陷的边界混成一个没有物理意义的样本。对于这类任务,基于真实缺陷轮廓的 Cut-Paste、局部物理仿真和受约束的纹理增强通常更容易追溯。
SMOTE 可以作为对照实验,但合成样本必须与真实图像分开管理。它们可以进入训练集,却不能被当作新增的真实缺陷来计算现场覆盖率,也不能让同一真实实例的衍生图像进入留出集。验证重点应是:模型面对新的工件、批次和缺陷机制时,召回率是否提高,误报复核量是否仍在可承受范围内。
类别权重在训练损失中提高少数类错误的相对代价,使模型更重视缺陷样本。阈值移动发生在推理阶段,改变异常分数被转换为“缺陷”或“正常”的分界。二阶段分类先用快速模型筛出疑似样本,再交给更精细的模型复核;集成方法则结合多个模型或多个采样视角,以减少单个模型的偏差。这些手段作用在不同环节,可以组合使用,但都不能补回训练数据从未覆盖的缺陷形态。
降低阈值通常会让更多边界正常样本进入缺陷通道,召回率可能提高,精确率可能下降。这个变化要落到现场数字上:每小时产生多少误报,每次人工复核需要多少秒,二级模型能处理多少图像,生产节拍允许多少等待。一个阈值只有在这些约束下才有意义。类别权重和阈值移动也不是同一件事,前者改变训练过程,后者改变已经训练好的模型在推理阶段的决策分界,二者得到的结果不必相同。
Focal Loss(聚焦损失)是深度学习中常见的重加权方法。普通交叉熵会让大量容易判定的正常样本持续贡献梯度,Focal Loss 则降低容易样本的影响,把训练注意力留给困难样本。其形式为
其中,\(p_t\) 是模型对真实类别的预测概率,取值范围为 \(0\) 到 \(1\);\(\alpha_t\) 是与类别相关的平衡权重;\(\gamma\) 是无量纲的聚焦参数。若 \(p_t\) 接近 \(1\),样本容易分类,\((1-p_t)^\gamma\) 会压低它的损失贡献。增大 \(\gamma\) 会进一步抑制容易样本,但也可能使训练更集中于噪声标注或异常难例,因此参数必须通过独立真实验证集调整。公式说明的是损失如何分配训练权重,不能单独证明召回率一定提高。
缺陷数量仍然决定可走的路线。没有缺陷样本时,可以用 PatchCore、PaDiM、STFPM 或 DRAEM 等方法,只用正常样本学习正常分布。缺陷为 \(1\) 至 \(5\) 张时,可以先用预训练特征做相似性比较,判断新图像是否接近已知缺陷。缺陷达到 \(10\) 至 \(50\) 张时,可把几何变形、纹理合成和 Cut-Paste 与监督微调结合起来。所谓只用正常样本的无监督异常检测,是让模型学习正常分布并寻找偏离;它不能自动告诉工程人员偏离对应哪一种物理原因,也不能替代缺陷类型标注。
Anomalib 是 OpenVINO 生态中的工业异常检测工具库,封装了 PatchCore、PaDiM、STFPM、DRAEM 等方法,并提供统一的训练、推理与 OpenVINO 加速部署接口。OpenVINO 是用于模型推理优化和部署的工具套件,能帮助模型适配目标硬件,但不会改变样本代表性、损失目标或漏检成本。工具可以缩短起步验证时间,不能替代真实采样、阈值评估和人工复核。
指标、阈值与渐进式策略
精确率(precision)回答“被判为缺陷的图像中,有多少确实是缺陷”;召回率(recall)回答“所有真实缺陷中,有多少被检出”;F1 是二者的调和平均。设 TP 为正确检出的缺陷,FP 为被误报为缺陷的正常样本,FN 为漏检的真实缺陷,则
精确率下降通常意味着人工复核量增加,召回率下降意味着放过的缺陷增加。F1 适合用来比较同时关注精确率和召回率的模型,但它没有直接表示停线损失、人工费用或客户风险。PR(Precision-Recall,精确率和召回率)曲线展示不同阈值下两者的变化,混淆矩阵则把 TP、FP、FN 和 TN 的数量拆开。极端不平衡任务还应按缺陷子类、产品变体和生产批次查看召回率,并保留分层结果。
准确率的定义为
其中 TN 是正确判为正常的样本。正常样本占绝大多数时,TN 的数量会掩盖 TP 和 FN 的变化,所以准确率只能作为补充指标,不能单独作为放行依据。
阈值选择算例
为了把这种差异算清楚,下面使用一个可复核的模拟。数据包含 \(2000\) 个正常样本和 \(20\) 个缺陷样本,缺陷比例约为 \(1\%\)。正常分数服从均值 \(0.30\)、标准差 \(0.12\) 的高斯分布,缺陷分数服从均值 \(0.62\)、标准差 \(0.15\) 的高斯分布,分数被限制在 \([0,1]\)。随机种子为 \(42\),正常样本和缺陷样本分别按 \(80\%/20\%\) 分层划分,因此留出测试集包含 \(400\) 个正常样本和 \(4\) 个缺陷样本。
异常分数越高,表示越倾向于判为缺陷。朴素策略在训练集上扫描 \(0.00\) 到 \(1.00\)、步长 \(0.01\) 的阈值,选择总体准确率最高的阈值。成本感知策略扫描相同阈值,但设漏检成本为 \(15\)、误报成本为 \(1\),最小化
这相当于在推理阶段移动决策边界,与类别加权和 Focal Loss 的目标方向相同,但不等价于重新训练模型。
完整计算逻辑可以写成如下伪代码。它保留了源算例的关键条件:固定随机种子、截断分数、分层划分、阈值扫描、混淆矩阵和两种选择准则。
固定 random.seed(42)
生成 2000 个 N(0.30, 0.12) 的正常分数
生成 20 个 N(0.62, 0.15) 的缺陷分数
将每个分数限制到 [0, 1],分别随机打乱正常索引和缺陷索引
每一类按 80%/20% 划分训练集和测试集
对 t = 0.00, 0.01, ..., 1.00:
    预测分数 >= t 的样本为缺陷
    统计 TP、FP、FN、TN
    朴素目标 = 最大化 (TP + TN) / 总样本数
    成本目标 = 最小化 15*FN + 1*FP
在留出测试集上分别计算 P、R、F1、Accuracy
脚本得到的两个训练阶段阈值分别为 \(t=0.70\) 和 \(t=0.62\)。测试集结果如下:
| 策略 | 阈值 | 精确率 | 召回率 | F1 | 准确率 | 测试集 TP / FN |
|---|---|---|---|---|---|---|
| 按总体准确率选择 | 0.70 | 1.00 | 0.25 | 0.40 | 0.993 | 1 / 3 |
| 按漏检成本选择 | 0.62 | 0.60 | 0.75 | 0.67 | 0.993 | 3 / 1 |
表中数值可以从混淆计数复核。按总体准确率选择时,\(P=1/(1+0)=1.00\),\(R=1/(1+3)=0.25\),\(F_1=2\times1.00\times0.25/(1.00+0.25)=0.40\),准确率为 \((1+400)/(1+0+3+400)=401/404\approx0.993\)。按漏检成本选择时,\(P=3/(3+2)=0.60\),\(R=3/(3+1)=0.75\),\(F_1=2\times0.60\times0.75/(0.60+0.75)\approx0.67\),准确率为 \((3+398)/404=401/404\approx0.993\)。这组代入说明,正常样本数量相同且占多数时,准确率可能完全不变,而召回率已经从 \(0.25\) 变为 \(0.75\)。
第一种策略的测试混淆计数为 TP=1、FP=0、FN=3、TN=400;第二种为 TP=3、FP=2、FN=1、TN=398。两者准确率都四舍五入为 \(0.993\),因为测试集中的正常样本占绝大多数。成本感知策略多检出两个缺陷,同时增加两次误报复核。这个算例说明如何读指标,不能证明阈值 \(0.62\) 适用于其他产线,也不能把模拟分数当作真实缺陷分布。
为了读懂图 89-2,先比较两条阈值线穿过正常分数和缺陷分数的区域,再对照下方的 TP、FN、FP 和 TN。阈值从 \(0.70\) 降到 \(0.62\) 后,更多缺陷越过判定线,正常样本中也有更多图像进入复核。两个策略的准确率都为 \(0.993\),恰好说明总体准确率对少数类变化不敏感。
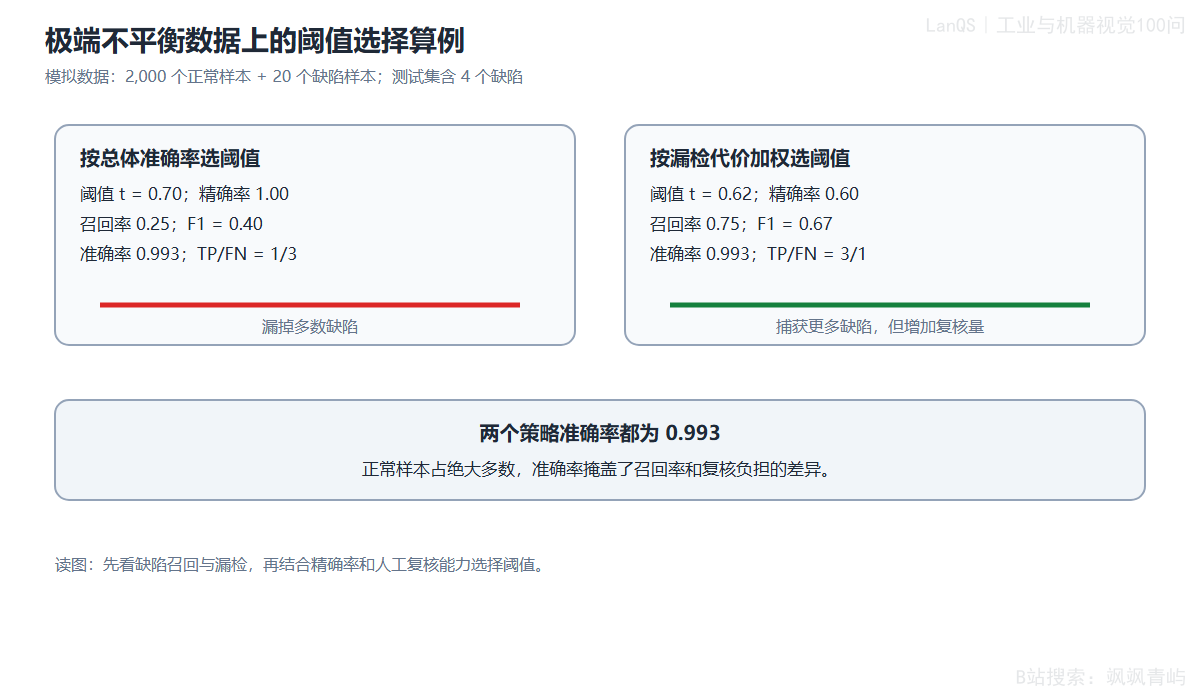
图89-2 极端不平衡数据上的阈值选择算例
极端不平衡很少由一个算法单独解决。较稳妥的路径是让不同层承担不同任务:早期用只需正常样本的异常检测做高召回粗筛,把疑似图像送入人工或二级模型复核;生产中积累的真实缺陷再用于训练监督分类器,逐步区分缺陷子类并减少误报。随着缺陷样本增加,可以重新训练监督模型,也可以按验证结果调整或替换早期粗筛层。
这条路径的关键是形成回流。每个新增缺陷都记录产品、批次、工位、成像条件、缺陷类型和复核结论,经过标注和独立验证后再进入训练集。数据层补充边界样本,训练层使用类别权重或 Focal Loss,推理层设置分级阈值,流程层提供人工复核或二级精度模型。高召回粗筛不等于最终放行判定,复核通道必须有明确容量。若每小时误报量超过人员或二级模型的处理能力,降低阈值就会破坏节拍。
图 89-1 的四层框架可以作为现场回流图来使用:数据层记录新增缺陷和边界正常样本,损失层和采样策略随样本结构调整,判定层按漏检成本重新设阈值,指标层持续记录少数类召回率及误报负担。四层都引用同一批次和同一版本号,才能追溯某次改动到底改变了什么。
自监督表征、对比学习、少样本学习、开放集识别和生成模型扩展,都在尝试减少人工缺陷标注的需求。它们适合研究跨产品复用、批次迁移和冷启动场景,但它们仍受采样质量、标注一致性、成像稳定性和验收标准限制。模型可以更高效地利用已有信息,却不能替代不存在的真实缺陷证据。
验证一个不平衡修复方案时,先按真实且唯一的缺陷实例划分数据,再运行过采样、SMOTE 或图像增强。留出集保持 100% 真实且未经增强,最好来自不同日期、批次或光照条件。至少分别记录内部留出批次和后续真实产线数据的召回率、精确率、F1、PR 曲线及误报负担;每批新确认缺陷到达后重新评估。只看缺陷召回会掩盖正常样本被大量误报的问题,因而还要跟踪多数类精度和人工复核量。
常见误区
- 用总体准确率评价极端不平衡分类,让“全部判正常”的模型看起来可靠。
- 只有几张真实缺陷图时大量复制或使用 SMOTE,把近似副本的验证结果当成泛化能力。
- 先过采样再随机拆分,使同一真实缺陷的衍生图像同时进入训练和验证。
- 使用类别权重或 Focal Loss 后不检查精确率、误报率和复核负担。
- 缺陷数为零时强行训练监督分类器,忽略只用正常样本的异常检测路径。
- 降低阈值提高召回率,却没有安排人工复核、二级模型或节拍预算。
- 把异常分数、插值特征或合成缺陷直接解释为真实物理缺陷。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| 类别不平衡 | 不同类别样本数量差异很大,通常正常类远多于缺陷类 |
| 过采样 / 欠采样 | 增加少数类训练出现次数,或减少多数类训练样本 |
| SMOTE | 在少数类特征点之间插值生成合成样本的方法 |
| Focal Loss | 降低容易分类样本损失贡献、突出困难样本的损失函数 |
| 精确率 \(P\) | 被判为缺陷的样本中真正缺陷的比例 |
| 召回率 \(R\) | 所有真实缺陷中被检出的比例 |
| F1 | 精确率和召回率的调和平均 |
| PR 曲线 | 随阈值变化展示精确率和召回率关系的曲线 |
| OpenVINO | 用于模型推理优化和部署的工具套件 |
| Anomalib | 封装多种工业异常检测算法和部署接口的工具库 |
| PatchCore、PaDiM、STFPM、DRAEM | 工业异常检测方法名称 |
| TP、FP、FN、TN | 真正例、假正例、假负例、真负例 |
| \(p_t\) | 模型对真实类别的预测概率 |
| \(\alpha_t\) | Focal Loss 中的类别平衡权重 |
| \(\gamma\) | 控制容易样本抑制程度的聚焦参数 |
| \(t\) | 将异常分数转换为缺陷或正常判定的阈值 |
延伸阅读
- Lin 等:《Focal Loss for Dense Object Detection》,ICCV 2017。
- Chawla 等:《SMOTE: Synthetic Minority Over-sampling Technique》,Journal of Artificial Intelligence Research,16,321 至 357 页,2002 年。
- Roth 等:《Towards Total Recall in Industrial Anomaly Detection》,CVPR 2022。
- OpenVINO Toolkit 的 Anomalib 公开文档和代码,用于了解工业异常检测模型的训练、推理与部署接口。
第90问 传统算法和深度学习都能解决问题时,如何选择技术路线?
视觉项目开始时,阈值、边缘和连通域可能已经能完成一部分判定,深度学习又可能在复杂纹理上表现更好。现场最终要承担的是漏检、误报、节拍、算力、数据采集和后续维护,路线比较应围绕这些约束展开。本题从任务定义、数据、性能边界、部署环境、调试维护和混合架构几个方面比较路线。系统约束包括目标缺陷的最小尺寸、背景和光照变化、产品姿态、误报与漏检代价、单位产品允许时间以及模型或规则的维护能力。
核心判断:技术路线没有脱离约束的固定排名。稳定且能够写成明确规则的场景,应先验证传统视觉;规则难以穷举、变化持续增加且真实数据充足时,深度学习更值得投入;两边分别擅长不同环节时,应把混合流程作为独立方案进行原型验证。
问题定义与可行性验证
“检测缺陷”这一说法还不足以作为可执行的任务定义。工程人员需要说明目标是亮斑、暗斑、裂纹、边缘破损还是纹理异常,目标与背景的差异主要来自灰度、形状还是纹理,最小缺陷尺寸是多少,产品姿态是否稳定,背景和光照怎样变化,以及产品是否频繁换型。还要记录误报和漏检的相对代价、产线节拍与推理设备位置。没有这些量,路线比较只能停留在偏好层面。
传统算法(traditional computer vision)是把阈值、边缘、连通域、模板匹配或几何约束明确写入图像处理流程。Blob 分析是其中常见的一类,它把二值图或分割图中的相邻像素区域识别为对象,再按面积、形状和位置筛选。深度学习(deep learning)则通过训练网络参数,从样本中学习图像特征和判定边界。两者都在处理图像,区别在于主要由人工写出判定知识,还是由数据训练出判定边界。
任务描述越具体,越容易找到可验证的起点。固定孔位是否存在,可以测量孔区域的面积、圆度和中心位置;织物纹理缺陷可能同时涉及方向、局部纹理和缺陷类别组合,难以用少量阈值穷举。定义时应加入最差光照、容差边界、背景干扰和工件位置误差,不能只拿一张理想图比较算法。
这些条件最好写成验收前的测量表。例如,最小缺陷尺寸要对应到像素或物理长度,姿态变化要记录平移、旋转和高度范围,光照变化要记录图像灰度或照度的范围,节拍要分配给采集、传输、预处理、推理、后处理和通信。误报和漏检也应对应具体动作:误报是否进入人工复核,漏检是否可能造成批量放行。这样,路线选择针对的是一组可复测的约束,不再依赖模糊的“场景复杂”。
传统算法依赖较强的场景先验。当目标与背景的差异稳定,并且能够用阈值、边缘、连通域、模板或几何关系表达时,少量样本也可以支撑一个可解释的方案。它的优势来自约束清楚和调试路径短,并不意味着样本越少就一定更合适。只要现场变化超出规则假设,性能可能快速下降。
深度学习更依赖数据覆盖,适合复杂纹理、模糊边界、姿态变化和多缺陷类别。样本数量、标注一致性和真实工况覆盖必须同时满足。即使图像很多,如果没有覆盖夜班光照、材料批次、边界缺陷和产品变体,模型仍可能只是在训练分布内表现良好。
在承诺大规模开发前,可以并行做两个限时检查。传统路线取 \(20\) 至 \(50\) 张代表性图像,加入最差光照、容差边界和背景干扰,用阈值、边缘或 Blob 流程尝试得到稳定参数。如果同一组参数在困难样本上仍接近要求,这是规则路线的低成本证据。深度学习路线则估算未来 \(4\) 至 \(8\) 周内能够获得多少目标类标注图像,以及每张图的标注成本。缺陷边界越模糊,保持标注一致性越难;一个需要 \(5000\) 张标注图才有优势的模型,如果交付周期内只能获得 \(200\) 张,就不一定是更现实的选择。
比较这两个小型验证暴露出的失败模式和真实数据获取成本,比直接搬用公开基准准确率更有依据。传统概念验证应记录规则在哪些条件下失效,深度学习评估则应记录可获得的数据是否覆盖这些失败条件。
传统概念验证不应只保存最终的合格或不合格结果,还要保存每一步的中间图和参数范围。若阈值在同一批图上可以调到合格,却对光照轻微变化非常敏感,说明规则的稳定性不足。深度学习的早期评估也要按产品变体、批次和困难样本分层,确认高分是否只是由大量容易的正常图贡献出来。两种路线使用同一批困难样本和同一套验收指标,比较才有意义。
性能、部署与生命周期
在背景干净、姿态固定、目标对比度稳定的场景中,传统算法可以提供低延迟、可复现和易解释的判定。工程人员能够依次查看阈值图、边缘图、连通域面积和位置条件,定位是哪一条规则触发了误判。它的边界也很明确:当光照、表面、姿态或缺陷形态超出规则假设时,性能可能突然下降;继续增加规则还可能引入相互冲突的条件。
深度学习面对复杂纹理和多种变化时通常有更高的泛化潜力,但结果依赖训练数据、标注、模型权重和推理阈值。模型对未见过的输入可能安静地给出错误结果,排查需要沿样本分布、标注规则、训练配置和推理环境逐层检查。更高的性能上限伴随着更长的调试路径和更高的数据要求。
比较时应分别查看困难样本召回率、误报率、边界样本表现和节拍。若项目最难承受的是偶发且难解释的错误,规则方法的可追踪性可能更重要;若缺陷变化不断增加,且无法逐条写成规则,深度学习的上限可能更有价值。两种方法只是承担不同的风险:传统方法可能在假设外突然失效,深度学习可能在陌生输入上给出难以追溯的错误。验收条件应明确项目更难承受哪一种失败。
传统算法通常占用较少计算资源,适合工业计算机、边缘设备或功耗受限平台。深度学习常需要 GPU 或专用推理加速器,并且更容易受到驱动、运行时版本、模型格式和内存的影响。产线节拍(takt time)是为满足产量要求,单位产品允许的最大周期时间。若图像传输、预处理、推理和后处理的总时间超过节拍,离线精度优势不能直接转化为产线收益。
部署位置也会改变方案。相机旁的边缘设备可能没有 GPU,中心服务器则要承担网络传输、缓存和断网行为。维护团队不熟悉 AI 运行时,也会使模型升级和故障回退变得更贵。反过来,如果现场具备 GPU,数据管线稳定,模型版本流程成熟,深度学习在复杂任务中的收益更容易落地。
原型阶段就应测量完整链路的平均延迟和尾部延迟、峰值内存、功耗、丢帧或超时行为以及故障恢复。只测模型在开发机上的单次推理时间,不能代替在线系统测试。
节拍预算还要考虑并发和等待。深度模型单次推理时间低于节拍,并不代表多相机同时到图时不会排队;网络部署还要把图像传输和服务重启时间纳入预算。传统流程也可能因大图、复杂模板或异常分支超时。原型验收应使用连续图像流和最差输入,记录 P95 或 P99 延迟、缓存长度和超时后的处理策略。
传统流程的中间结果通常可以按阶段可视化。阈值选错、Blob 面积范围过窄、边缘提取受噪声影响,都能沿着处理链检查。深度学习的调试重点转向数据分布、标注标准、增强策略、模型权重和推理阈值;热力图或注意力图可以提供排查线索,但不能自动证明某个物理缺陷原因。
两类方案都需要版本控制,只是需要保存的对象不同。传统路线至少要固定规则参数、相机和光学条件、软件版本与测试样本;深度学习还要记录训练数据版本、标注版本、增强配置、模型权重、推理运行时和硬件。上线后保存输入图像、模型输出、人工复核、阈值和回退版本,才能判断性能变化来自产品、成像还是软件更新。
路线选择也决定了长期维护由谁承担。如果本地团队可以快速调整规则,却没有重新训练和验证模型的能力,深度学习系统的维护风险可能被低估。如果产品变化频繁,规则参数已经失去可管理性,建立数据和模型生命周期管理又可能比继续堆叠规则更合理。
结构化选择与持续复评
许多项目不需要让一种方法承担整幅图像的全部任务。可以先用传统算法完成 ROI(Region of Interest,感兴趣区域)定位、几何分割、明显正常样本过滤或安全边界检查,再把剩余的疑似区域交给深度学习做复杂分类。也可以先用深度模型判断表面类别,再用几何规则检查尺寸、位置和装配逻辑。
这种流程把能够写清楚的部分交给规则,把难以穷举的部分交给模型。螺钉是否存在、装配位置是否偏移、字符区域在哪里,常可以先通过几何或模板找到。深度模型只处理定位后的困难区域,计算量、误报范围和所需训练数据都有机会减少。
混合方案仍需定义接口和错误传播。第一阶段漏掉目标时,第二阶段无法补救;第一阶段范围过宽,会增加模型负载;坐标系、置信度和异常状态也要统一。验收时应分别测量第一阶段召回率、第二阶段判定性能、级联错误传播和整体节拍。把两种算法串联起来,本身不构成可靠性证明。
一个可执行的接口至少要约定 ROI 坐标相对于哪一幅图、裁剪是否包含边缘余量、第一阶段没有找到目标时输出什么状态,以及第二阶段超时后由谁接管。测试时可以分别构造“第一阶段正确定位、第一阶段误定位、第一阶段漏定位和第二阶段超时”四类输入,检查系统是否产生可追溯的结果。若第一阶段只筛掉明显正常样本,必须测量它是否误删了低对比度缺陷;若第一阶段做几何定位,还要测量定位误差对第二阶段分类的影响。
路线选择可以围绕四个问题推进:目标是否能由稳定规则描述,样本量和变化覆盖是否支持训练,节拍与算力是否允许较重推理,维护团队是否具备相应的生命周期能力。前两个问题明显支持规则时,应先做传统算法概念验证;问题结构复杂且数据条件成熟时,优先做深度学习原型;两边都有优势时,直接比较混合原型通常比继续进行抽象争论更快。
图 90-1 用场景复杂度和数据多样性表示横向变化,用部署与维护成本表示纵向约束,展示三种路线的大致适用区域。读图时要把坐标理解为约束组合,图中的区域不构成固定分界线:左下区域通常具有稳定规则、样本少和算力紧张的条件;右上区域通常具有复杂模式、变化大和数据充分的条件;中间区域值得考察混合流程。
图90-1 传统视觉、深度学习与混合方案的选择矩阵
为了让团队讨论可追踪,可以在数据适配性、准确率上限、可解释性、部署成本和可扩展性等维度评分。候选方案的加权总分定义为
其中,\(w_k\) 是第 \(k\) 个评价维度的重要性权重,满足 \(\sum_{k=1}^{m}w_k=1\);\(s_k\) 是候选方案在该维度上的子评分。若子评分统一采用 \(0\) 到 \(10\),且每个权重非负,则 \(S\) 也在 \(0\) 到 \(10\) 之间。部署成本在本算例中采用反向评分,分数越高表示部署成本越低,避免把“成本高”误读为“得分高”。
公式的作用是把假设写出来,不能将工程判断变成客观裁决。若权重来自印象,子评分没有真实样本、节拍测试或成本估算支撑,\(S\) 只是把原有偏好编码成数字。重新收集数据后应更新子评分,重新计算的结果才有比较意义。
评分维度可以与证据绑定:数据适配性来自真实样本覆盖表,准确率上限来自统一测试集,可解释性来自中间结果和故障定位时间,部署成本收益来自硬件、运行时和维护工时估算,可扩展性来自新增产品或缺陷类别的改造量。若某个维度无法提供证据,应标记为待验证的假设,不宜给出看似精确的高分。
两个场景的加权评分算例
下面使用同一个公式比较两个场景,所有权重和子评分都是教学输入,不代表实际部署测量。五个维度依次为数据适配性、准确率上限、可解释性、部署成本收益和可扩展性。计算逻辑为:
定义 score(weights, sub_scores) = sum(w * s)
检查所有权重之和为 1
场景 A:weights = [0.30, 0.15, 0.20, 0.20, 0.15]
        traditional = [9, 6, 9, 9, 7]
        deep_learning = [3, 7, 4, 3, 6]
场景 B:weights = [0.30, 0.25, 0.10, 0.15, 0.20]
        traditional = [3, 4, 8, 8, 5]
        deep_learning = [9, 9, 5, 5, 8]
分别计算每个方案的加权和并比较
场景 A 是固定孔位检查,样本少于 \(200\) 张,几何关系稳定且规则容易描述。权重为
传统算法子评分为 \(\mathbf s_{\mathrm{trad},A}=(9,6,9,9,7)\),深度学习子评分为 \(\mathbf s_{\mathrm{DL},A}=(3,7,4,3,6)\)。代入公式:
在这组假设下,传统算法得分更高。分数较高来自数据适配、可解释性和部署成本收益,而任务本身又可以由规则描述。这个结果只对应当前输入;如果孔位姿态变得不稳定、样本规模增加,或传统概念验证暴露出复杂纹理问题,子评分就应改变。
场景 B 是织物纹理缺陷分类,标注图像超过 \(2\) 万张,缺陷形态复杂。权重为
传统算法子评分为 \(\mathbf s_{\mathrm{trad},B}=(3,4,8,8,5)\),深度学习子评分为 \(\mathbf s_{\mathrm{DL},B}=(9,9,5,5,8)\)。代入得到
这里深度学习得分更高,原因是复杂纹理提高了性能上限要求,且已有较充足的数据支撑训练。两个场景使用同一个公式,但约束、权重和子评分不同。算例展示的是决策过程的透明性,不能替代真实原型和验收。
图 90-2 把两组输入和计算结果放在一起。读图时先检查每个场景的权重是否加总为 \(1\),再对照五个子评分,最后查看加权总分。若子评分本身没有证据,小数位数并不意味着决策精度更高。
图90-2 加权评分公式在两类场景中的示例结果
规则清楚的亮斑检测、干净背景上的固定孔位检查和标准几何尺寸测量,通常可以从传统算法开始。稳定的光学条件下,阈值和连通域能够直接表达亮度、面积和位置约束,调试路径也较短。原型测试仍需加入光照、位置和材料变化,确认规则边界不会在现场突然失效。
多类别表面缺陷、织物纹理异常、木纹背景变化或焊缝外观分类,更适合优先做深度学习原型,因为模式组合和上下文关系难以逐条写入规则。前提是已有覆盖真实变化的标注数据,并且团队能够承担模型部署、更新和回退。
高速产线上只有少量困难样本时,混合方案常更平衡:规则先完成快速定位和明显正常区域筛选,深度模型再检查低置信度或疑似区域。要确认这条路线成立,必须测量级联后的整体召回率、误报量、节拍和接口异常,而不能只分别引用两个单模块的离线结果。
技术路线是部署时的状态,后续仍需根据缺陷、产品和资源变化重新评估。缺陷种类、产品组合、可用算力和维护团队能力都会变化。持续记录当前系统失败的样本,并按原因、产品、批次、成像条件和缺陷子类型标记。传统系统的漏检率可能暂时不变,但如果面对的缺陷子类型持续增加,规则覆盖范围也可能正在变窄。
当累计获得更多真实缺陷图像,或产品变化使原来的规则难以表达时,应重新执行原评分表,用更新后的数据适配性、准确率上限和维护成本子评分比较路线。触发条件可以在项目初期写明,例如当前规则在连续 \(30\) 天窗口内的漏检率超过约定上限,或累计获得 \(500\) 张以上经确认的缺陷图像。具体数值要由项目验收要求设定,不能在问题出现后临时决定。
重新评估时,在现有传统系统上增加深度学习二阶段检查,通常比整体替换更容易验证和回退。只有混合原型无法满足节拍、维护或精度要求时,才需要讨论整体替换。每次路线变化都应保存新旧版本、测试集、阈值、资源占用和回退办法。
常见误区
- 因为深度学习看起来更先进,就跳过当天可以完成的传统算法概念验证。
- 只比较公开基准或总体准确率,不比较困难样本、漏检、误报、节拍和数据获取成本。
- 把加权评分的结果当作客观裁决,忽略权重和子评分本身也是工程判断。
- 只计算开发期性能,不估算 GPU、驱动、运行时、升级、回退和维护成本。
- 认为混合方案天然可靠,不测试级联接口、第一阶段漏检和错误传播。
- 遇到现场问题后才临时决定何时重新评估技术路线。
- 忽略本地维护团队的模型调试、数据管理和重新训练能力。
术语与符号表
| 术语或符号 | 含义 |
|---|---|
| 传统视觉算法 | 由阈值、边缘、连通域、模板和几何约束等显式规则组成的处理流程 |
| 深度学习 | 通过训练网络参数学习图像特征和判定边界的方法 |
| Blob 分析 | 对二值或分割图像中的连通区域按面积、形状和位置进行识别与测量 |
| ROI | Region of Interest,感兴趣区域;限制处理范围以减少计算量和无关误报 |
| 概念验证(PoC) | 用小规模真实样本和限时实验检验路线能否满足要求 |
| 产线节拍(takt time) | 为满足产量要求,单位产品允许的最大周期时间 |
| 混合/分层流程 | 将传统视觉的定位或筛选与深度学习的复杂判定组合起来的架构 |
| 生命周期管理 | 对数据、规则或模型、部署环境、监控、升级和回退进行长期维护 |
| \(w_k\) | 第 \(k\) 个评价维度的权重,所有权重之和为 \(1\) |
| \(s_k\) | 候选方案在第 \(k\) 个维度上的子评分 |
| \(S\) | 各维度加权后的总分,本算例评分范围为 \(0\) 到 \(10\) |
延伸阅读
- Szeliski:《Computer Vision: Algorithms and Applications》。
- Steger、Ulrich 与 Wiedemann:《Machine Vision Algorithms and Applications》。
- 深度学习模型训练、工业边缘推理、生命周期管理和多指标决策相关资料。